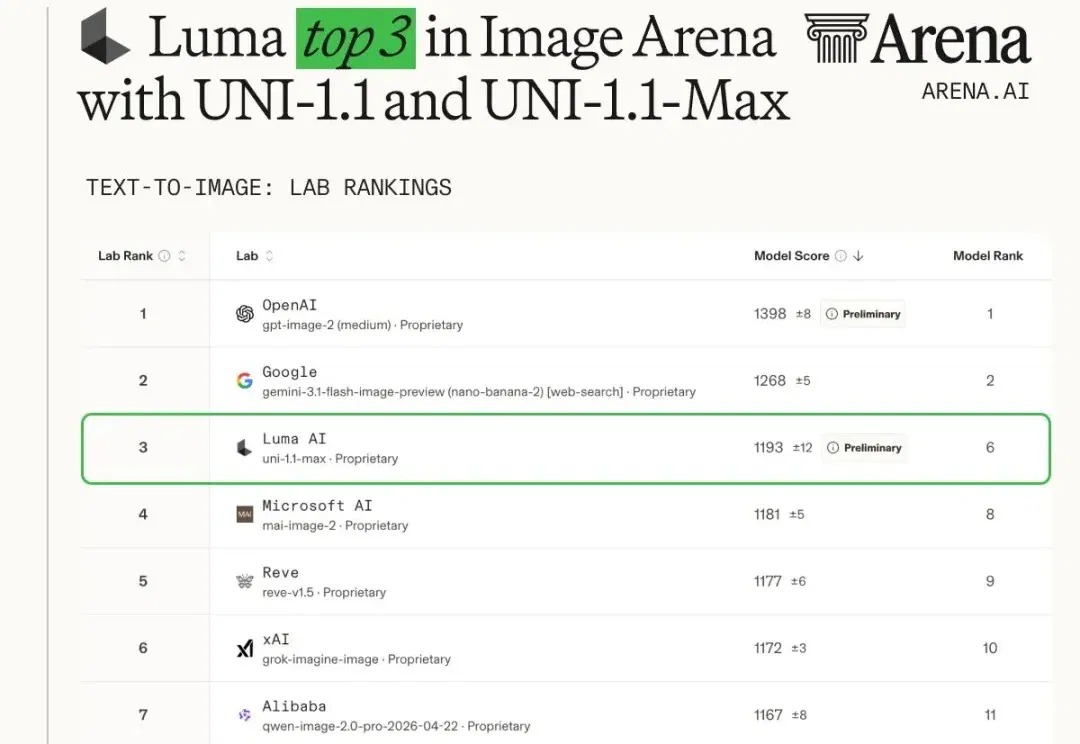
Luma Uni-1.1 API开放,图像模型榜单第三,文字渲染直逼GPT image 2 (opens in a new tab)
今年以来,图像生成模型的迭代节奏明显加快。
Total 21 articles
今年以来,图像生成模型的迭代节奏明显加快。
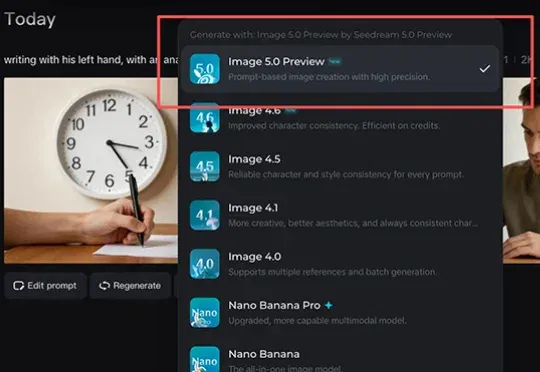
新模型对标Nano Banana Pro,能免费体验。Seedance 2.0的热度还没下去,字节新模型又来了!今日,字节图像生成模型Seedream 5.0 Preview在视频编辑应用剪映、剪映海外版Capcut、字节AI创作平台小云雀均已上线,在即梦AI平台开启灰度测试,图片生成可限时免费体验。
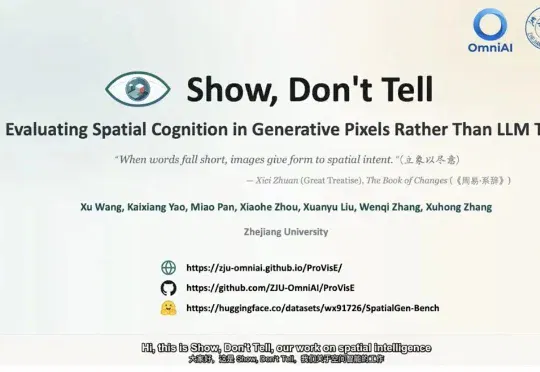
近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。
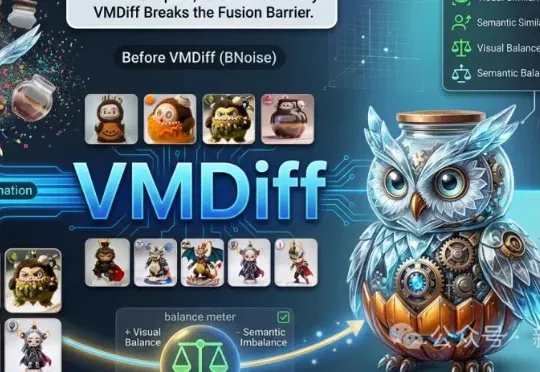
AI不再只是把两个物体「放一起」,而是真正造出一个新实体。VMDiff模型通过分阶段策略:先拼接保留信息,再插值融合成整体,并自动调节平衡,让生成结果既像两者,又自然统一。 过去,很多图像生成模型都能同时画出两个物体;但要让它们真正「长成一个新物体」,其实远没有那么简单。

OpenAI发布新一代图像生成模型ChatGPT Images 2.5,在图片细节质量、生成速度、编辑精度及多轮修改一致性上有所提升,并新增Sketch手绘参考、创作模板和图片评论编辑等功能。
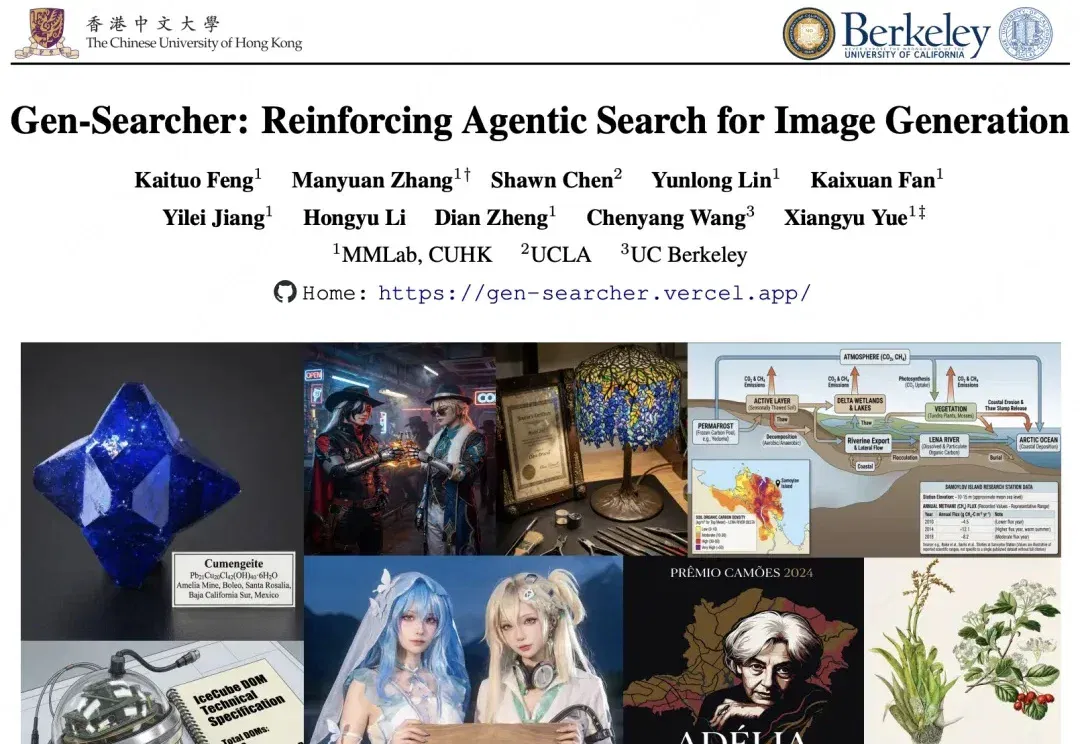
过去两年,图像生成模型在质感和审美上一路狂飙,但大多仍是 “直接出图” 的范式。
今天,首个在国产芯片上完成全程训练的SOTA(最佳水平)多模态模型开源。这是智谱联合华为开源的图像生成模型GLM-Image。从数据到训练的全流程,该模型完全基于昇腾Atlas 800T A2设备和昇思MindSpore AI框架完成构建。
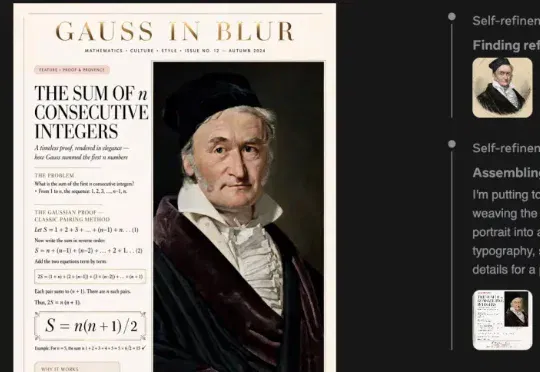
Meta 旗下的超智能实验室 Meta Superintelligence Labs 推出了图像生成模型 Muse Image,并同步预览了 Muse Video。目前,Muse Image 已经接入 Meta AI 应用、网页端以及部分地区的社交平台,Muse Video 也即将向创作者开放。
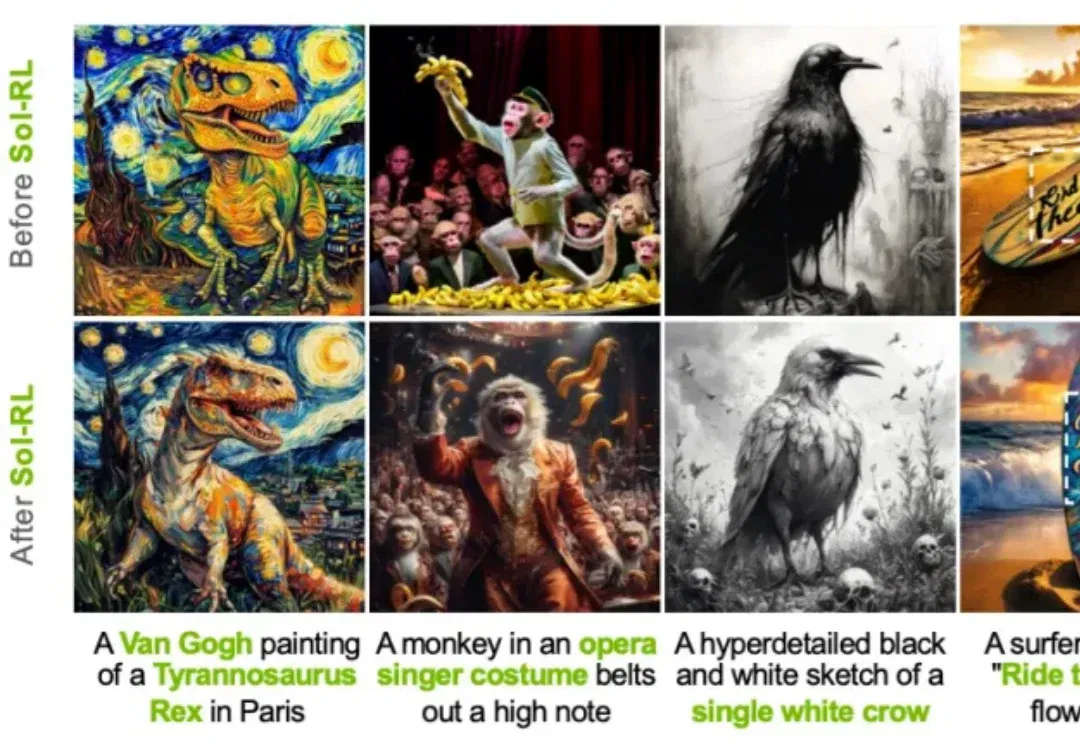
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
图像生成模型正从「会创作」转向「可操作」。