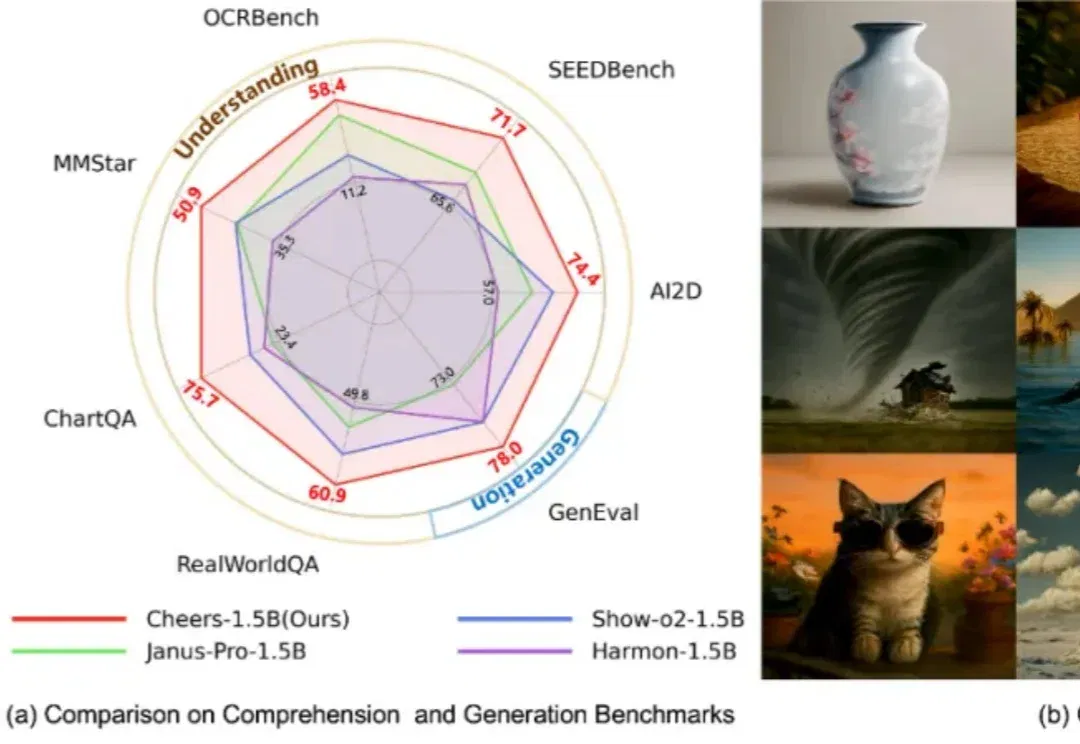
清华、西交联合开源发布了Cheers : 一条更简洁、更高效的统一多模态路线 (opens in a new tab)
过去几年,多模态模型在理解任务上快速演进,图像问答、OCR、视觉推理、跨模态对话等能力不断提升;与此同时,图像生成模型也在视觉质量、指令遵循和细节表达上持续突破。下一步一个自然的问题是:能否用同一个模型,同时做好理解与生成?这正是统一多模态模型(Unified Multimodal Models, UMMs)正在回答的问题。
Total 254 articles
过去几年,多模态模型在理解任务上快速演进,图像问答、OCR、视觉推理、跨模态对话等能力不断提升;与此同时,图像生成模型也在视觉质量、指令遵循和细节表达上持续突破。下一步一个自然的问题是:能否用同一个模型,同时做好理解与生成?这正是统一多模态模型(Unified Multimodal Models, UMMs)正在回答的问题。
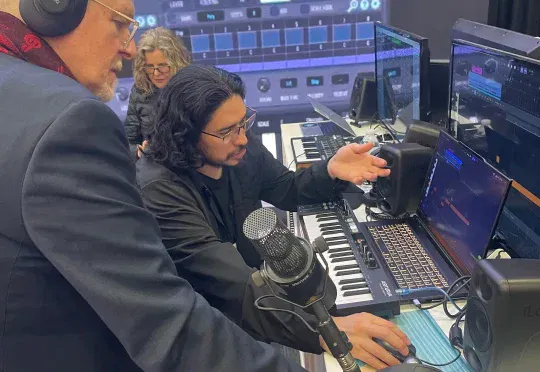
ACE 的起点,并不是把音乐生成做成一个更轻的娱乐玩具,而是从专业创作工作流里切进去。ACE Studio 2.0 于 2025 年 12 月正式发布,产品形态也从 AI vocal workstation 进一步扩展为 all in one AI music studio,开始把 AI 歌声、乐器、生成、编辑与 DAW 协同整合成一个AI 音乐创作系统。
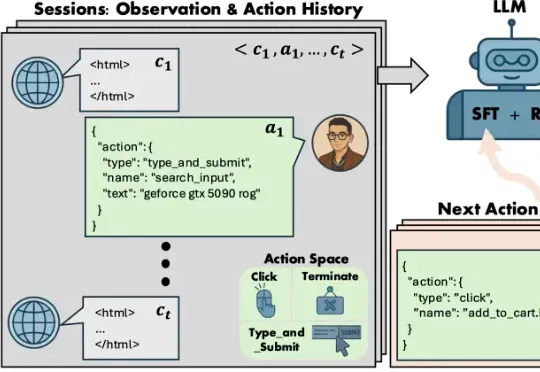
传统的 AI 购物助手更像是一个任务完成机器:接到指令,搜索,下单。他们或许能跑通流程,却完全无法理解用户为何在最后一刻因为一条关于 “夹耳朵” 的差评而放弃支付。简而言之,传统的电商 Agent 只是任务导向的(task-oriented),而不是模拟导向的(simulation-oriented)。为此,来自亚马逊(Amazon)的研究团队提出了名为 Shop-R1 的训练框架 。
Transformer不保?今天,CMU普林斯顿原班人马杀回,新一代开源架构Mamba-3震撼降临。15亿参数战力爆表,性能比Transformer飙升4%。
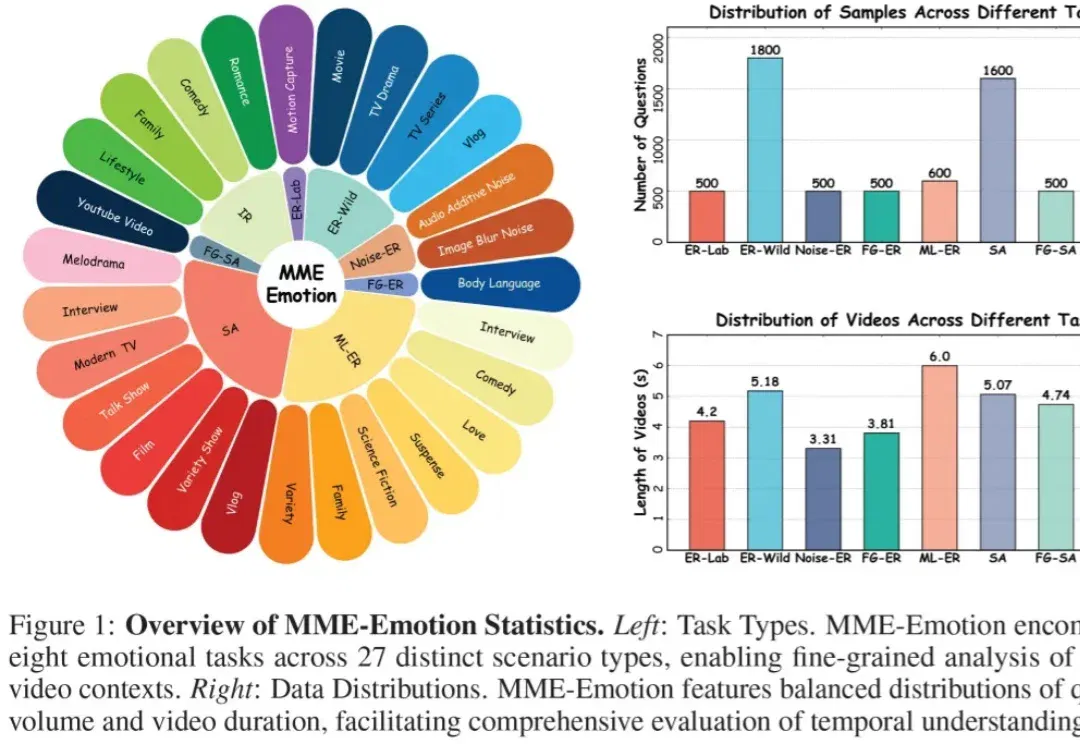
近年来,多模态大模型(Multimodal Large Language Models, MLLMs)正在迅速改变人工智能的能力边界。从图像理解到视频分析,从语音对话到复杂推理,大模型正在逐步具备类似人类的综合感知能力。但一个关键问题仍然没有得到充分回答:这些模型真的能够理解人类情绪吗?
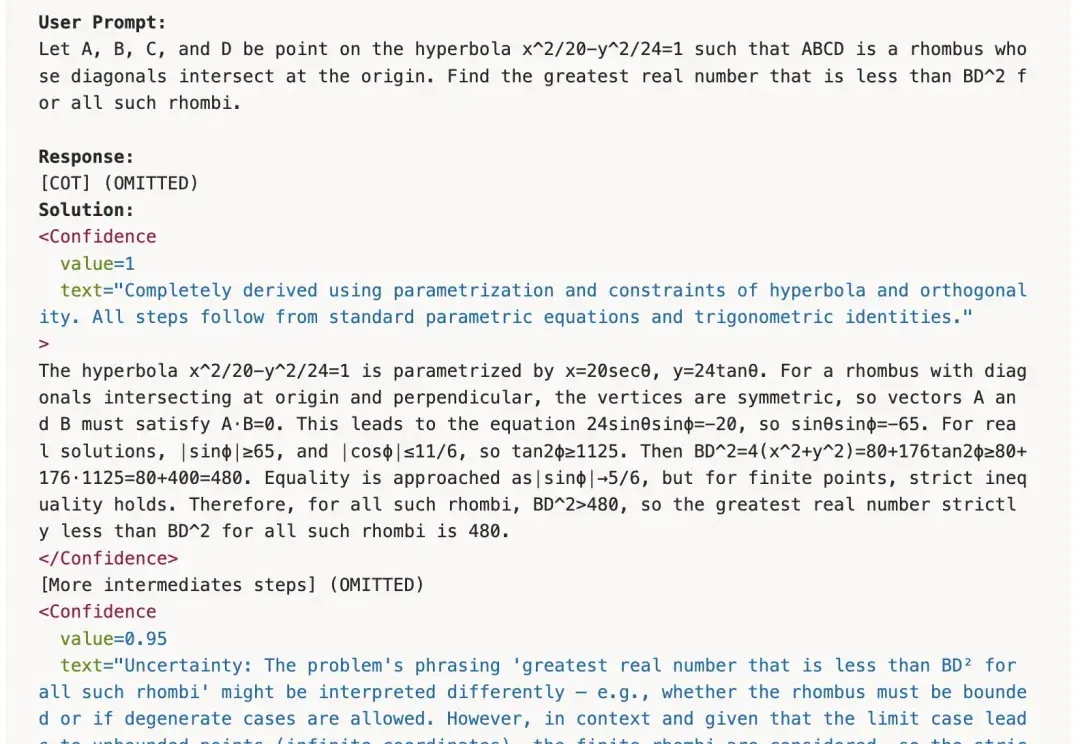
大语言模型(LLM)的幻觉问题一直是阻碍其在关键领域部署的核心难题。近日,研究人员提出了一种名为行为校准强化学习(Behaviorally Calibrated Reinforcement Learning)的新方法,通过重新设计奖励函数,让模型学会「知之为知之,不知为不知」。
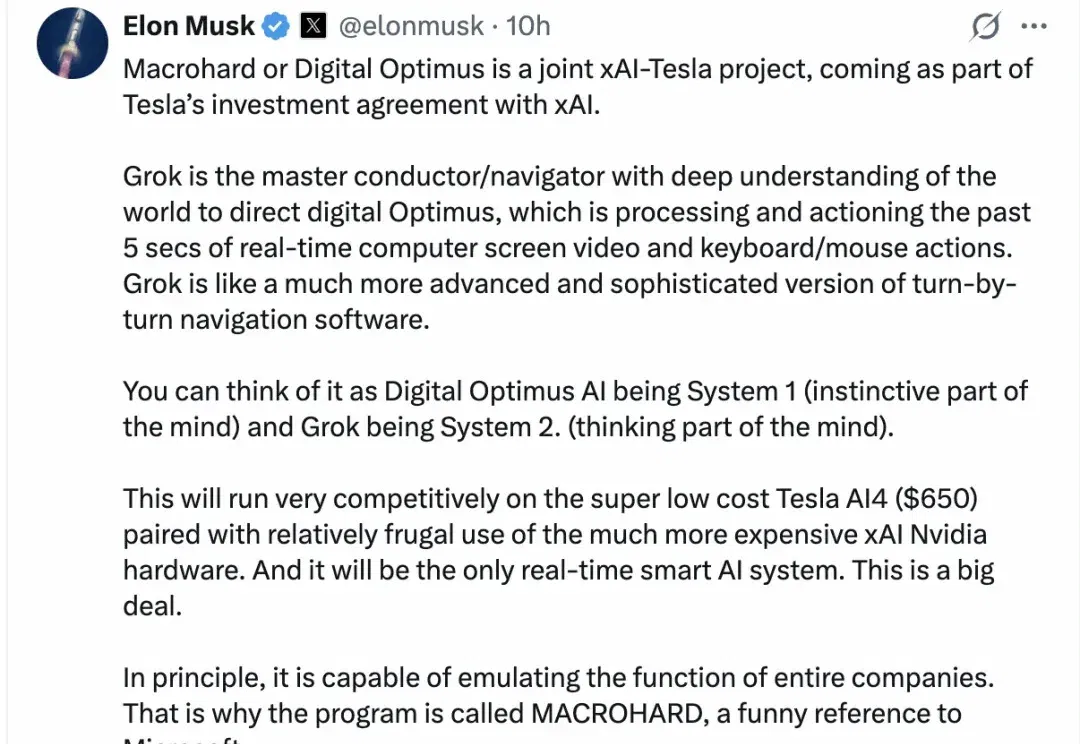
世界首富,也来养“龙虾”了。 刚刚,马斯克在X上宣布了一项“新”的AI项目:数字擎天柱(Digital Optimus)/巨硬(Macrohard)。 顾名思义,与主打现充的擎天柱机器人不同,数字擎天柱主玩网络这一块儿—— 是一个能够在电脑上自动完成操作的AI数字员工。 对于自己的新作品,马斯克还放话说: 从原则上讲,它甚至可以模拟一家完整公司的运作。 主打一个比“一人公司”(one-person company)还要再进一步。 不过问题也来了。 熟悉老马的大伙都知道,“巨硬”这个名字,之前一直是xAI内部的一个项目代号。 怎么现在摇身一变,成了一个AI agent? 难不成…… 这回是真的打
刚刚,谷歌发布了首个原生多模态(Multimodal)嵌入模型——Gemini Embedding 2。这次模型最大的变化在于:把文本、图像、视频、音频和文档,全部映射进同一个统一的嵌入空间。
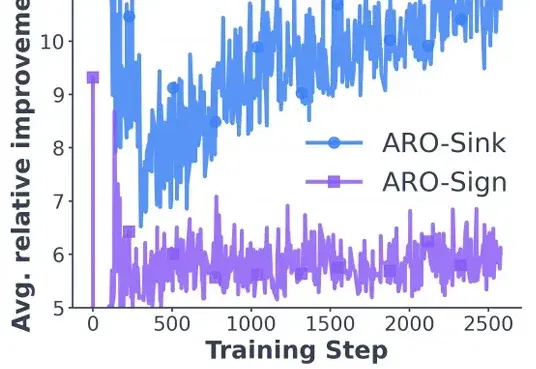
如果你在过去一年关注过大模型训练的技术,大概率听过 Muon 这个名字 —— 这个在月之暗面 K2 模型的相关讨论中走红的优化器,被视为是可能挑战 Adam 的新秀。它的思路很直接:对动量矩阵进行正交化,让各个奇异方向上的更新速率一致,提升训练效率。
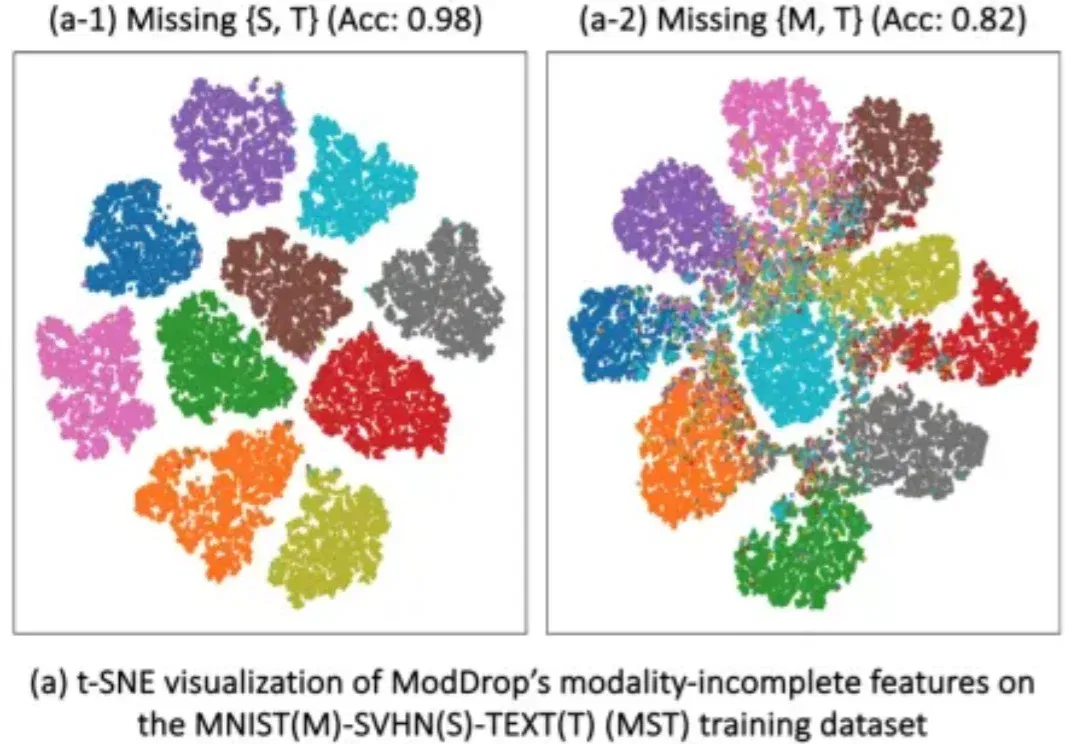
多模态学习(Multimodal Learning)正在推动 AI 在医学影像、自动驾驶、人机交互等领域取得突破。通过融合图像、文本、表格等多种模态,模型能够获得更全面的信息,从而显著提升性能。