一夜反转!「杀进第一梯队」的巴西LLM竟「套壳缝合」了国产模型 (opens in a new tab)
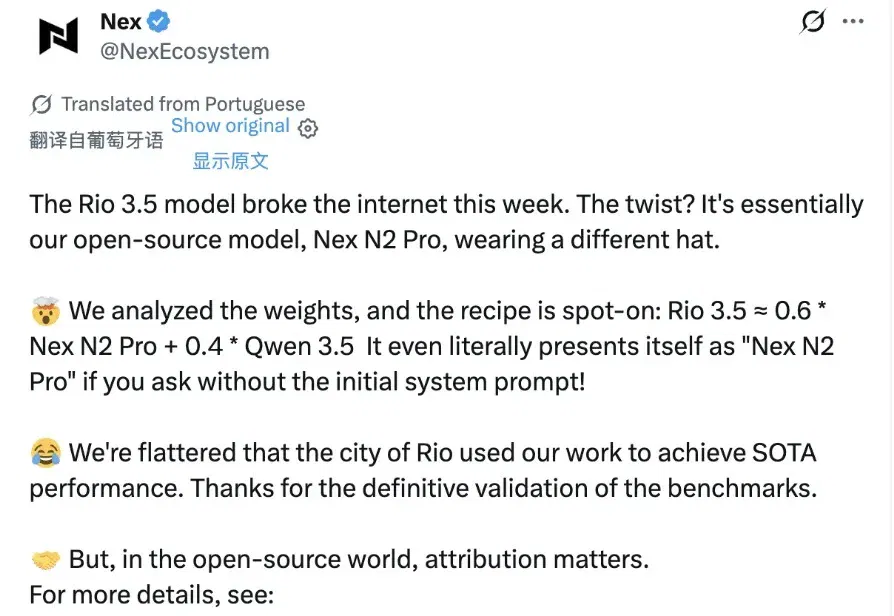
昨天,AI 圈大都被这一新闻「刷屏」:巴西里约热内卢市政府旗下的一家 IT 公司,平地一声雷地推出一款名为「Rio 3.5」397B 的开源模型,甚至还一路逆袭杀进了全球第一梯队,超越 Qwen 3.7 Plus 等开源模型,在多项基准测试中斩获 SOTA 性能。
Total 375 articles
昨天,AI 圈大都被这一新闻「刷屏」:巴西里约热内卢市政府旗下的一家 IT 公司,平地一声雷地推出一款名为「Rio 3.5」397B 的开源模型,甚至还一路逆袭杀进了全球第一梯队,超越 Qwen 3.7 Plus 等开源模型,在多项基准测试中斩获 SOTA 性能。
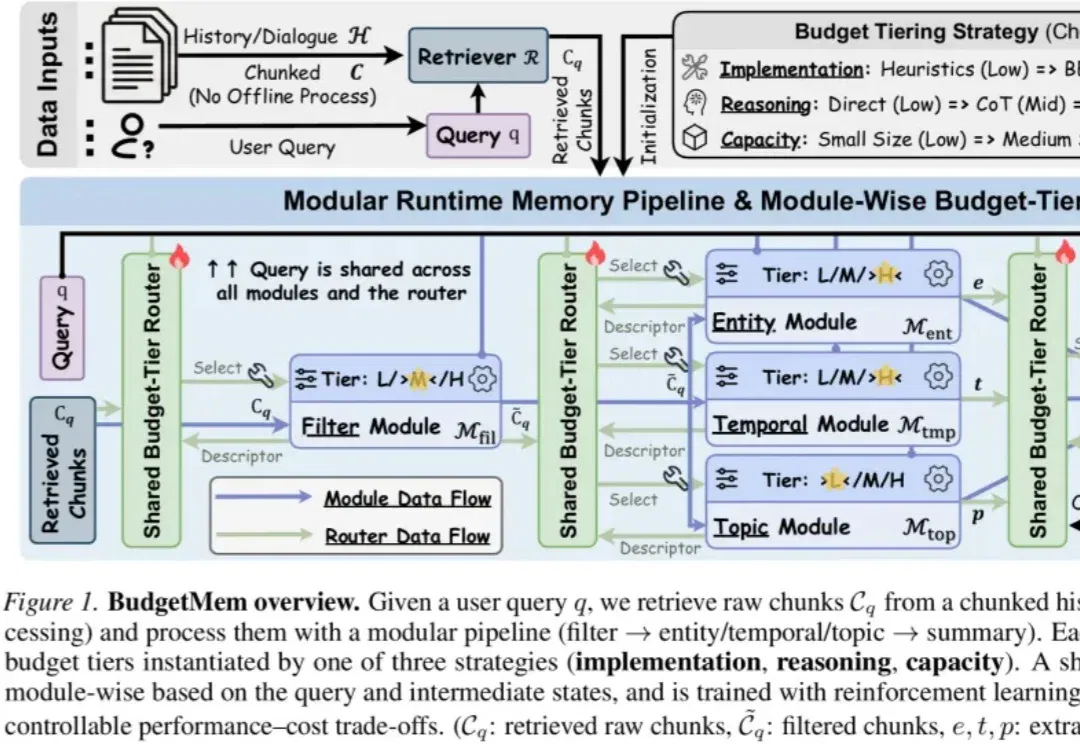
当 LLM Agent 处理长期对话、多轮交互和复杂文档时,Memory 已经成为不可或缺的核心模块。它帮助智能体保存历史、检索信息、维持个性化上下文,并支撑跨时间的推理能力。
近日,Anthropic 发布了一篇引发广泛关注的文章《When AI builds itself》。文中披露了极其惊人的内部数据:截至 2026 年 5 月,Anthropic 超过 80% 的合并代码已由 Claude 编写,工程师的日常代码产出飙升了 8 倍;更令人瞩目的是,AI 智能体已经可以自主提出假设、执行长达数百小时的强化安全实验。
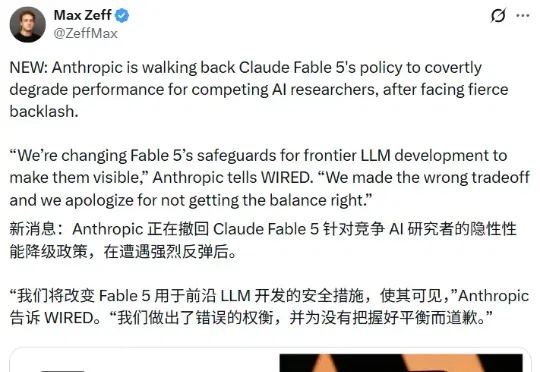
压力之下,刚刚,《连线》记者 Max Zeff 爆料称,Anthropic 正在撤销这一政策。该媒体从 Anthropic 获得了一份声明,其中写到:「我们正在调整 Fable 5 针对前沿 LLM 开发的安全限制,使其变得可见。」
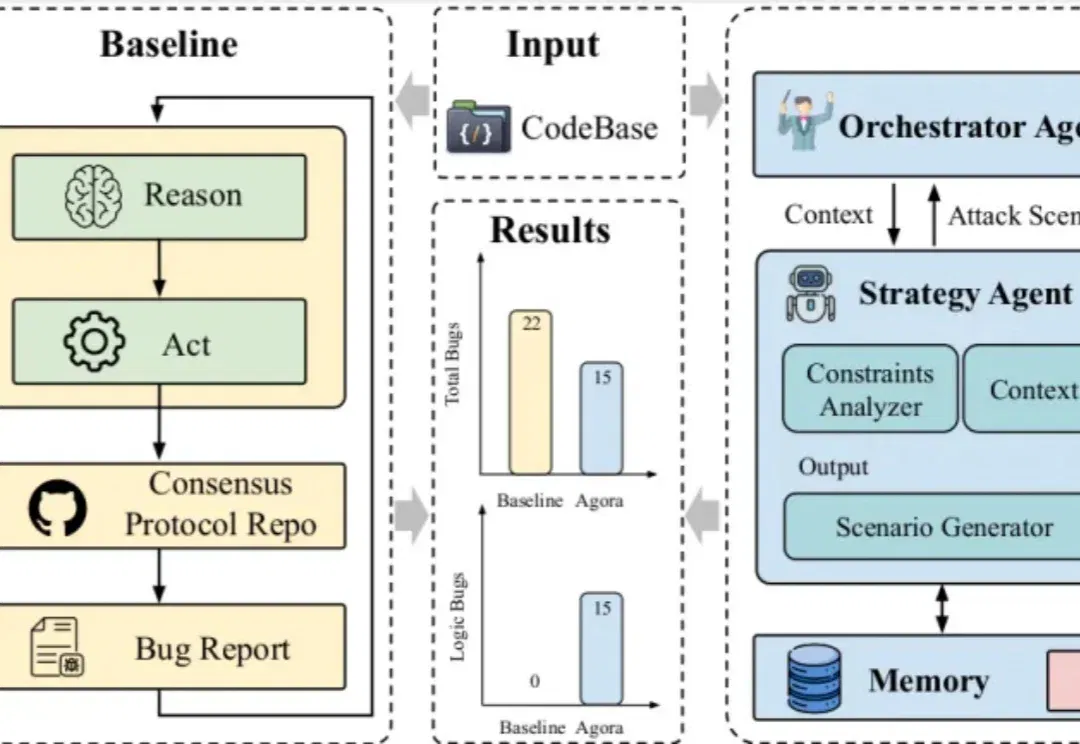
分布式系统的 “圣杯”—— 共识协议(Consensus Protocols),长久以来都是顶级基础设施工程师的 “Bug 地狱”。由于其状态极其复杂、多节点交织,传统测试和单体 LLM 对硬核的 Deep Bug(深层逻辑漏洞)几乎束手无策。
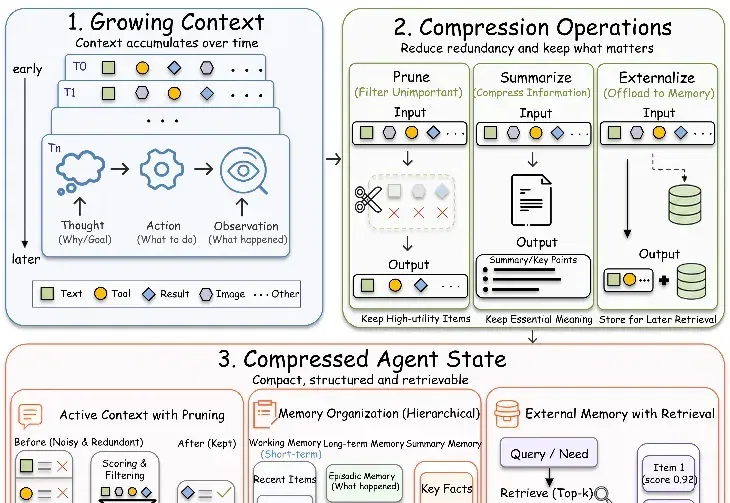
LLM Agent 做长任务时,真正让人头疼的往往不是模型不会推理,而是上下文开始失控:前几步还很清楚,后面就忘约束、丢状态、重复试错,最后把任务跑成事故现场。
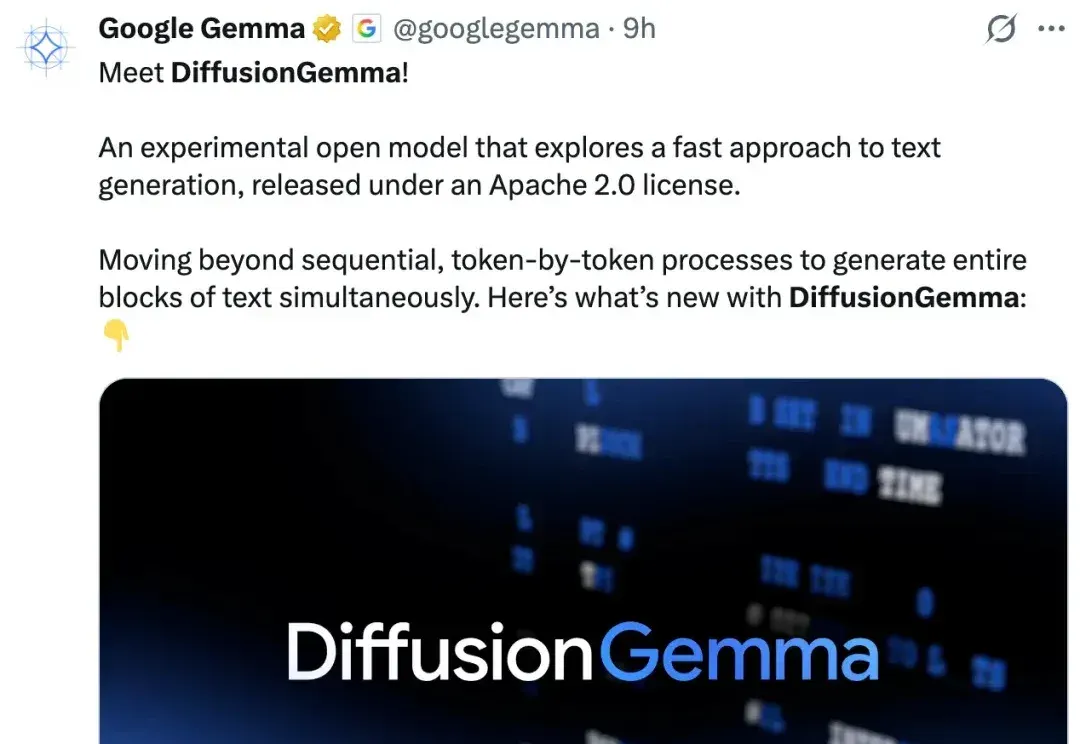
今天一早,谷歌又发新模型了! Gemmna 家族有了新成员 ——DiffusionGemma,一个探索文本扩散的实验性开源模型,在文本生成任务上速度极快。 根据官方介绍,DiffusionGemma 采用了 Apache 2.0 许可证发布,是一个 26B 规模的混合专家模型(MoE)。 该模型没有沿用典型自回归大语言模型(LLM)那种按顺序、逐 token 生成的方式,而是可以同时生成整块文本,在 GPU 上,文本生成速度最高可提升至 4 倍。 DiffusionGemma 建立在 Gemma 4 家族业界领先的「每参数智能水平」之上,同时吸收了 Gemini Diffusion 的前沿研究
还在手动在不同工具间来回切换查文献、跑代码、看结果?两个月前发起内侧的科研龙虾SciClaw,经过上万名科研人的「考核」,正式升级为Mira,推出专家小队、科研画布、LLM WIKI 三大核心能力,首次将「Vibe Researching」理念产品化,让研究者像组建实验室团队一样配置 AI,把时间还给真正的科学思考。
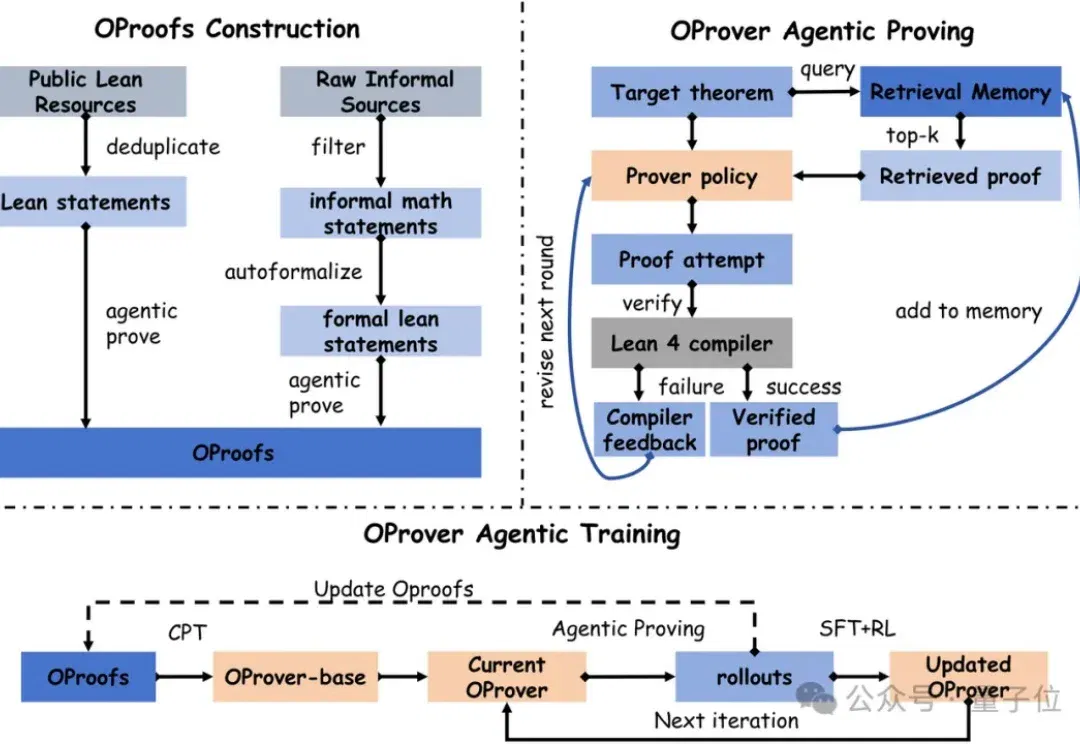
形式化定理证明,一直是LLM公认最严苛的推理试金石,每一步推导都必须通过Lean 4内核的机器验证。
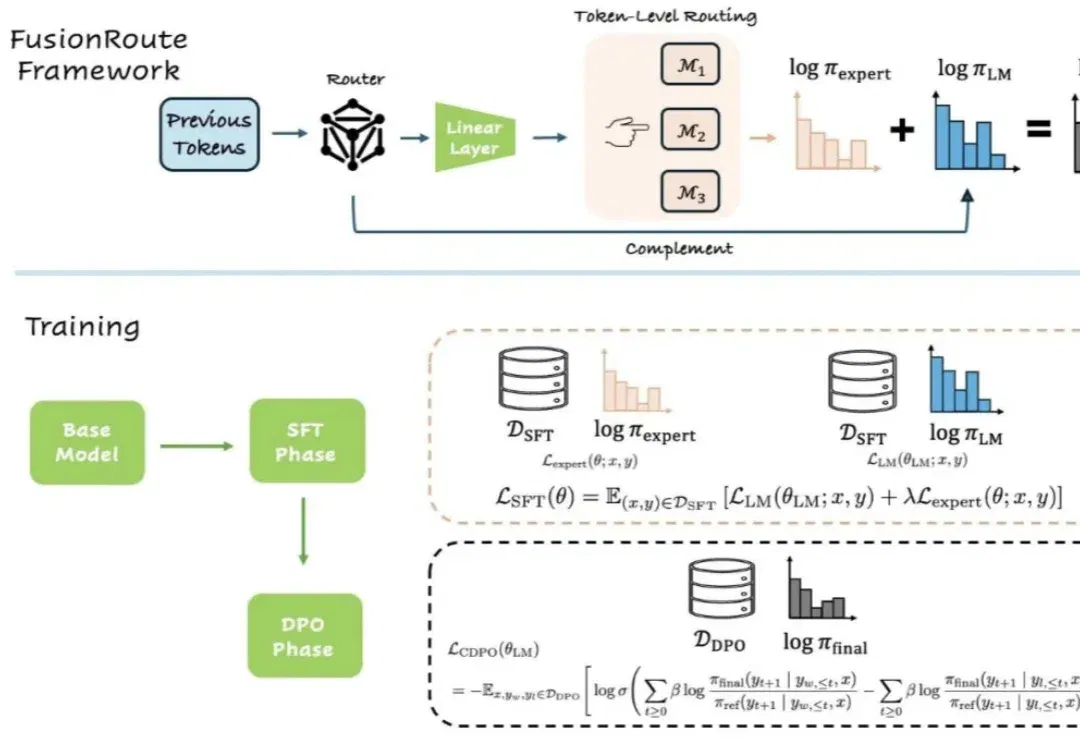
近年来,大语言模型能力的提升,已不再仅仅依赖于更大的模型规模或更多的训练数据。越来越多的研究开始探索另一条路径:通过多个专家模型的协作来完成生成任务。