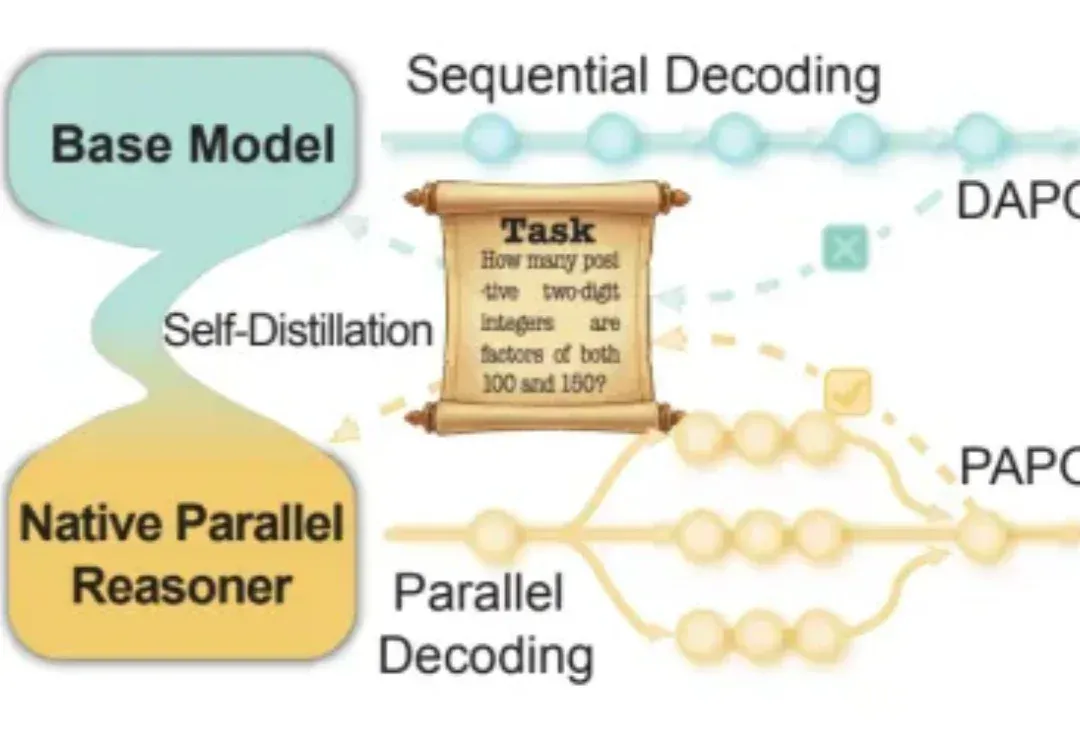
告别「单线程」思维:通研院提出NPR框架,让智能体进化出原生的并行推理大脑 (opens in a new tab)
近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。
Total 194 articles
近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。
多模态大语言模型(MLLMs)已成为AI视觉理解的核心引擎,但其在真实世界视觉退化(模糊、噪声、遮挡等)下的性能崩溃,始终是制约产业落地的致命瓶颈。
有关大语言模型的理论基础,可能要出现一些改变了。
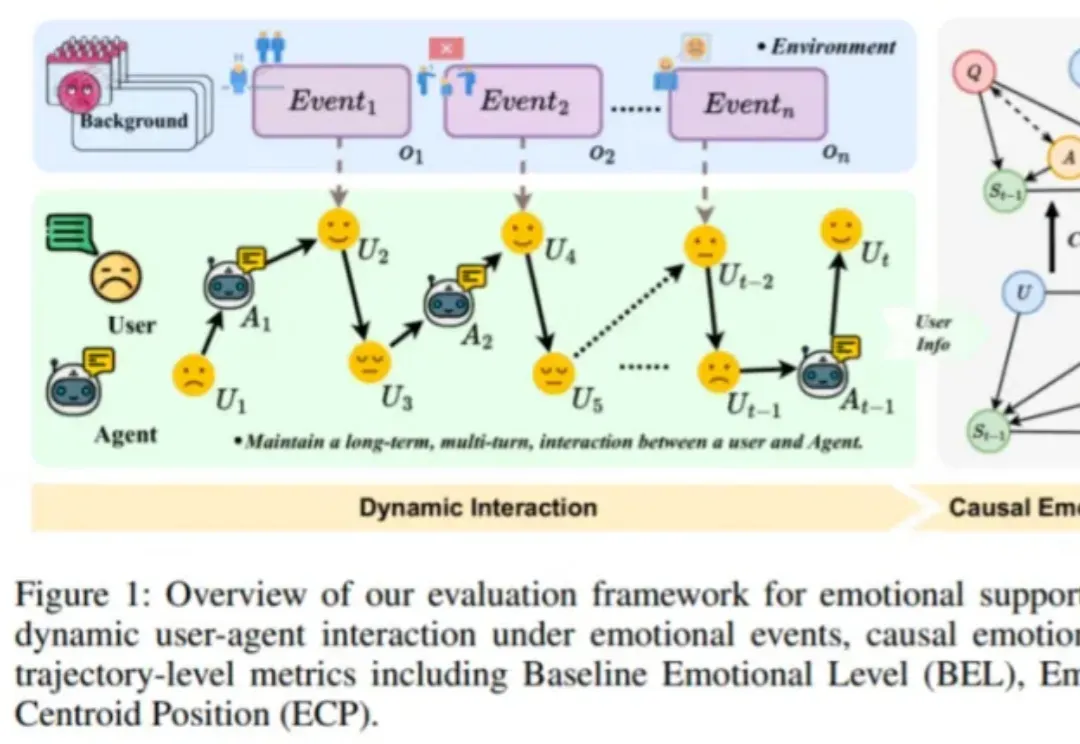
近日,由趣丸科技与北京大学软件工程国家工程研究中心共同发表的《Detecting Emotional Dynamic Trajectories: An Evaluation Framework for Emotional Support in Language Models(检测情感动态轨迹:大语言模型情感支持的评估框架)》论文,获 AAAI 2026 录用。
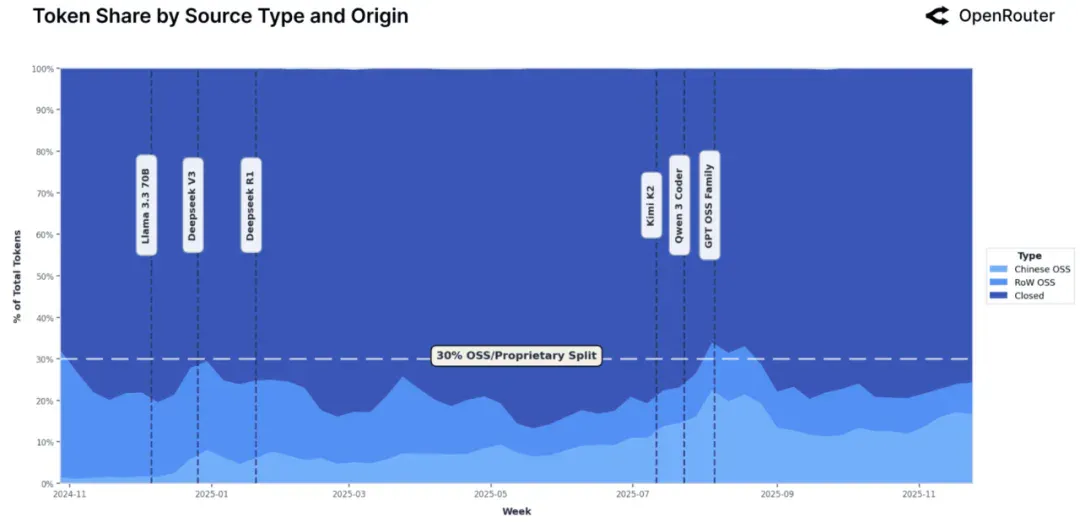
2025 年 12 月,硅谷风险投资机构 Andreessen Horowitz(简称 a16z)与 AI 推理服务平台 OpenRouter 联合发布了一份名为《State of AI》的研究报告。这份报告基于 OpenRouter 平台上超过 100 万亿 token 的真实用户交互数据,试图呈现过去一年间大语言模型在实际应用中的真实状态。
斯坦福和MIT的研究团队推出了一种新的AI智能体推理框架ReCAP,在长上下文任务中全面超越了现有的主流框架ReAct,性能提升显著。ReCAP通过独特的递归树结构和三大机制,解决了大语言模型在复杂任务中常见的目标漂移、上下文断层和成本爆炸等问题。
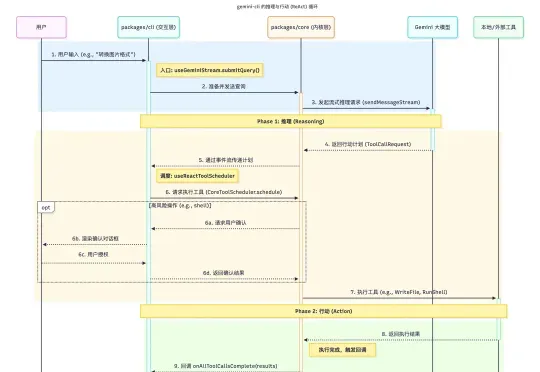
随着大语言模型与开发工具链的深度融合,命令行终端正被重塑为开发者的AI协作界面。本文以 Google gemini-cli 为范本,通过源码解构,系统性分析其 Agent 内核、ReAct 工作流、工具调用与上下文管理等核心模块的实现原理。为希望构建终端 Agent 的开发者,提供工程实现的系统化参考。
近日,OpenAI被曝正面临越发增长的推理费用,作为有史以来最能烧钱的初创公司,其运行大语言模型的成本可能无法通过收入来支撑。
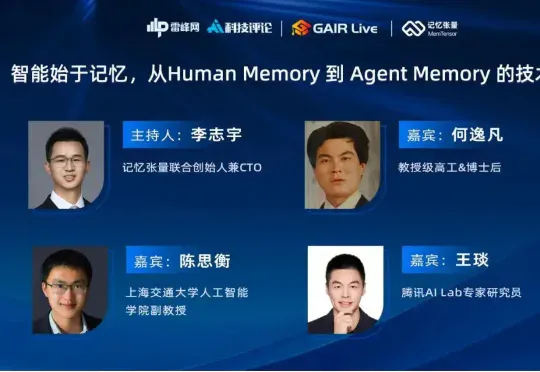
人工智能在过去的十年中,以惊人的速度革新了信息处理和内容生成的方式。然而,无论是大语言模型(LLM)本体,还是基于检索增强生成(RAG)的系统,在实际应用中都暴露出了一个深层的局限性:缺乏跨越时间的、可演化的、个性化的“记忆”。它们擅长瞬时推理,却难以实现持续积累经验、反思历史、乃至真正像人一样成长的目标。
11 月 2 日,英伟达首次把 H100 GPU 送入了太空。作为目前 AI 领域的主力训练芯片,H100 配备 80GB 内存,其性能是此前任何一台进入太空的计算机的上百倍。在轨道上,它将测试一系列人工智能处理应用,包括分析地球观测图像和运行谷歌的大语言模型(LLM)。