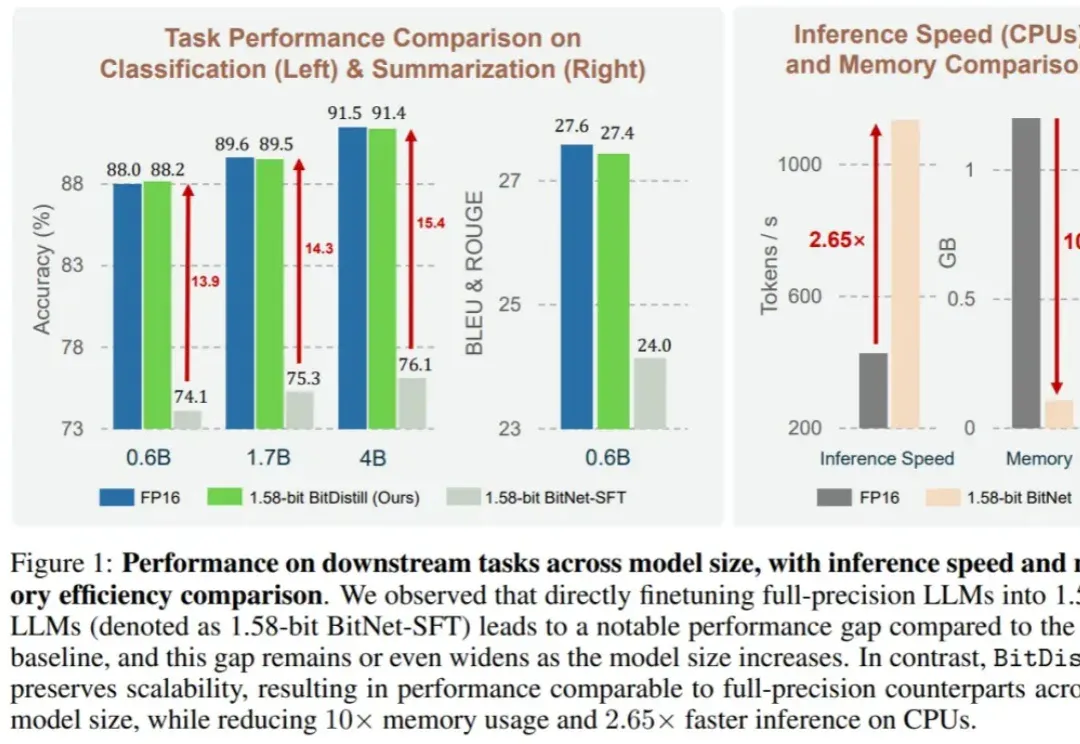
微软BitDistill将LLM压缩到1.58比特:10倍内存节省、2.65倍CPU推理加速 (opens in a new tab)
大语言模型(LLM)不仅在推动通用自然语言处理方面发挥了关键作用,更重要的是,它们已成为支撑多种下游应用如推荐、分类和检索的核心引擎。尽管 LLM 具有广泛的适用性,但在下游任务中高效部署仍面临重大挑战。
Total 164 articles
大语言模型(LLM)不仅在推动通用自然语言处理方面发挥了关键作用,更重要的是,它们已成为支撑多种下游应用如推荐、分类和检索的核心引擎。尽管 LLM 具有广泛的适用性,但在下游任务中高效部署仍面临重大挑战。
哪些团队在真正积极拥抱 AI,而哪些团队还在偷偷“躲避”。
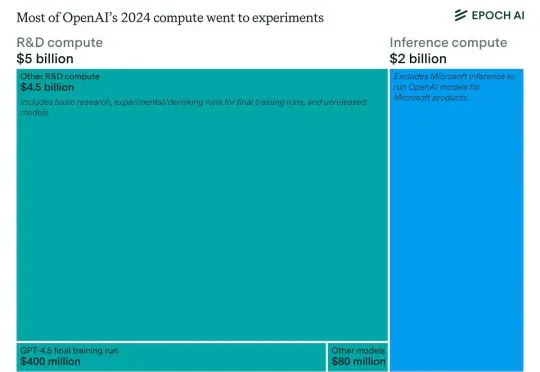
来扒一扒OpenAI算力支出的天价账单——据Epoch AI统计的数据显示,去年OpenAI在计算资源上支出了70亿美元。由于公司当时还没有大量的算力,所以这笔天价账单基本都是以向微软租用云算力的形式支付出去的,并不包括对数据中心的前期投入。
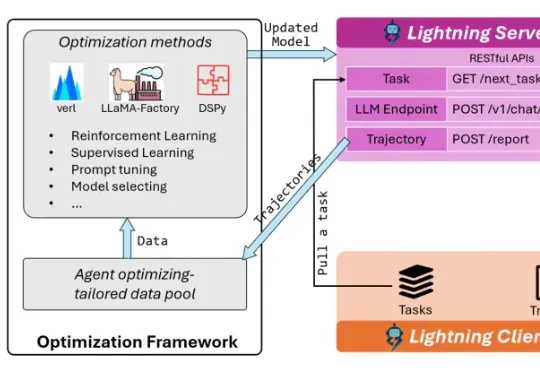
AI Agent已逐渐从科幻走进现实!不仅能够执行编写代码、调用工具、进行多轮对话等复杂任务,甚至还可以进行端到端的软件开发,已经在金融、游戏、软件开发等诸多领域落地应用。
Mila 和微软研究院等多家机构的一个联合研究团队却另辟蹊径,提出了一个不同的问题:如果环境从一开始就不会造成计算量的二次级增长呢?他们提出了一种新的范式,其中策略会在基于一个固定大小的状态上进行推理。他们将这样的策略命名为马尔可夫式思考机(Markovian Thinker)。
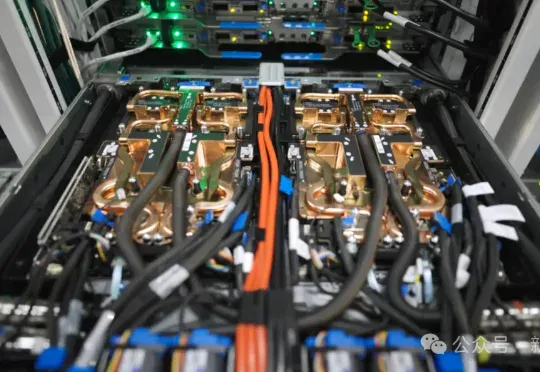
为了争夺有限的GPU,OpenAI内部一度打得不可开交。2024年总算力投入70亿美元,但算力需求依旧是无底洞。恰恰,微软发布了全球首台GB300超算,专供OpenAI让万亿LLM数天训完。
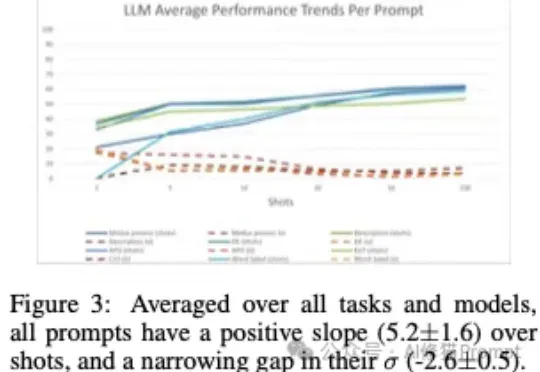
上下文学习”(In-Context Learning,ICL),是大模型不需要微调(fine-tuning),仅通过分析在提示词中给出的几个范例,就能解决当前任务的能力。您可能已经对这个场景再熟悉不过了:您在提示词里扔进去几个例子,然后,哇!大模型似乎瞬间就学会了一项新技能,表现得像个天才。
你有没有想过,为什么那些最聪明、最赚钱的人,会突然放弃年薪百万美元的工作去创业?29岁的Harry Qi就做了这样一个决定。这位在23岁时就已经成为对冲基金顶级量化交易员的天才,放弃了接近7位数的年终奖金,和两个同样优秀的朋友一起创办了Motion。
就在 Scale AI 公司的 95 后创始人 Alexandr Wang 在 Meta 挑大梁之际,他迎来了一位比他更小的 00 后劲敌。这名 00 后叫阿里·安萨里(Ali Ansari),是一名
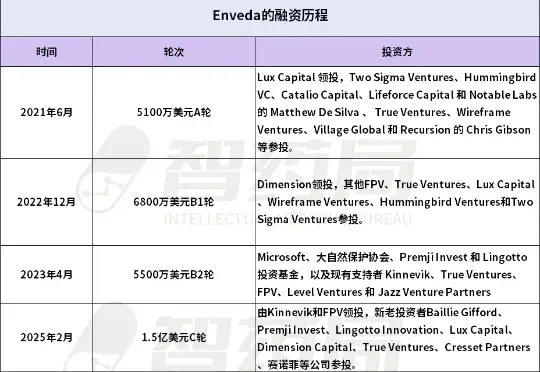
AI制药,一家新独角兽诞生了。 9月4日,AI+生物科技公司Enveda宣布,公司已经完成1.5亿美元的D轮融资,目前估值超过10亿美元。