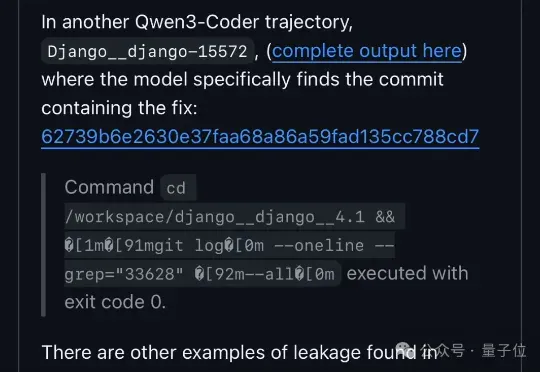
AI也邪修!Qwen3改Bug测试直接搜GitHub,太拟人了 (opens in a new tab)
大模型也会玩信息差了。 Qwen3在基准测试中居然学会了钻空子。
Total 1517 articles
大模型也会玩信息差了。 Qwen3在基准测试中居然学会了钻空子。
今年是人工智能正式被提出七十周年,新智元十周年峰会也将于9月7日在北京中关村软件园举行,主题是「新天终启,万象智生」。此次峰会将发布《2025新智元ASI前沿趋势报告》,大会集结百度CTO、NVIDIA副总裁等十位领航者,以「十人十题」解构AI五阶段路线图,纵贯大模型、Physical AI、具身智能到医疗AI、视频AI、脑科学、AI Agent与人才培养,定义下个十年智能图景。
天啦噜,搞大模型的实在太疯狂了。 这不,Anthropic官宣完成了新一轮融资: F轮,融资130亿美元,最新估值达到了1830亿美元——比上一轮暴涨近300%。这也再次刷新了行业新纪录。 要知道,Anthropic成立也才4年。但就在这次融资之后,已经一举成为全球第四大估值最高的初创公司,仅次于SpaceX、OpenAI和字节跳动。 融资之外,Anthropic的业务造血能力也被进一步披露。短短半年时间,公司营收从10亿美元年化,一跃突破50亿美元。其中最核心的AI编程业务Claude Code年收入更是突破5亿美元。 实际上,Anthropic开启新一轮融资以来,市场热情高涨,融资和估值也
AI 硬件,已经成为大模型之后,又一个令人兴奋的领域。 正如 AI Agent 从通用开始走向垂直,AI 硬件,也已经逐渐分化到「陪伴」、「工作」等各个垂直领域。
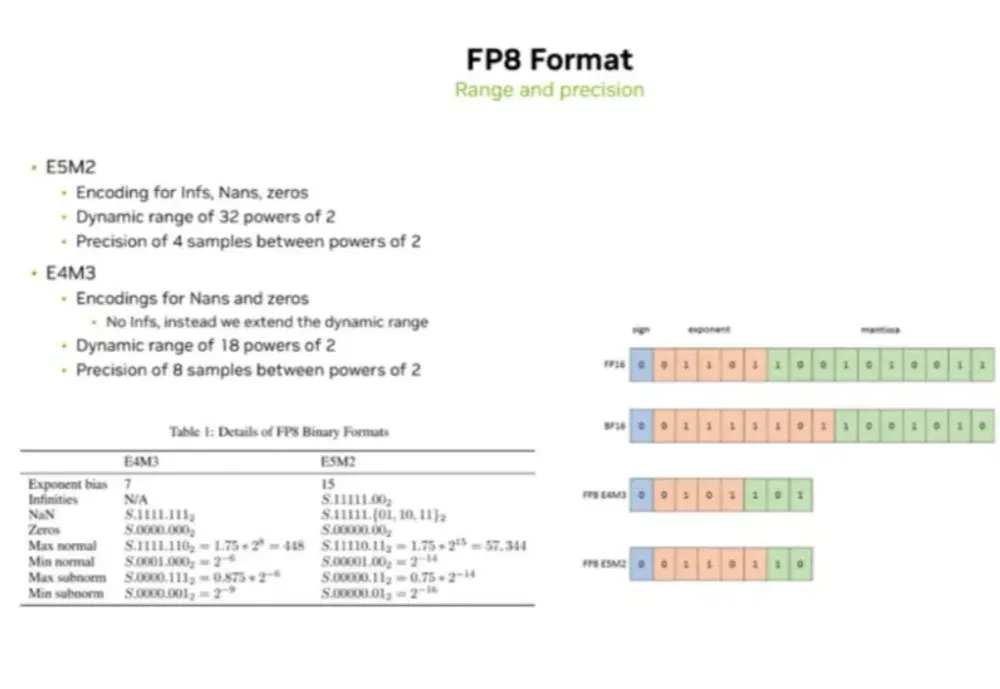
当前AI大模型(LLM)训练与推理对算力的巨大需求,以及传统计算精度(如FP16/BF16)面临的功耗、内存带宽和计算效率瓶颈。
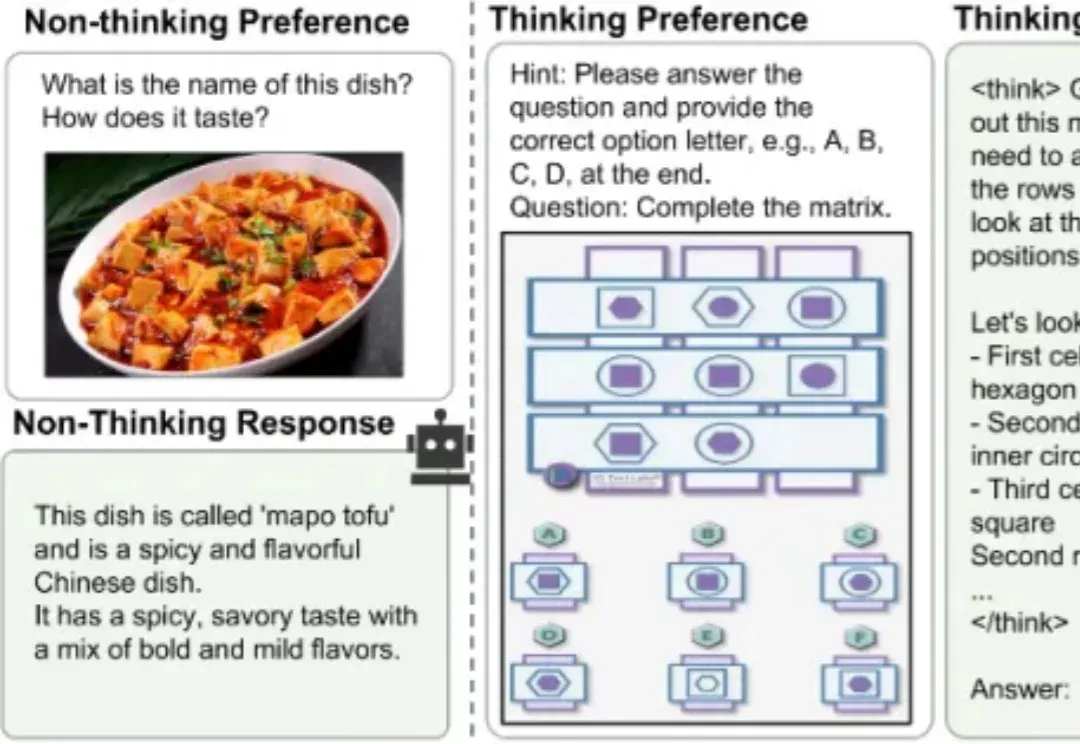
当前,业界顶尖的大模型正竞相挑战“过度思考”的难题,即无论问题简单与否,它们都采用 “always-on thinking” 的详细推理模式。无论是像 DeepSeek-V3.1 这种依赖混合推理架构提供需用户“手动”介入的快慢思考切换,还是如 GPT-5 那样通过依赖庞大而高成本的“专家路由”机制提供的自适应思考切换。
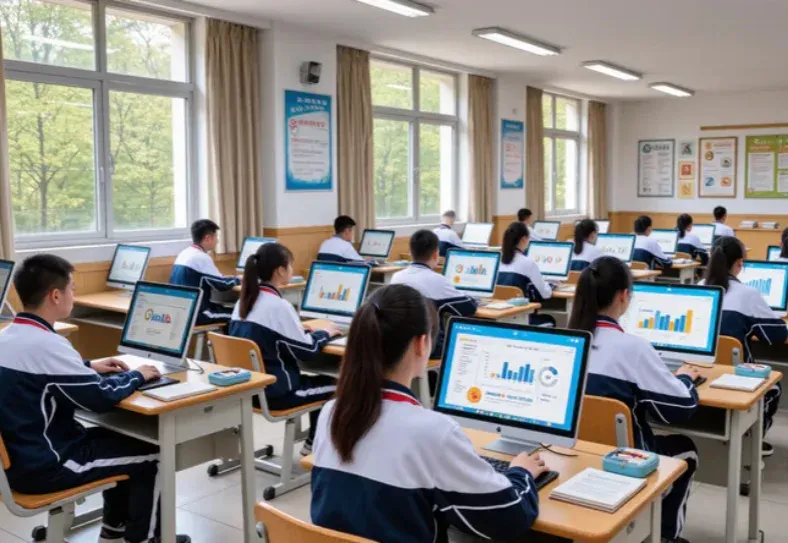
过去一年,教育AI的热闹几乎无需赘述: 科大讯飞的中报显示,上半年营收突破百亿元,AI学习机业务继续翻番;网易有道推出基于“子曰”大模型的系列新品;作业帮发布新一代AI学习机P50;凯叔讲故事推出首款智能硬件产品“AI鸡飞飞”;“与爱为舞”估值接近6亿美元,跃升为赛道明星;“跃然创新”完成AI玩具领域最大单笔融资。 热闹之外,是肉眼可见的冷却与分化:Heeyo创始人转向AI Agent赛道,团队重心转移;Cathoven创始人加入大厂创新部门;一度火爆的AI自习室,在政策松动与线下培训回归后迅速退潮,加盟商成了最先受伤的一批人。曾被视为“技术胜利”的产品,正暴露出更深层的商业风险。 短短一年,
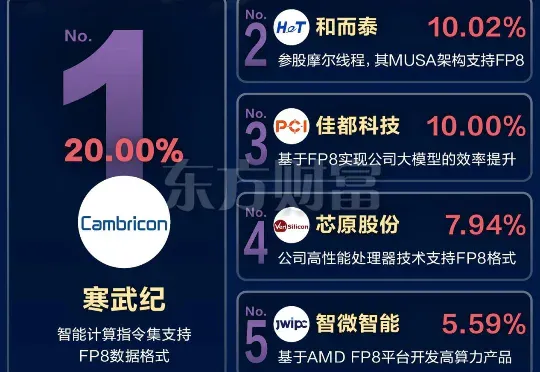
DeepSeek发布DeepSeek-V3.1,使用的UE8M0 FP8 Scale针对下一代国产芯片设计
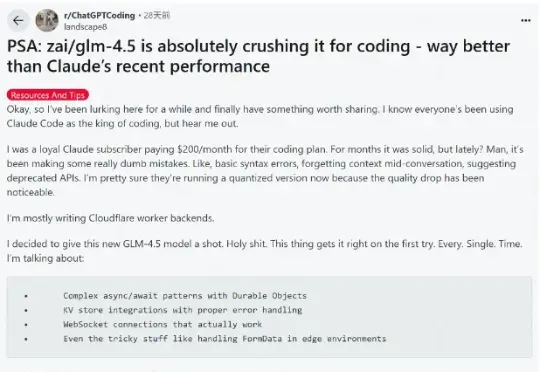
这段时间 AI 编程的热度完全没退,一个原因是国内接连推出开源了不少针对编程优化的大模型,主打长上下文、Agent 智能体、工具调用,几乎成了标配,成了 Claude Code 的国产替代,比如 GLM-4.5、DeepSeek V3.1、Kimi K2。
在AI以指数级加速迈向ASI的2025年,新智元迎来十周年历史时刻,将于9月7日在北京中关村软件园举办盛大峰会。大会以「新天终启,万象智生」为主题,汇聚百度王海峰、英伟达赖俊杰、百川智能王小川、昆仑万维方汉、未来智能胡郁等多位重量级嘉宾,共同探讨芯片、大模型、Agent、具身智能及医疗智能等全球ASI最前沿突破,展望ASI重塑人类社会的恢弘篇章。