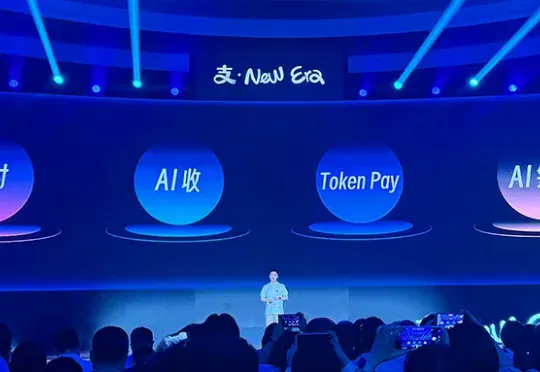
刚刚,支付宝推出全球首个Token Pay服务,还让Agent帮你花钱 (opens in a new tab)
刚刚,蚂蚁集团旗下支付宝亮出AI支付“全家桶”:全球首个Token Pay服务、AI钱包产品,连同此前已落地的AI付与AI收,正式构成一套覆盖授权、支付、结算、管理、安全的全栈AI原生支付体系。
Total 619 articles
刚刚,蚂蚁集团旗下支付宝亮出AI支付“全家桶”:全球首个Token Pay服务、AI钱包产品,连同此前已落地的AI付与AI收,正式构成一套覆盖授权、支付、结算、管理、安全的全栈AI原生支付体系。
大家好,我是袋鼠帝。 不知道大家有没有发现,随着AI的发展,token这个东西居然还变得越来越贵了。
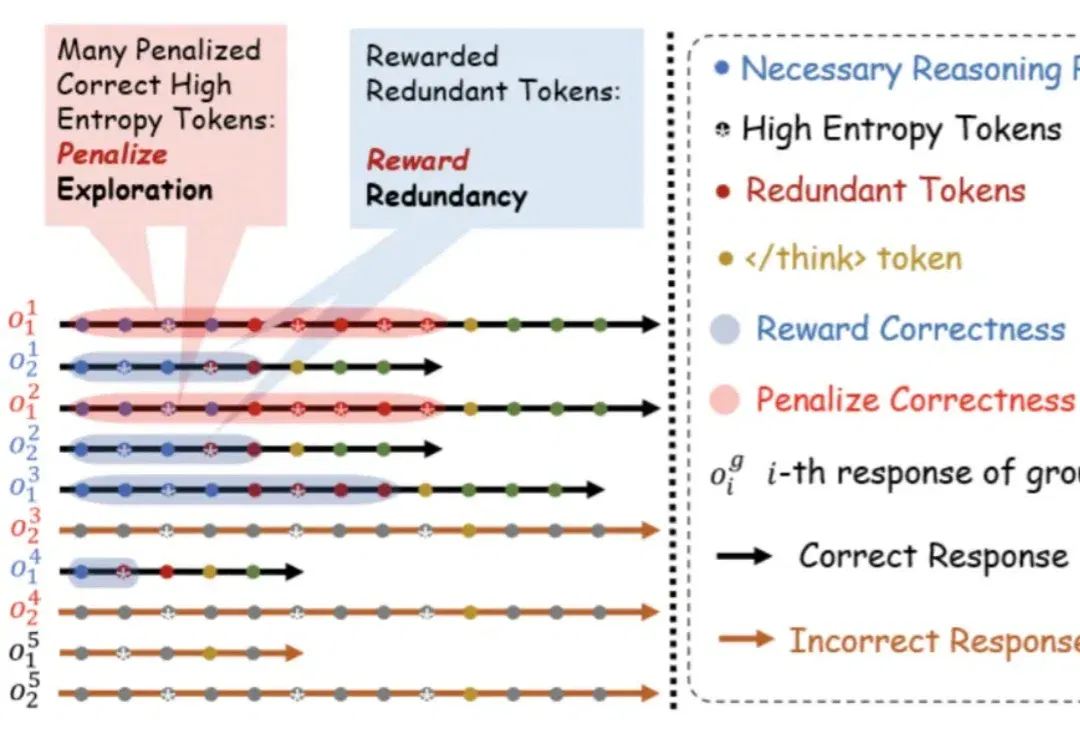
以 DeepSeek-R1、OpenAI GPT Thinking 为代表的大型推理模型,通过长达数千 token 的「思维链」在各类复杂推理任务中展现出卓越的性能。然而,这些模型普遍存在一个核心问题,即过度思考(overthinking) :
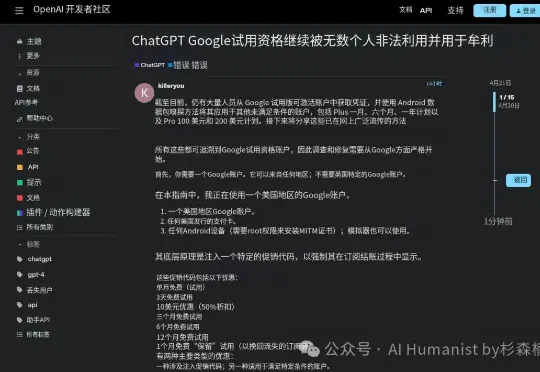
2026 年 4 月 21 日凌晨,OpenAI 开发者社区论坛上出现了一条帖子,Token 经济,人类史上「第一个叛徒」由此出现了:发帖的人叫 Killeryou。如果你混过中文技术社区,应该对这个名字不陌生。他过去两年一直活跃在 AI 工具的薅羊毛前线,属于那种既会写爬虫也会开店的角色。
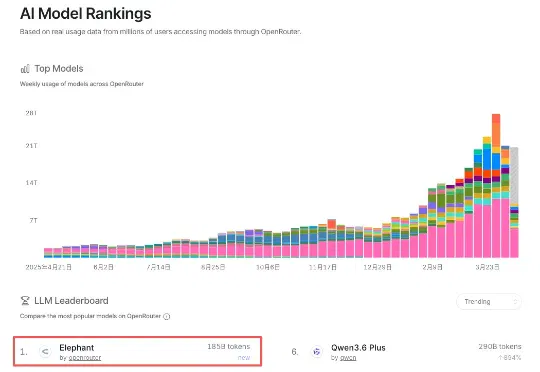
浪费的原因很具体,AI应用从“对话”转向“执行”,这些计算资源流向了较贵的大型旗舰模型,Agent在复杂多轮任务中,历史文件、对话会不断累积,大量无用、冗余、过期的信息会不断产生并且重复计算,Token消耗因此指数级增长。也就是说,企业和开发者在用最贵的车跑最短的路。
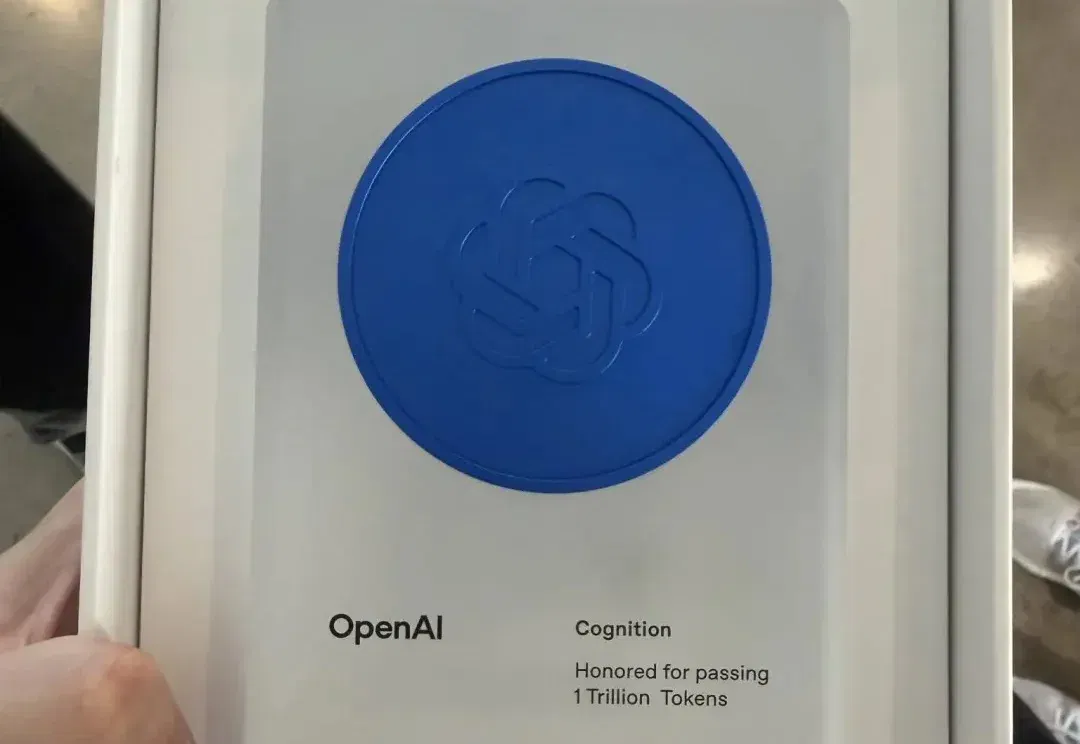
就在上周,OpenAI 的一名工程师创下了一个离谱的纪录:他在七天内消耗了 2100 亿个 Token。
英伟达200亿美元「招安」Groq,推理芯片赛道一夜变天。但在大洋彼岸,一家北大系创业公司刚刚交出了自己的流片答卷。
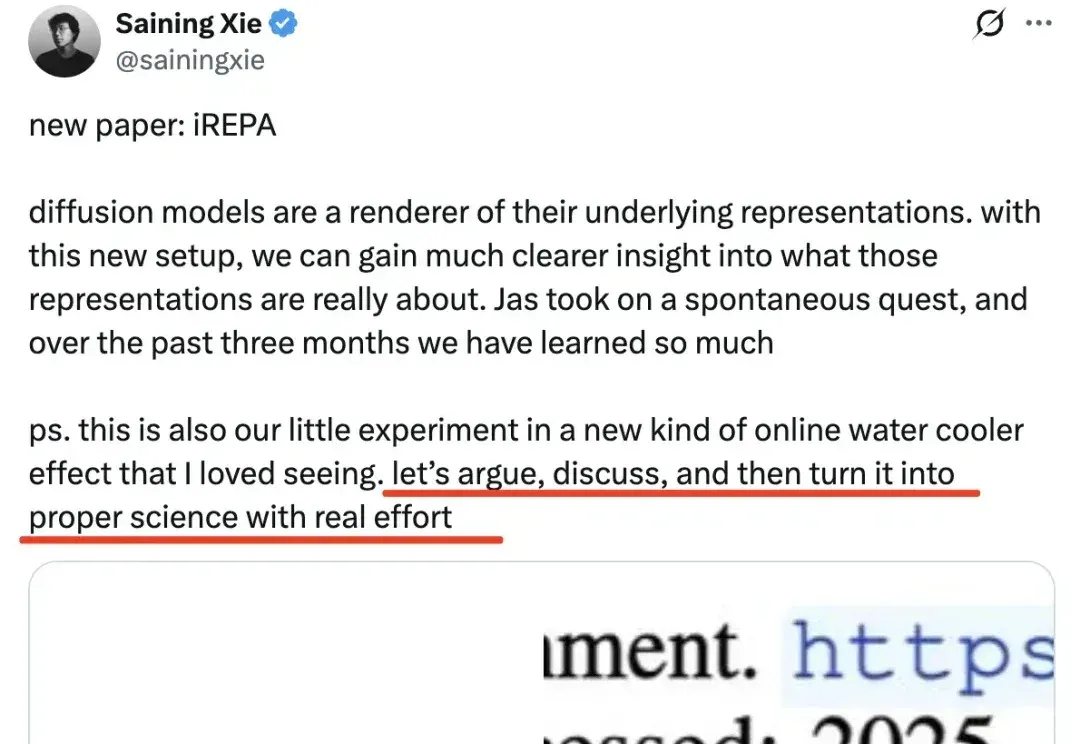
要说真学术,还得看推特。 刚刚,谢赛宁自曝团队新作iREPA其实来自4个多月前的,一次与网友的辩论。 这场短暂的线上辩论虽然以谢赛宁被网友说服告终,但在3个多月后,居然有了意料之外的后续—— 多个团队合作,沿着这一思路写出了一篇完整的论文,而且核心框架仅需3行代码。 致谢部分还感谢了当时参与讨论的网友。 一篇推特引发的学术论文 事情是这样的。 一位网友在8月份表示: 别再痴迷于ImageNet-1K的分类分数了!自监督学习(SSL)模型应该专门为稠密任务(如REPA、VLM等)进行训练,因为这些任务真正依赖的是patch tokens中的空间和局部信息,而不是[CLS]token所代表的全局分
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
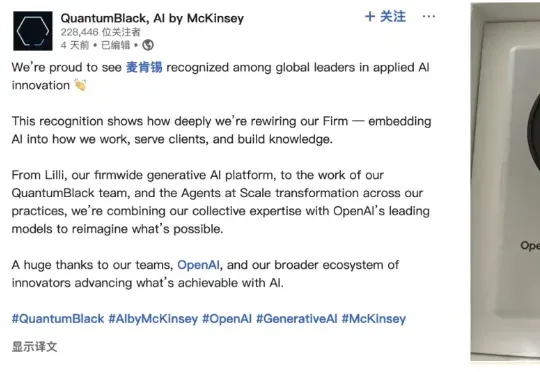
魔幻啊魔幻。 全球顶级咨询公司麦肯锡,居然收到了OpenAI最近给Tokens消耗大客户颁发的奖牌。 麦肯锡自己还怪自豪的,第一时间就把奖牌po到了领英上。