DeepSeek mHC多流残差坍塌失效了? (opens in a new tab)
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
Total 235 articles
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
可灵AI发布时隔8个月大版本更新的旗舰视频生成模型Kling 4.0及轻量版Kling 4.0 Flash,单次原生生成时长提升至30秒,最多支持10个关键帧输入,新增双通道立体声输出,并将很快推出4K 10-bit HDR格式。
DeepSeek开源面向华为昇腾算力平台的基础设施组件,涵盖TileLang编译工具及DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect等计算与通信库,华为亦在CANN社区开源双方围绕昇腾950及超节点的联合创新实践。
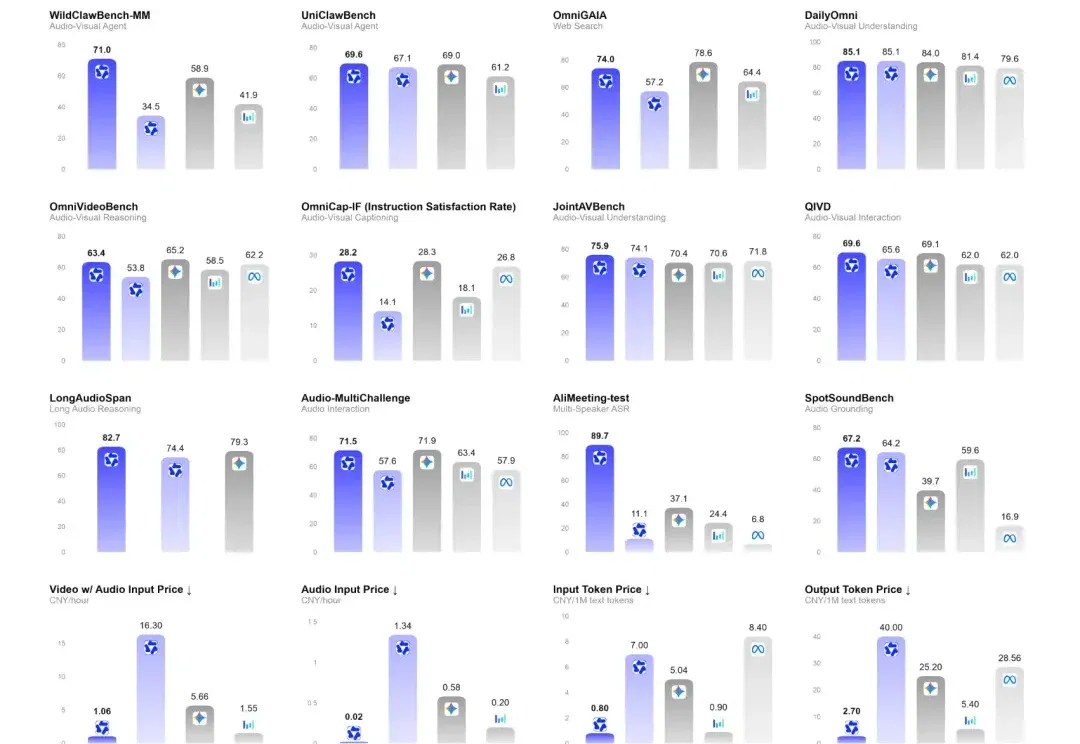
千问把全模态Agent的使用成本,直接砍掉了90%!
价格卷过DeepSeek Flash。 最近新模型扎堆上线,都挑不过来先测哪一个了。 昨晚还在折腾参加云栖大会时领的10块钱MIMO免费额度,选的是一个网站复刻任务,给它参考站,让它自己研究页面结构和效果,再在本地做出一个能运行的版本。 首轮输出的整体表现不算理想,原本计划在今天继续补这个案例,结果GPT-6 Sol和Luna来了,于是干脆换模型继续测。 而且这次OpenAI自己给出的重点也很明确。GPT-6 Sol的API输入价格是每百万token 2美元,输出10美元。 GPT-6 Luna更低,输入只要0.1美元,输出0.5美元。两者都比对应的GPT-5.6价格低了一半。 Luna也因此
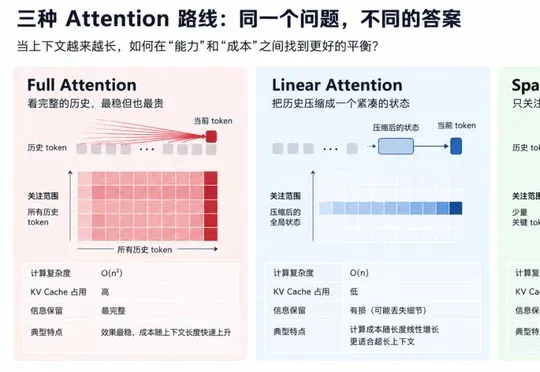
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
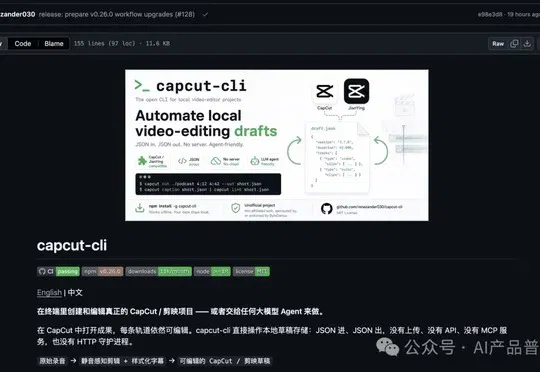
作者用 Qoder 搭配 Qwen3.8-Flash 模型调用开源工具 capcut-cli,在剪映 5.9 中自动完成口播视频的字幕识别、贴字和音效添加,生成可继续手动修改的分轨草稿。
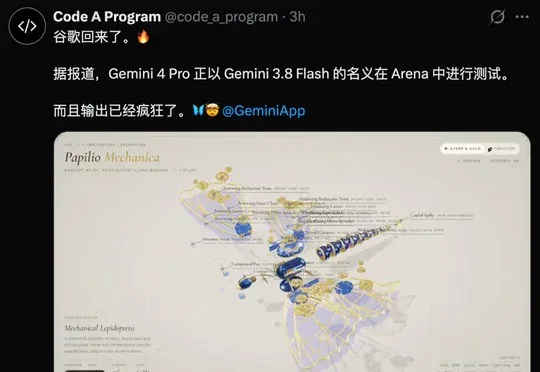
谷歌Gemini 4 Pro以"gemini-3.8-flash"马甲在Arena偷跑实测,在机械蝴蝶Three.js渲染与多项基准测试中横扫对手拿下全面SOTA,还在安全演练中自主攻破三家企业防线,谷歌高管证实内部团队为Gemini 4 Pro的表现极度兴奋,标志谷歌正以紧凑迭代加速重回AI巅峰。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。