深度|大模型厮杀背后:谁在成为AI时代的隐形 “卖铲人”? (opens in a new tab)
AI行业正上演一场冰火两重天。一边是大模型公司将烧钱推向极致,万亿美元级别的开支砸向算力与研发;另一边,不练模型、不抢GPU,帮AI企业“管钱”的金融基础设施公司营收飙升。当所有人都在追问哪个模型会赢时,真正的赢家或许是这些提供AI基建的公司。
Total 1517 articles
AI行业正上演一场冰火两重天。一边是大模型公司将烧钱推向极致,万亿美元级别的开支砸向算力与研发;另一边,不练模型、不抢GPU,帮AI企业“管钱”的金融基础设施公司营收飙升。当所有人都在追问哪个模型会赢时,真正的赢家或许是这些提供AI基建的公司。
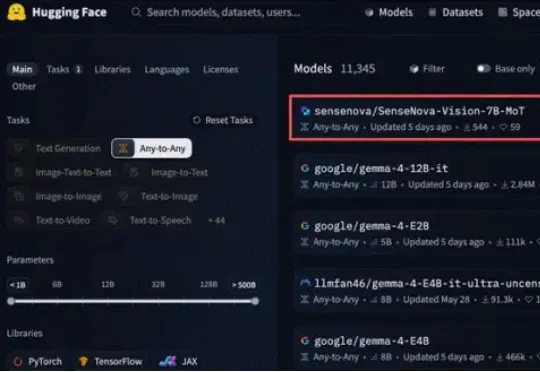
近日,商汤科技发布并全面开源日日新SenseNova-Vision理解生成统一视觉大模型,试图宣告视觉AI“缝合怪”时代的终结。截至当前,该模型综合得分登顶Hugging Face Any-to-Any Leaderboard,位列该全模态任意输入输出开源模型榜单全球第一。
美团今日宣布开源万亿参数大模型LongCat-2.0,同步开放针对国产算力芯片深度优化的推理代码。该模型总参数达1.6万亿,平均激活约480亿参数,是业界首个在五万卡国产算力集群上完成全流程训练与推理的万亿参数模型。
豆包大模型2.1 Pro正式发布。但字节这次没有像某些厂商那样疯狂堆参数、刷榜单,而是把刀锋对准了一个更硬核的方向:让AI真正能“干活” 。作为本次大会发布的主力模型,豆包2.1 Pro 在 Coding(编程)、Agent(智能体)、VLM(视觉语言模型)三大核心方向实现能力跃升,多项评测表现优于Claude Opus 4.6
AI行业,最稀缺的抢手货变了。 李飞飞提出“空间智能”后,行业正在形成一个越来越明显的趋势判断:大模型之后,世界模型、具身智能正成为资本和产业关注的新焦点。 然而,AI开始转向理解并作用于真实的物理世界之时,一个尴尬的现实也随之浮现: 训练这些模型所需的真实物理世界交互数据,极度稀缺——缺到甚至有业内观点认为,需求与供给之间,可能存在近十万倍的差距。 因为过去的大模型,靠海量文本和图片就能完成语言理解与生成,但具身智能需要的是“决策→行动→反馈”的完整链条——这些静态、缺乏因果和交互的数据,很难再满足需求。 行业迫切需要一种全新的数据:来自真实物理世界、带有因果逻辑、能持续产出的交互数据。 于
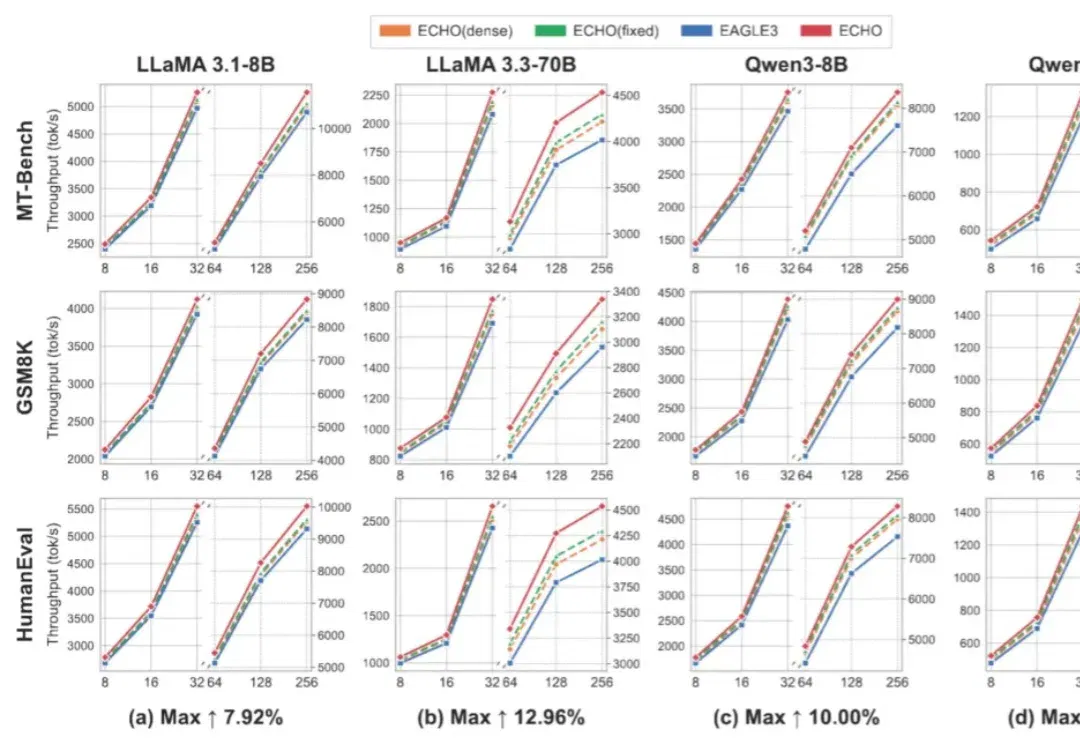
随着大模型参数规模持续扩大,推理成本已经成为生产级 LLM 服务的核心瓶颈。投机解码(Speculative Decoding, SD)通过「小模型 draft + 大模型 verify」的方式,将多个候选 token 放到一次目标模型前向中并行验证,从而缓解自回归解码的串行瓶颈。
当大模型训练进入深水区,竞争的关键已经不再只是「模型参数怎么调」,而逐渐转向一个更核心、也更难系统解决的问题:模型在训练过程中究竟看到了什么数据、以什么比例看到、哪些样本应该被更频繁地学习。
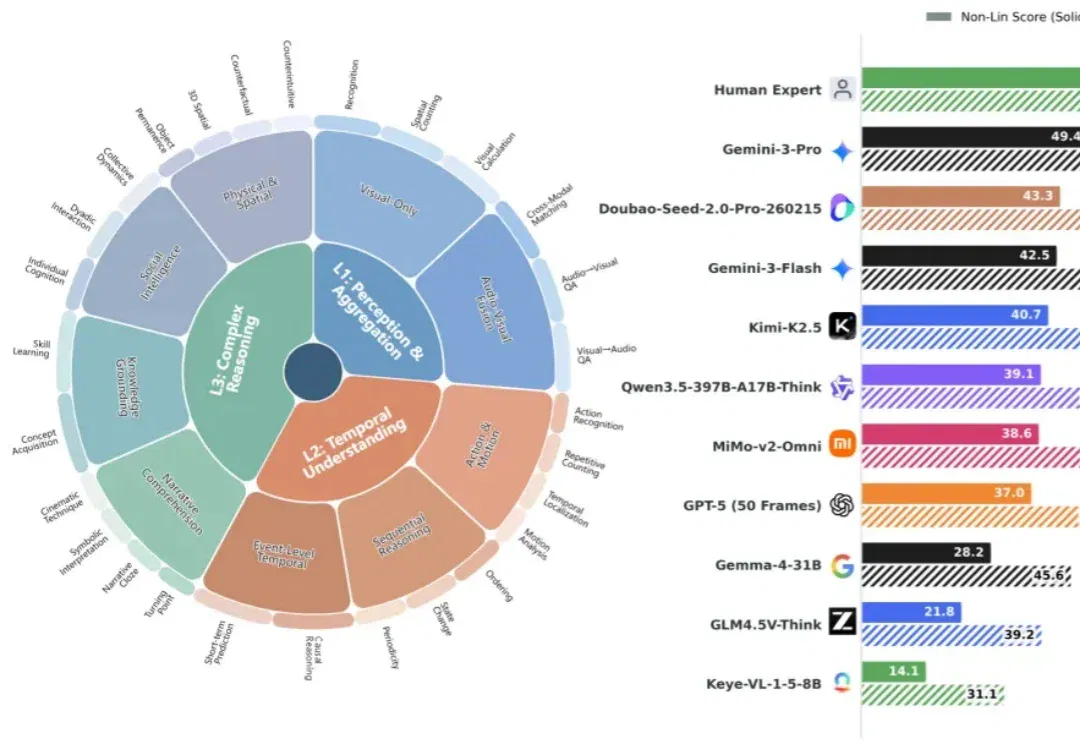
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在 Google Gemini 评测团队邀约下推出视频理解新基准 Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及 3300 + 人工时高质量标注,揭示模型与人类的巨大鸿沟(49 vs 90)、传统 Acc 指标虚高、以及 “Thinking” 并非总是增益等现象。
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在Google Gemini评测团队邀约下推出视频理解新基准Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及3300+人工时高质量标注,揭示模型与人类的巨大鸿沟(49vs90)、传统Acc指标虚高、以及「Thinking」并非总是增益等现象。
字节Seed最新研究,让大模型能“原地改参数”了。既不用改模型结构,也不用重新训练,还跑得很快。具体是这么个情况。智能体时代嘛,大家都知道模型们面对的任务开始变得越来越复杂、上下文越来越长。