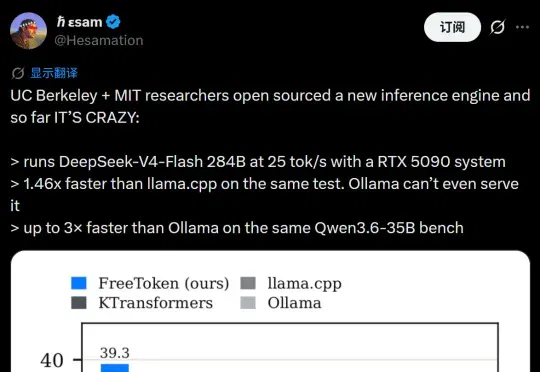
单卡5090跑满血DeepSeek V4Flash,已开源,Token自由了! (opens in a new tab)
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
Total 619 articles
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
同一段文字,扔给两个模型,一个切成766个token,另一个切成1170个。
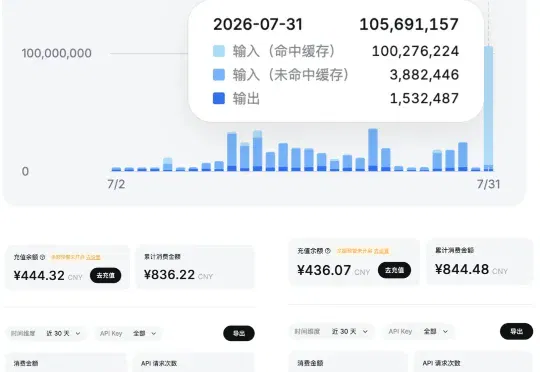
DeepSeek-V4-Flash风评冲爆了,原生支持接入Codex,而且还强化了Agent能力。我第一时间把它接进了Codex,用cc swich非常方便。一个小时,跑了一亿多token。跟大家说说体感。
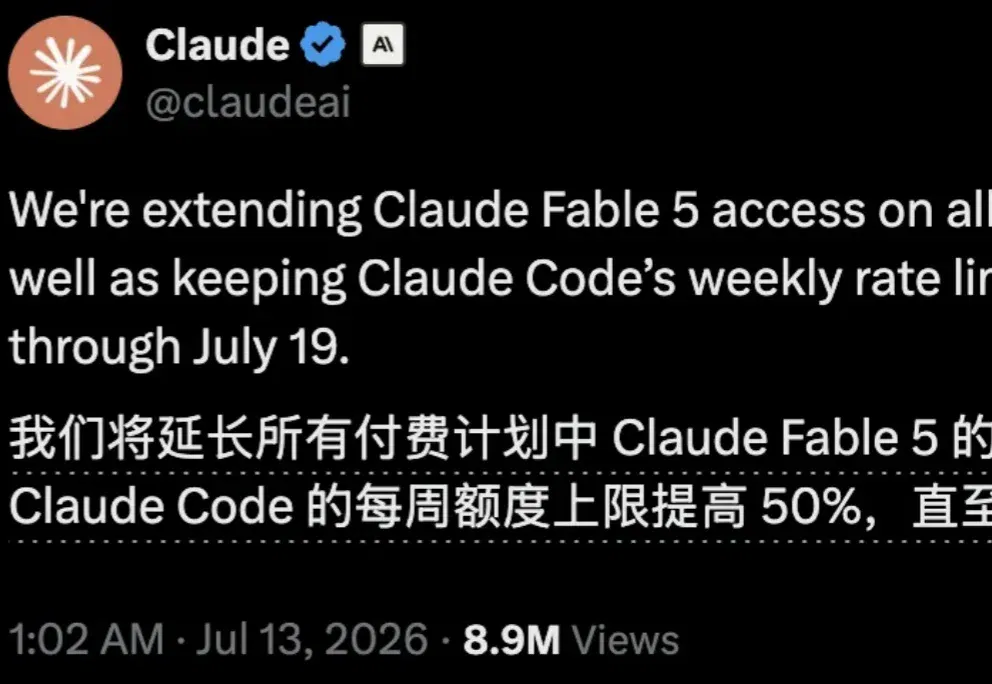
卷起来了! A社宣布将Claude Fable 5的订阅期限延长再次7天,至7月19日。 不出一个小时,OpenAI反手就是一个暂时移除Codex的5小时使用限制,期限未知。 全球开发者喜大普奔,还有人因为token用不完就连续工作,把自己整医院里去了。 奥特曼还在追加奖池: 怎么,一夜之间是算力不缺了还是电力不缺了? 超越注意力的算法出现了还是太空算力建成了,还是可控核聚变发电了? 用户晒账单逼宫,A社紧急让步 都缺,但是更缺的是用户。 此前由于算力容量持续紧张,A社已多次推迟将Claude Fable 5切换至按量付费模式的日期。 这次延期的直接导火索是用户大规模反弹。 大量用户晒出高额信
由阿里巴巴集团孵化的空间智能企业“元境”,正在内测“JellyToken”,平台定位AI大模型一站式超市,支持一套密钥调用多款模型。该平台整合了Qwen3.7、Seedance2.0等多款国产大模型,面向个人创作者、中小团队、企业推出付费统一调用服务。
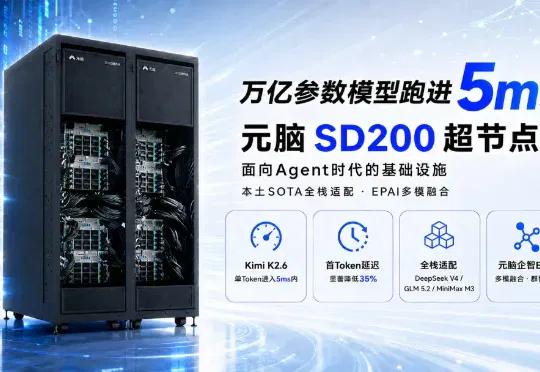
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
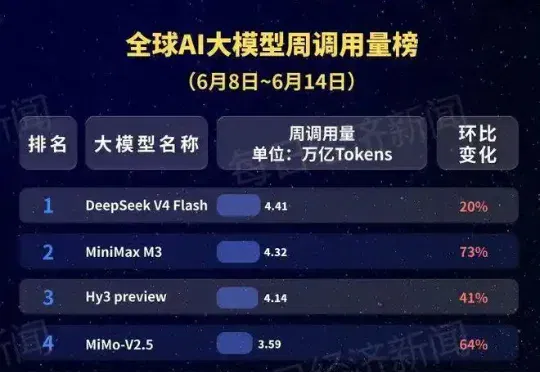
根据OpenRouter最新数据测算,上周(6月8日至14日)全球AI大模型总调用量为44.6万亿Token,较此前一周增长23.5%,连续八周上涨,大模型调用需求仍在持续释放。
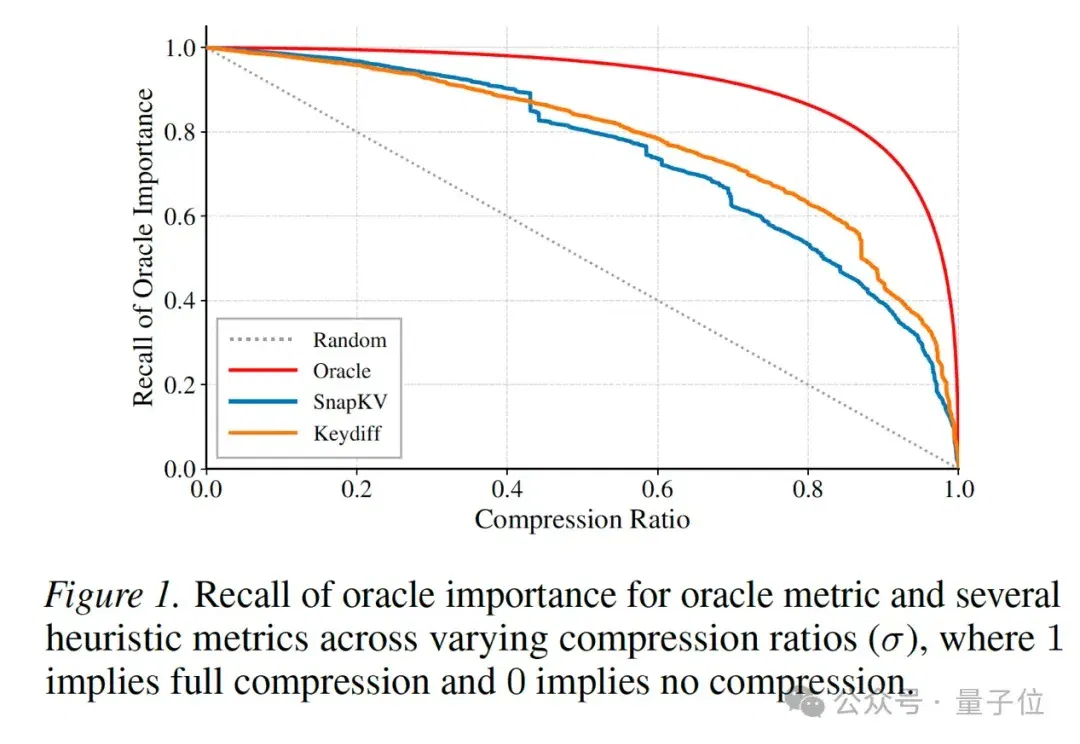
随着AI Coding、Agent、Deep Research 等应用快速普及,模型单次处理的上下文长度正在从几万Token迈向几十万甚至百万Token。
今天,“港股AGI第一股”云知声发布其最新通用大语言模型U2,该模型是由云知声自研的、基于快慢思考融合的MoE(混合专家)范式构建的通用大语言模型。U2跳出了传统大模型盲目堆参数、堆Token的内卷路径,实现了“小参数强能力、少Token高产出、低算力低成本”的进化。
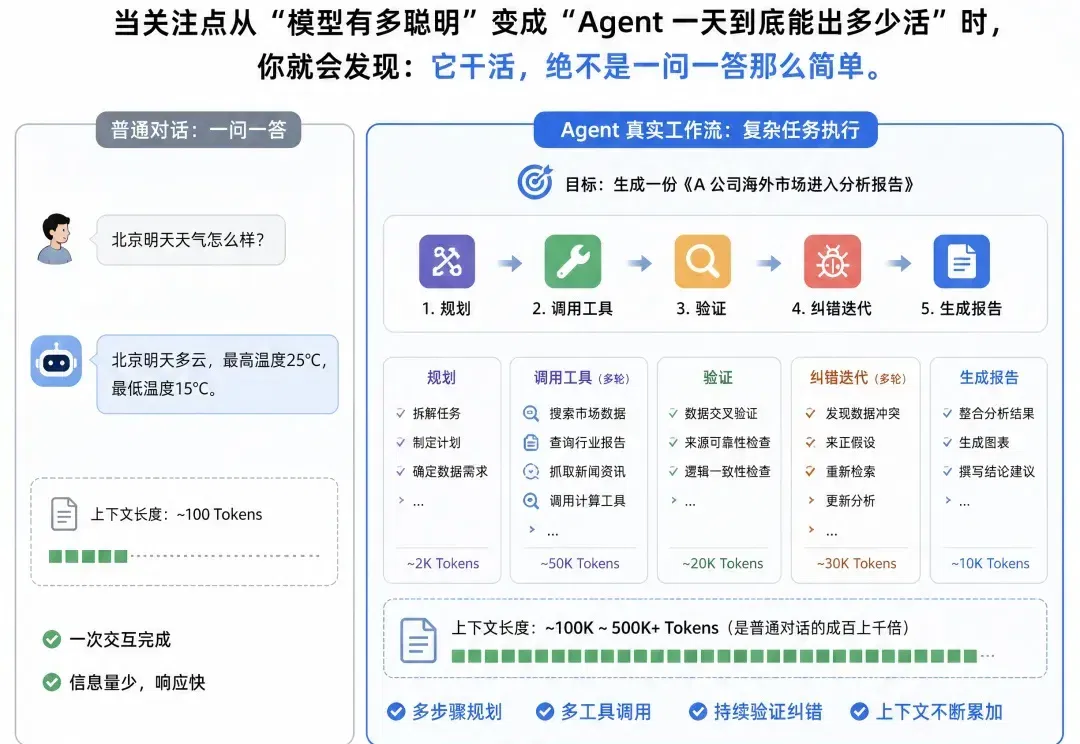
感觉大家对追新这事,没那么上头了。 要是去年,哪怕是大半夜发个新模型,朋友圈里必定有一票人熬夜实测。现在甩个新闻链接大家点个赞就算看过了。 我复盘了下大家热情消退的最大原因,就是现有模型已经够强了。 以前是我们拿既有问题去试,测完都觉得差口气。现在随便拎个主流模型出来,给 Agent 一挂,稳如老狗,自然懒得再去折腾所谓的“参数突破”。 当我们的关注点从模型有多聪明,变成 Agent 一天到底能出多少活的时候,你就会发现它干活,绝不是一问一答那么简单。 它需要不断地规划、调用工具、验证和纠错。这就导致它要处理的上下文长度,通常是普通对话的成百上千倍。只要任务还在推进,信息就会层层累加,Toke