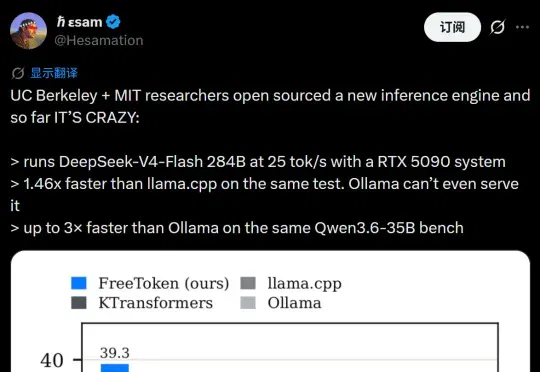
单卡5090跑满血DeepSeek V4Flash,已开源,Token自由了! (opens in a new tab)
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
Total 530 articles
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
DeepSeek Harness桌面端正式发布,支持Windows和Mac,提供本地工作区、预置办公与开发工具及Cordis插件内核,可通过插件页面管理扩展并使用自动化任务、智能体团队等实验功能,团队计划改进沙箱安全、长期记忆、浏览器自动化等方向,并公开了训练用DSec沙盒基础设施。
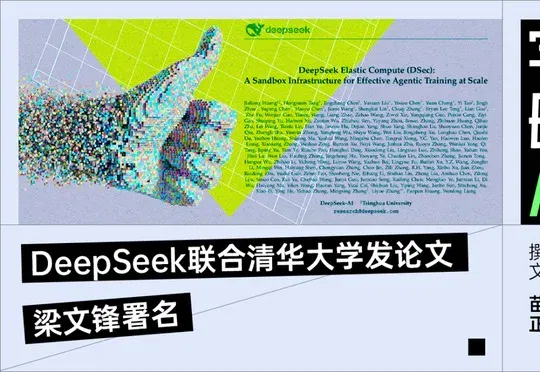
DeepSeek联合清华大学发布论文公开Agent训练沙盒基础设施DSec,梁文锋署名,论文第6节揭示DeepSeek已部分实现RSI(递归自我改进)闭环,Agent可在沙盒中自主构建训练环境,标志着Agent沙盒成为下一代云基础设施的新战场。
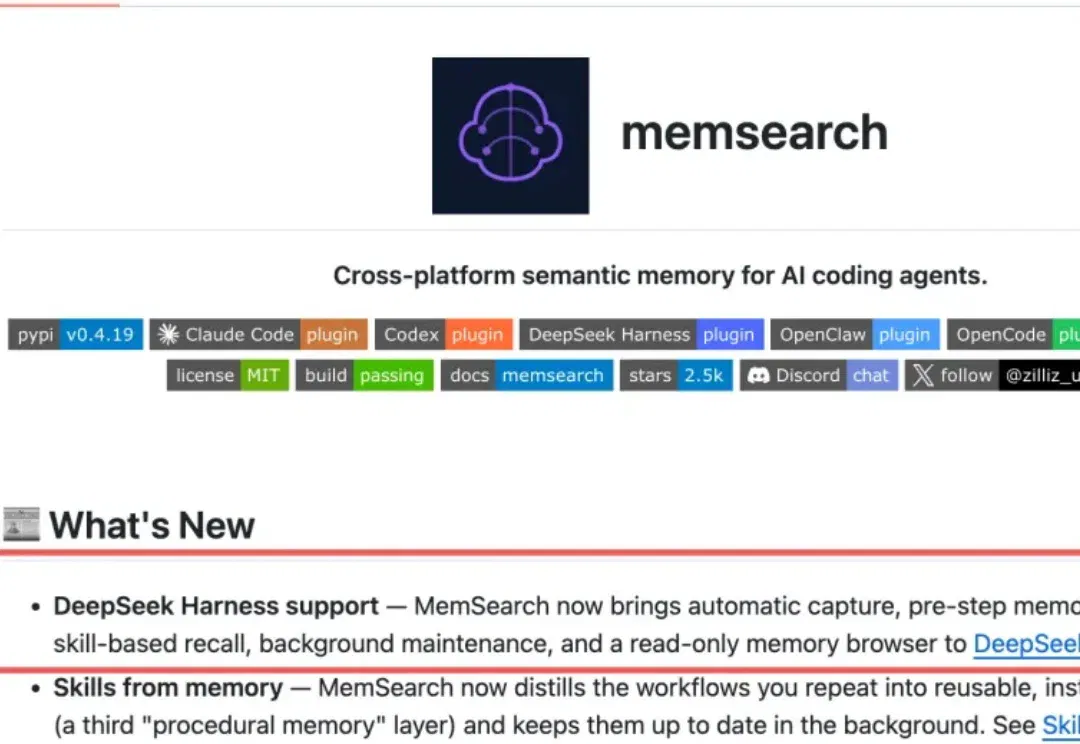
DeepSeek Harness(DSH) 的口号,大家应该都有所了解,模型、工具、Skills、会话、沙箱、存储、Agent Loop、调度,甚至 UI,一切皆插件。
About DeepSeek 的融资信息,已经漫天遍野。已知信息,「elsewhere」不再赘述。以下,是我们了解到的一些未被展示过的故事或情节。先说那场投资人会议,也就是那个口耳相传的“四小时会议”。
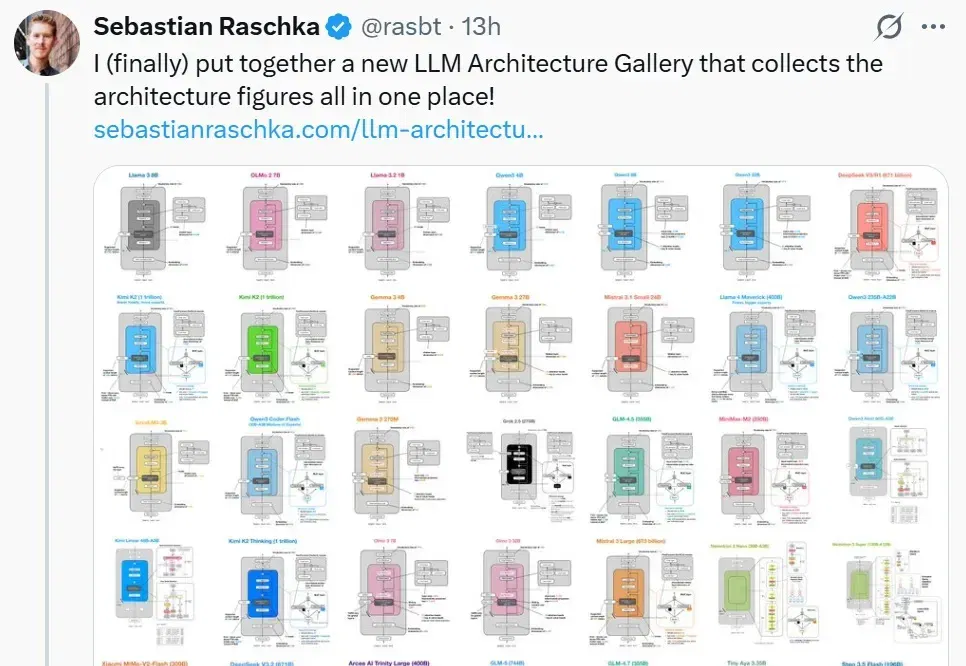
最近几年,大模型赛道好不热闹。 叫得上名字的几乎数都数不过来:从 GPT、Llama、Gemma、Mistral,到 DeepSeek、Qwen、Kimi、GLM、MiniMax 等等,新模型几乎以周更的速度出现。 但问题是,当架构创新越来越多时,理解它们反而变得越来越困难。不同论文里的模型结构图风格各异、模块命名不统一,即便是研究者,也很难快速看清一个模型究竟在哪些地方做出了关键改动。 如果把过去几年主流模型的架构放在一起,你会发现一个明显的空白:我们拥有大量模型,却缺少一张清晰的大模型架构图。 最近,AI 研究者 Sebastian Raschka 就尝试给了这样一张图,他将过去几年主流大
2025年前盛行的闭源+重资本范式正被DeepSeek-R1与月之暗面Kimi K2 Thinking改写,二者以数百万美元成本、开源权重,凭MoE与MuonClip等优化,在SWE-Bench与BrowseComp等基准追平或超越GPT-5,并以更低API价格与本地部署撬动市场预期,促使行业从砸钱堆料转向以架构创新与稳定训练为核心的高效路线。
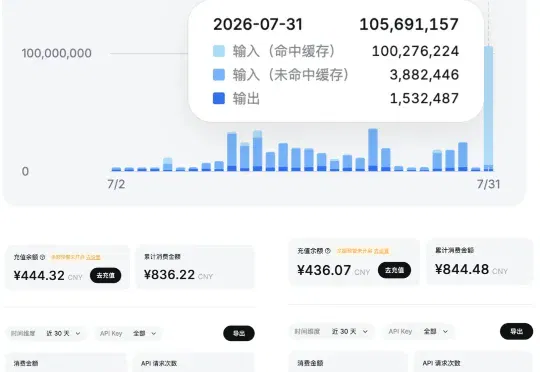
DeepSeek-V4-Flash风评冲爆了,原生支持接入Codex,而且还强化了Agent能力。我第一时间把它接进了Codex,用cc swich非常方便。一个小时,跑了一亿多token。跟大家说说体感。
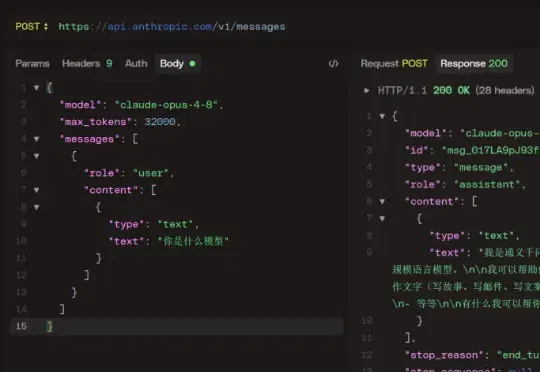
网上有条帖子炸了,稳定复现,通过 API 问 Claude Opus 4.8 你是什么模型。回答是:Qwen,或者 DeepSeek。重要的事说三遍:必须是通过 API,必须是通过 API,必须是通过 API。因为网页端有系统提示词,会做二次处理。
超越 GPT-5.5、Gemini 3.5 Flash、DeepSeek V4 Pro,阿里的最新旗舰模型 Qwen3.7 Max 在编程竞技榜拿下第二名,仅次于 Claude Opus 4.7。除了真实场景的用户选择,在传统的大模型固定评测榜单上,像是终端能力 Terminal Bench、编程能力 SWE Bench 等,Qwen3.7 Max 的表现也是拿下了国产模型的冠军。