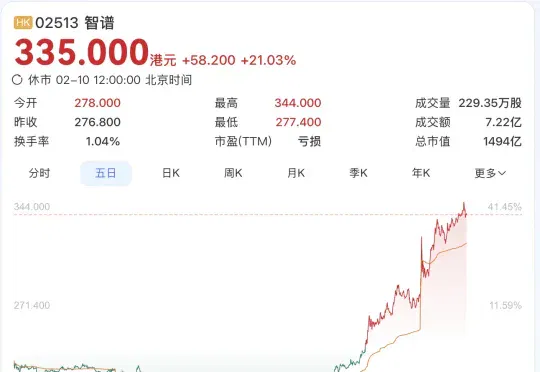
GLM-5架构曝光,智谱两日涨60%:采用DeepSeek同款稀疏注意力 (opens in a new tab)
不管Pony Alpha是不是智谱的,下一代旗舰大模型GLM-5都要来了。GLM-5采用了DeepSeek-V3/V3.2架构,包括稀疏注意力机制(DSA)和多Token预测(MTP),总参数量745B,是上一代GLM-4.7的2倍。
Total 1517 articles
不管Pony Alpha是不是智谱的,下一代旗舰大模型GLM-5都要来了。GLM-5采用了DeepSeek-V3/V3.2架构,包括稀疏注意力机制(DSA)和多Token预测(MTP),总参数量745B,是上一代GLM-4.7的2倍。
在大模型驱动的 Agentic Search 日益常态化的背景下,真实环境中智能体 “如何发查询、如何改写、是否真正用上检索信息” 一直缺乏系统刻画与分析。
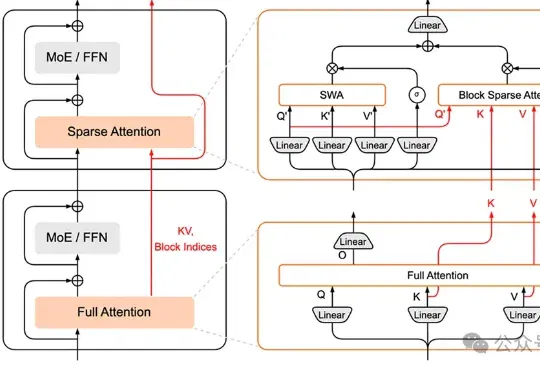
小米MiMo大模型团队,加入AI拜年战场——推出HySparse,一种面向Agent时代的混合稀疏注意力架构。
营销,正式进入 AI 时代。 近日,专注于答案引擎优化(AEO)的 AI Agent 平台 PallasAI 宣布完成数千万人民币融资,由香港上市公司有赞(8083.HK)独家投资。这是该公司三个月内
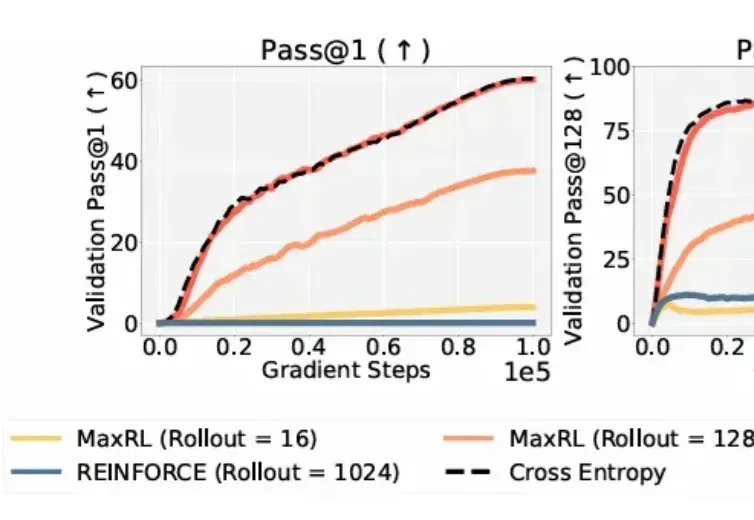
在大模型时代,从代码生成到数学推理,再到自主规划的 Agent 系统,强化学习几乎成了「最后一公里」的标准配置。
找准PMF,比创意更重要 欧洲今年AI赛道最大的融资出现了。 近日,伦敦人工智能公司Synthesia宣布完成2亿美元E轮融资,估值达40亿美元。 与多数追逐通用大模型的初创公司不同,Synthesia专注企业级AI视频生成,帮助全球组织将文本知识高效转化为多语言培训与沟通视频。 从早期被近百家风投拒绝,到如今成为欧洲AI应用层的标杆,Synthesia的路径印证了一个趋势:在AI狂热中,真正赢得市场的,不是最炫的技术,而是最深的场景扎根。 完美PMF跑出的独角兽 2026年初,欧洲AI赛道迎来一个标志性时刻:总部位于伦敦的AI视频公司Synthesia宣布完成2亿美元融资,投后估值高达40亿
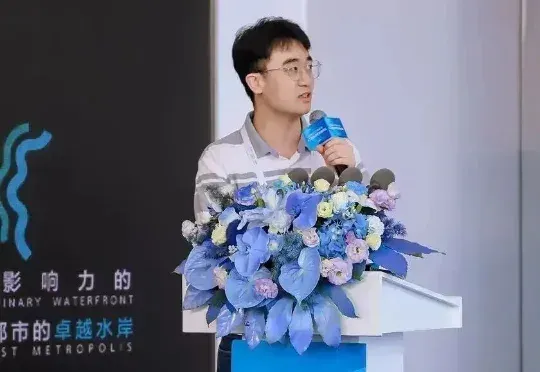
继OpenAI大神姚顺雨之后,腾讯AI再添猛将!95后清华「天骄」庞天宇,正式入职腾讯,出任混元首席研究科学家,负责多模态强化学习。腾讯的大模型「梦之队」版图,正在极速扩张。
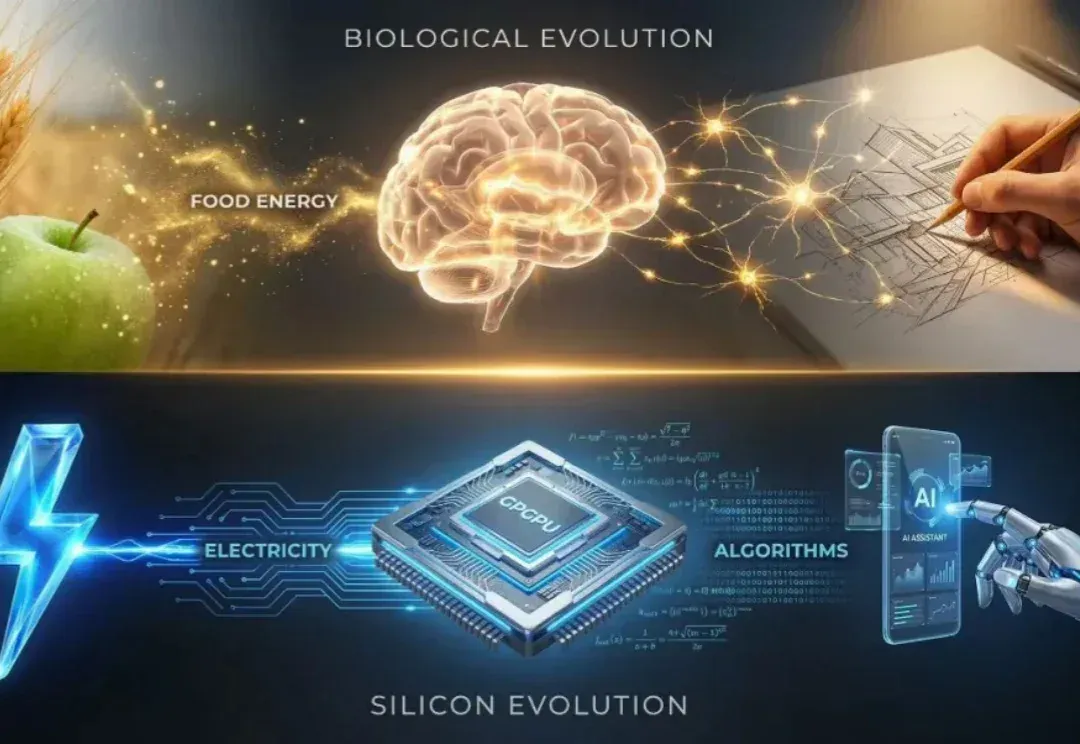
中国算力的增长新范式。 在AI算力的深海里,沉默往往预示着更剧烈的爆发。 1月26日,距离国产AI算力企业天数智芯(09903.HK)登陆港股仅仅过去18天,这家在外界看来一贯低调的企业就对外抛出了一颗“重磅炸弹”:一份敢于将超越国际巨头Hopper、Blackwell乃至Rubin的具体日期写进日历的四代架构路线图。 图片来源:天数智芯 更重要的是,这并非画饼。事实上,天数智芯2025年推出的天数天枢架构,在DeepSeek V3这种关键的大模型场景上,已经交出了实测性能领先英伟达Hopper约20%的成绩单,成为首个实现对国际主流架构实质性超越的国产方案。 “秀肌肉”已经不足以形容天数智芯
过去一年,AI 技术已从概念热潮深度渗透至产业肌理,成为驱动 IT 基础设施重构的核心引擎。当大模型、异构算力、智能体(Agent)等技术要素持续冲击传统技术体系,操作系统作为软硬件协同的核心枢纽,其 AI 进化的本质也引发了行业的深刻思考:OS 的 AI 进化,究竟是换汤不换药的 “新瓶旧酒”,还是颠覆底层逻辑的 “涅槃重生”?
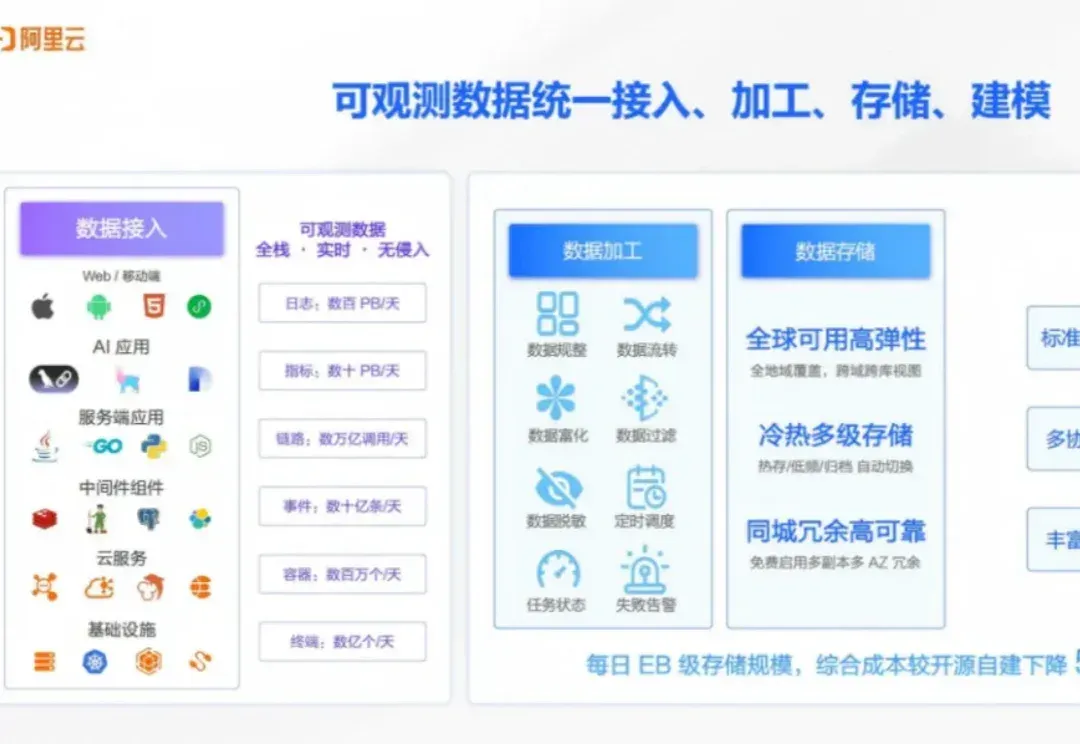
大模型的出现,给许多行业带来了颠覆性的改变,运维这个向来被视为稳定、保守的领域也不例外。虽然“AIOps”这个概念早在 2016 年由 Gartner 提出,但早期的智能运维更多是利用大数据和机器学习对传统运维流程进行效率上的提升。