春节回家我用递归学习法,跟大模型学会了「算八字」 (opens in a new tab)
上个月,我在 X 上刷到一个叫 Gabriel 的年轻人的故事。他从大学辍学,用 AI 自学人工智能,最终成为了 OpenAI 的研究员。真正吸引我的,是他在个人博客里分享的一套学习方法:「递归学习法」。
Total 1517 articles
上个月,我在 X 上刷到一个叫 Gabriel 的年轻人的故事。他从大学辍学,用 AI 自学人工智能,最终成为了 OpenAI 的研究员。真正吸引我的,是他在个人博客里分享的一套学习方法:「递归学习法」。
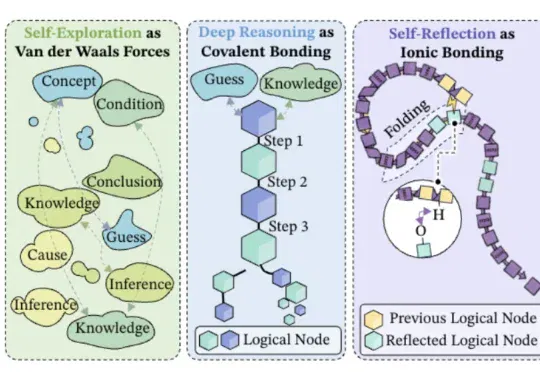
字节Seed都开始用化学思想搞大模型了——深度推理是共价键、自我反思是氢键、自我探索是范德华力?!
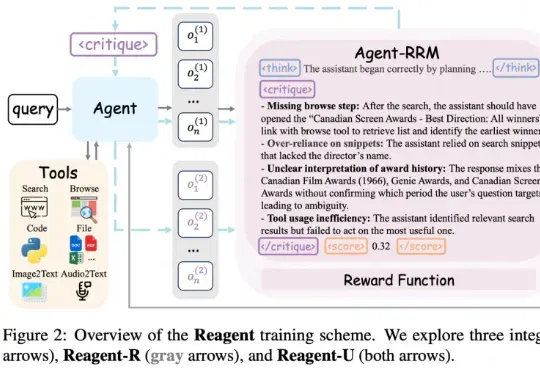
在很多大模型和 Agent 的训练里,最常见的一种做法就是只看结果:最后答案对了就给奖励,错了就当 0 分。 在单轮问答里,这样「只看结果」还勉强能用;可一旦换成 Agent 这种要多轮对话、搜索、刷
1970年,一个叫Gordon Gallup的心理学家把一面镜子放进了黑猩猩的笼子里。黑猩猩一开始对着镜子龇牙。它以为那是另一只黑猩猩。它威胁它,拍胸脯,绕到镜子后面找那只不存在的敌人。
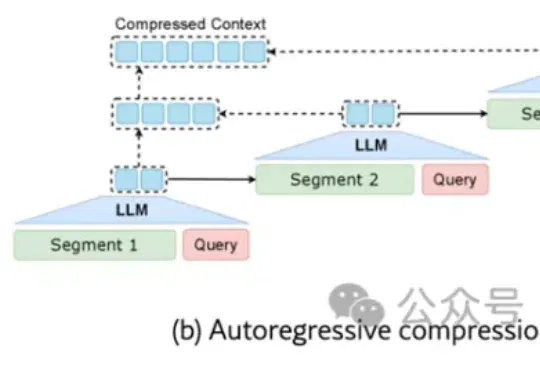
来自清华大学、鹏城实验室与阿里巴巴未来生活实验室的联合研究团队发现:现有任务相关的压缩方法不仅陷入效率瓶颈——要么一次性加载全文(效率低),要么自回归逐步压缩(速度慢),更难以兼顾“保留关键信息”与“保持自然语言可解释性”。
就是说,这几天还有哪档晚会节目是没有机器人现身的吗?
春节还没到,「过年的气氛」已经渗入科技圈每个人的毛孔。单说 AI 大模型这一块,刚刚发布的有 kimi 2.5 和 Step 3.5 Flash,即将发布的据说还有 DeepSeek V4,GPT-5.3、Claude Sonnet 5、Qwen 3.5,GLM-5,说不定一觉醒来,现有的技术就要被颠覆。
2月11日深夜,智谱AI官宣新一代旗舰大模型GLM-5。之前在OpenRouter上神秘出现的"Pony Alpha",身份终于揭晓。据DoNews报道:Pony Alpha就是GLM-5的低调测试版。
在经济学和博弈论的世界里,找到「纳什均衡」往往意味着找到了复杂局势下的最优解。多所顶尖高校的研究人员开发出了一位名为PrimeNash的「AI数学家」,不仅能像人类专家一样推导公式,还能解决许多连传统算法都束手无策的复杂博弈难题,成果已发表在Cell Press旗下的交叉学科期刊Nexus上。
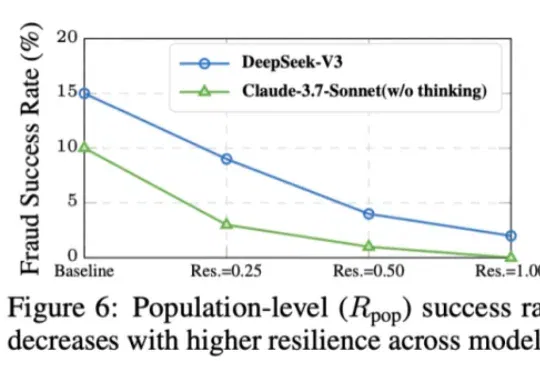
本⽂的主要作者来⾃上海交通⼤学和上海⼈⼯智能实验室,核⼼贡献者包括任麒冰、郑志杰、郭嘉轩,指导⽼师为⻢利庄⽼师和邵婧⽼师,研究⽅向为安全可控⼤模型和智能体。 最近,Moltbook 的爆⽕与随后的迅速