全球强化学习+VLA范式,PI*0.6背后都有这家中国公司技术伏笔 (opens in a new tab)
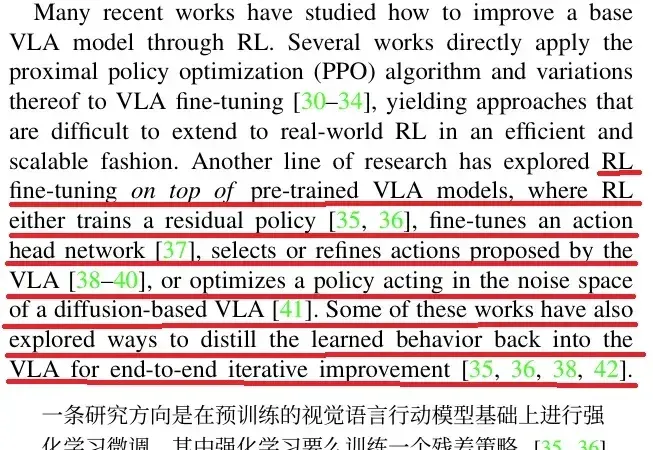
在 Physical Intelligence 最新的成果 π0.6 论文里,他们介绍了 π0.6 迭代式强化学习的思路来源:
Total 122 articles
在 Physical Intelligence 最新的成果 π0.6 论文里,他们介绍了 π0.6 迭代式强化学习的思路来源:
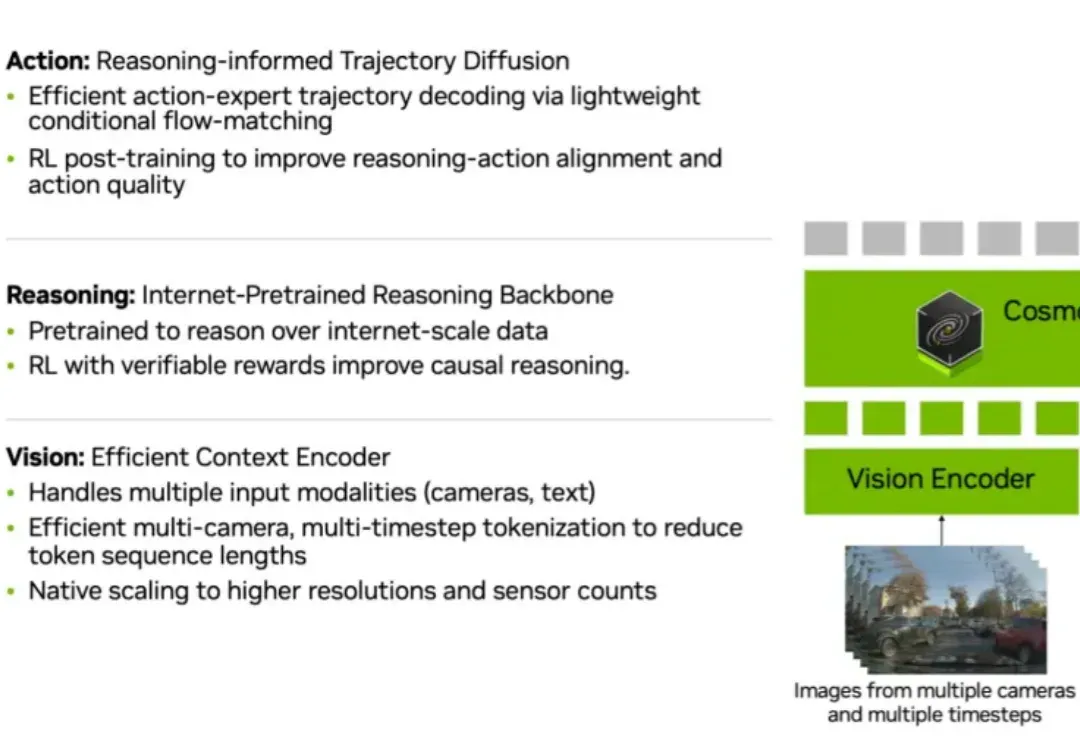
当今自动驾驶模型越来越强大,摄像头、雷达、Transformer 网络一齐上阵,似乎什么都「看得见」。但真正的挑战在于:模型能否像人一样「想明白」为什么要这么开?
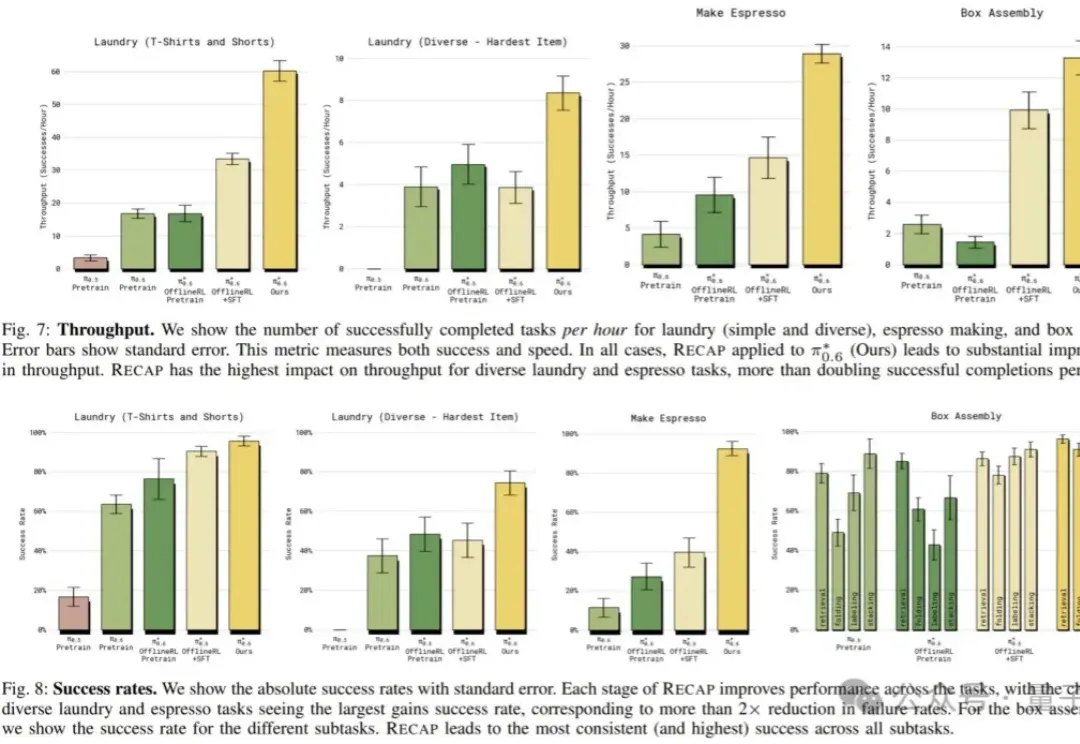
看似轻描淡写,实则力透纸背。 Physical Intelligence刷屏全网的机器人基础模型π*0.6,一亮相就秀出了实力: 让机器人连续一整天制作意式浓缩咖啡,数小时不间断折叠各类衣物,还能精准组装工厂所需的包装纸箱。 在π*0.6的加持下,这些任务的成功率都达到了90%以上。 然而,仔细阅读论文就会发现,比起连做13个小时咖啡,π*0.6真正的突破在于引入了一种更直觉的学习方法——Recap: 指导:用人类示范教它基础动作辅导:纠错指导让它修正错误练习:从自主经验中不断优化、变得更强 这彻底扭转了过去机器人只会逼近 “真值” 的模仿学习模式,让机器人能从自己的错误中成长。 就连网友也直
本周,美国具身智能创业公司 Physical Intelligence(简称 PI 或 π)发布了旗下的最新机器人基础模型 π*0.6。PI 是一家总部位于旧金山的机器人与 AI 创业公司,其使命是将通用人工智能从数字世界带入物理世界:他们的首个机器人通用基础模型名为 π₀,让同一套软件控制多种物理平台执行各类任务。
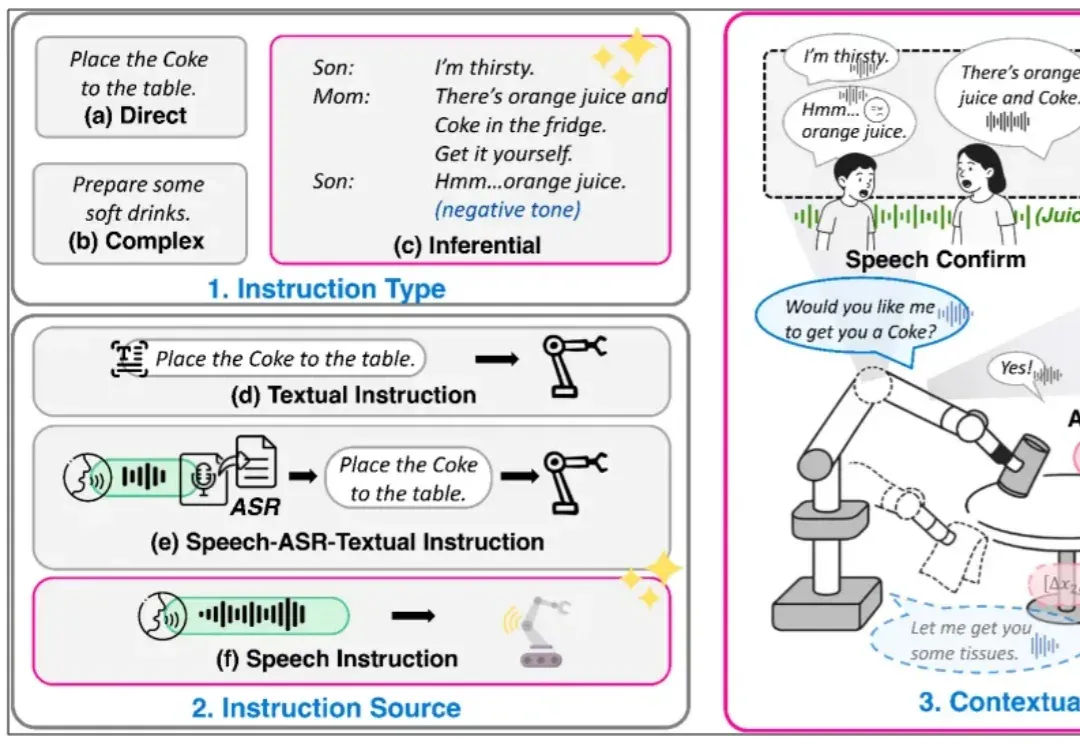
复旦⼤学、上海创智学院与新加坡国立⼤学联合推出全模态端到端操作⼤模型 RoboOmni,统⼀视觉、⽂本、听觉与动作模态,实现动作⽣成与语⾳交互的协同控制。开源 140K 条语⾳ - 视觉 - ⽂字「情境指令」真机操作数据,引领机器⼈从「被动执⾏⼈类指令」迈向「主动提供服务」新时代。
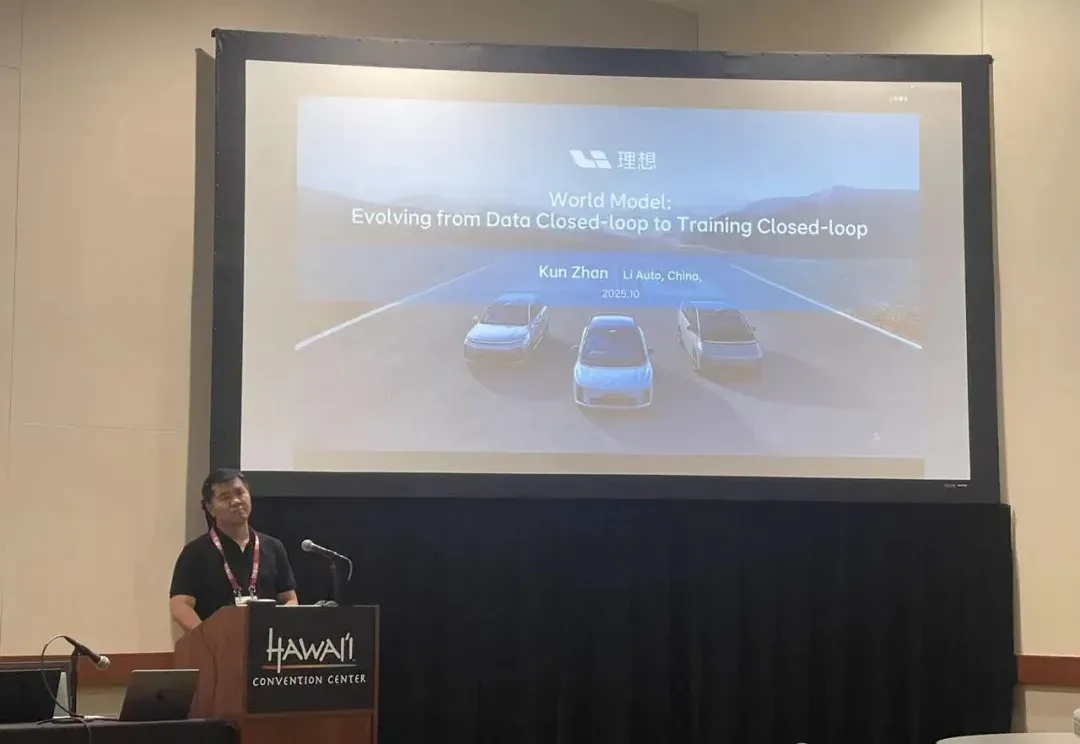
智能汽车、自动驾驶、物理AI的竞速引擎,正在悄然收敛—— 至少核心头部玩家,已经在最近的ICCV 2025,展现出了共识。
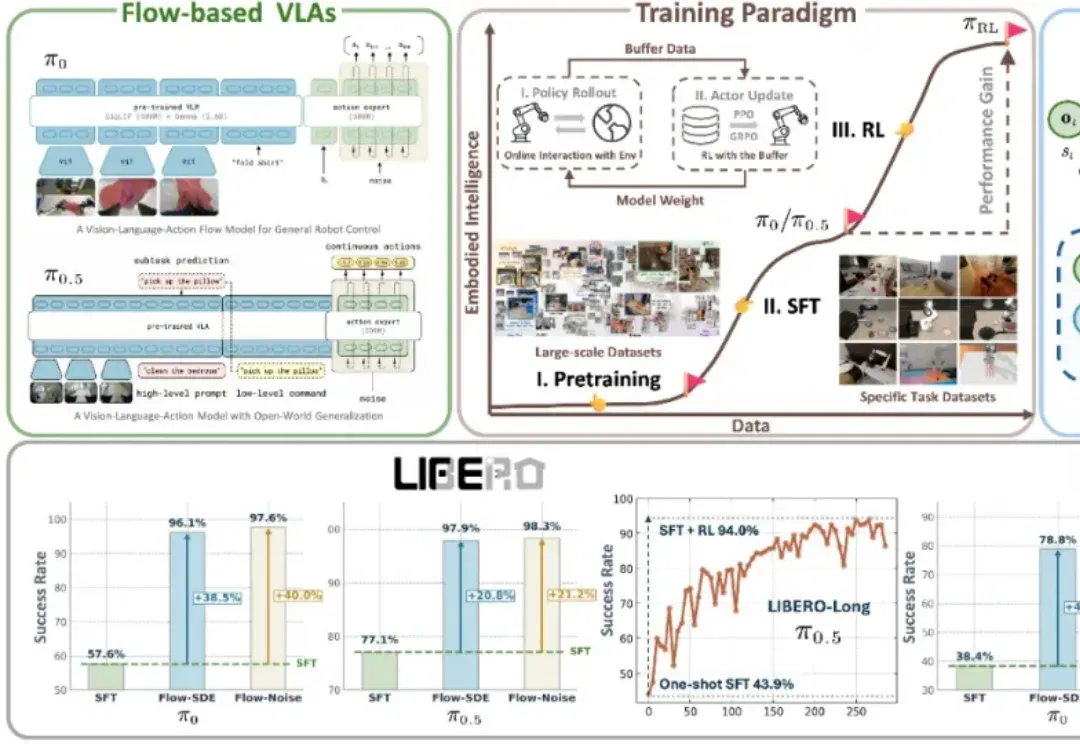
近年来,基于流匹配的 VLA 模型,特别是 Physical Intelligence 发布的 π0 和 π0.5,已经成为机器人领域备受关注的前沿技术路线。流匹配以极简方式建模多峰分布,能够生成高维且平滑的连续动作序列,在应对复杂操控任务时展现出显著优势。
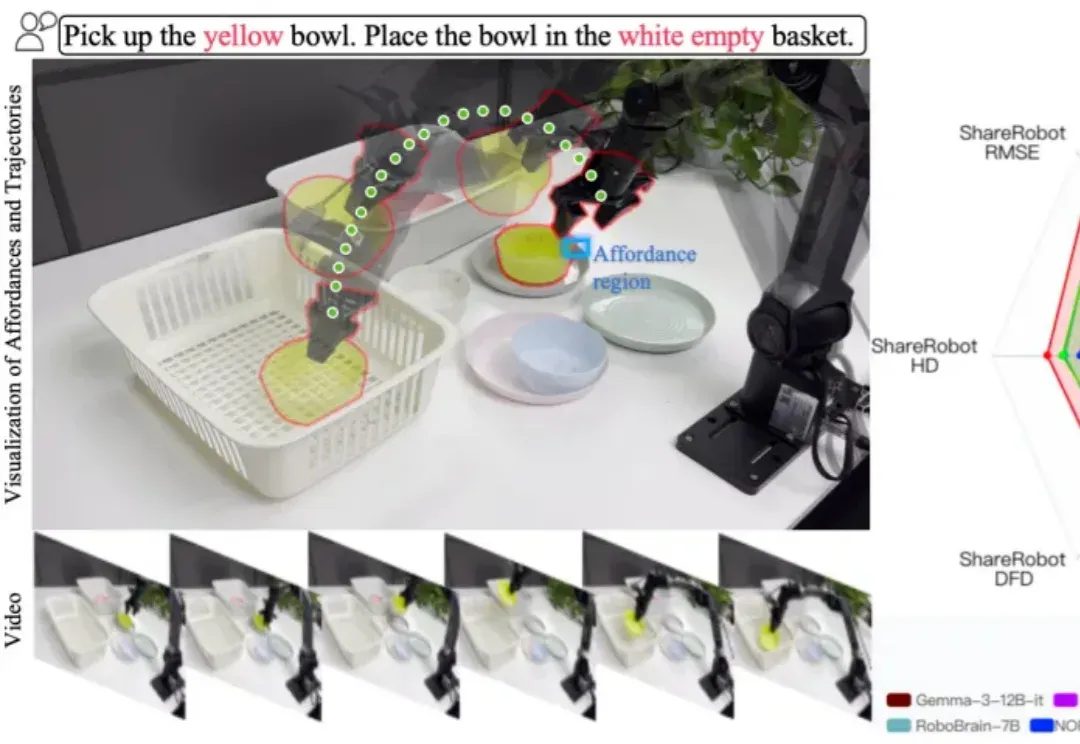
在机器人与智能体领域,一个老大难问题是:当你让机器人 “把黄碗放进白色空篮子” 或 “从微波炉里把牛奶取出来放到餐桌上” 时,它不仅要看懂环境,更要解释指令、规划路径 / 可操作区域,并把这些推理落实为准确的动作。
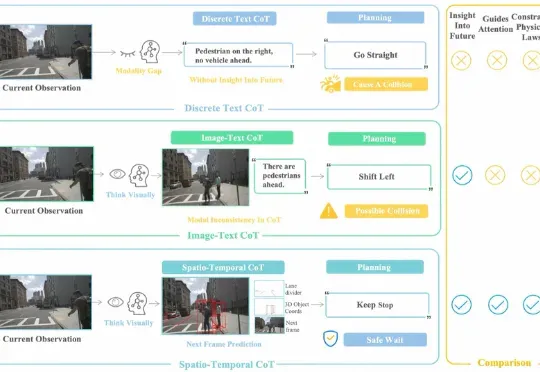
面向自动驾驶的多模态大模型在 “推理链” 上多以文字或符号为中介,易造成空间 - 时间关系模糊与细粒度信息丢失。FSDrive(FutureSightDrive)提出 “时空视觉 CoT”(Spatio-Temporal Chain-of-Thought),让模型直接 “以图思考”,用统一的未来图像帧作为中间推理步骤,联合未来场景与感知结果进行可视化推理。
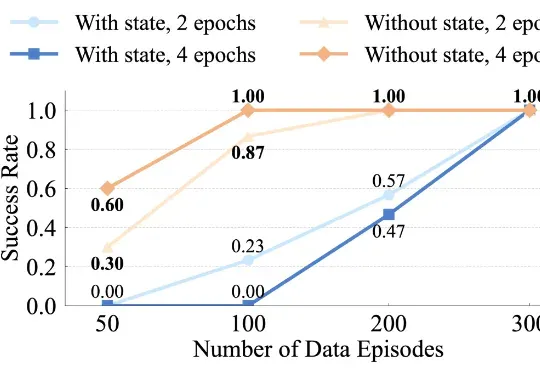
最近,千寻智能的研究人员注意到,基于模仿学习的视觉运动策略中也存在类似现象,并在论文《Do You Need Proprioceptive States in Visuomotor Policies?》中对此进行了深入探讨。