MiniMax M2.1 首发评测:专治祖传屎山,这种爽感谁用谁懂 (opens in a new tab)
要说这两天AI圈最火的一条消息,莫过于MiniMax正式通过港交所聆讯,即将冲刺IPO。
Total 289 articles
要说这两天AI圈最火的一条消息,莫过于MiniMax正式通过港交所聆讯,即将冲刺IPO。
MiniMax海螺视频团队不藏了!首次开源就揭晓了一个困扰行业已久的问题的答案——为什么往第一阶段的视觉分词器里砸再多算力,也无法提升第二阶段的生成效果?翻译成大白话就是,虽然图像/视频生成模型的参数越做越大、算力越堆越猛,但用户实际体验下来总有一种微妙的感受——这些庞大的投入与产出似乎不成正比,模型离完全真正可用总是差一段距离。
刚刚,上海大模型独角兽MiniMax,正式通过港交所聆讯,吹响了IPO冲刺号角。但直到招股书披露,更重要的资本吸引力原因才完全明确——不仅因为全模态能力全球领先,更关键的是,累计花费只用了5亿美元,不到OpenAI的1%。
12月21日,全球通用人工智能(AGI)公司MiniMax(稀宇科技)首次刊发其聆讯后资料集(PHIP)版本的招股书资料,有望刷新记录,成为从成立到IPO 历时最短的AI公司,标志着中国力量在国际资本市场迈出关键一步。
MiniMax 海螺视频团队「首次开源」了 VTP(Visual Tokenizer Pre-training)项目。他们同步发布了一篇相当硬核的论文,它最有意思的地方在于 3 个点:「重建做得越好,生成反而可能越差」,传统 VAE 的直觉是错的
当整个 AI 圈都在为 DAU(日活跃用户数)和融资额焦虑时,MiniMax 创始人闫俊杰却表现出一种近乎冷酷的淡漠。
前沿AI竞赛在2025年11月达到高潮。48小时内,谷歌推出Gemini 3 Pro宣称在主要推理基准测试中领先,而OpenAI立即用GPT-5.1-Codex-Max反击,这是一款专门训练用于通过创新"压缩"(compaction)技术自主工作超过24小时的专业编码模型[43]。加上Claude Sonnet 4.5已确立的编码统治地位和激进的安全过滤器,开发者面临前所未有的选择:
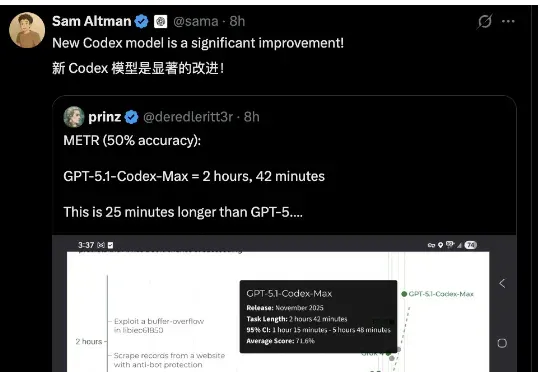
Gemini 3力压全场,OpenAI坐不住了。发布Codex新版本——GPT-5.1-Codex-Max,突破上下文窗口限制,实现跨越数百万token的长时间连续工作,最长超过24小时的那种。
正好上周(10月27日),MiniMax 公司发布了[2] M2 模型,代表了国产大模型的最新水平。我就想,可以测测它的实战效果,跟智谱公司的 GLM 4.6 和 Anthropic 公司的 Claude Sonnet 4.5 对比一下。毕竟它们都属于目前最先进的编程大模型,跟我们开发者切身相关。
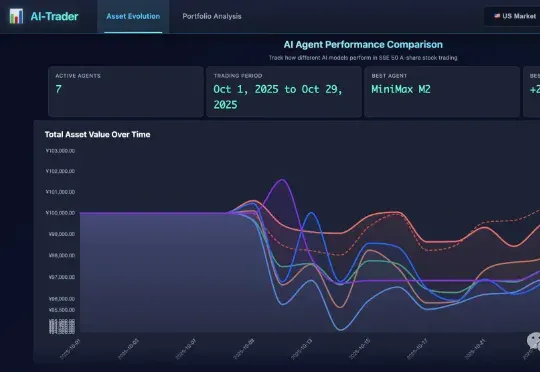
屠榜开源大模型的MiniMax M2是怎样炼成的?为啥M1用了Linear Attention,到了M2又换成更传统的Full Attention了? 面对现实任务,M2表现得非常扛打,在香港大学的AI-Trader模拟A股大赛中拿下了第一名,20天用10万本金赚了将近三千元。