新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分 (opens in a new tab)
Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。
Total 165 articles
Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。
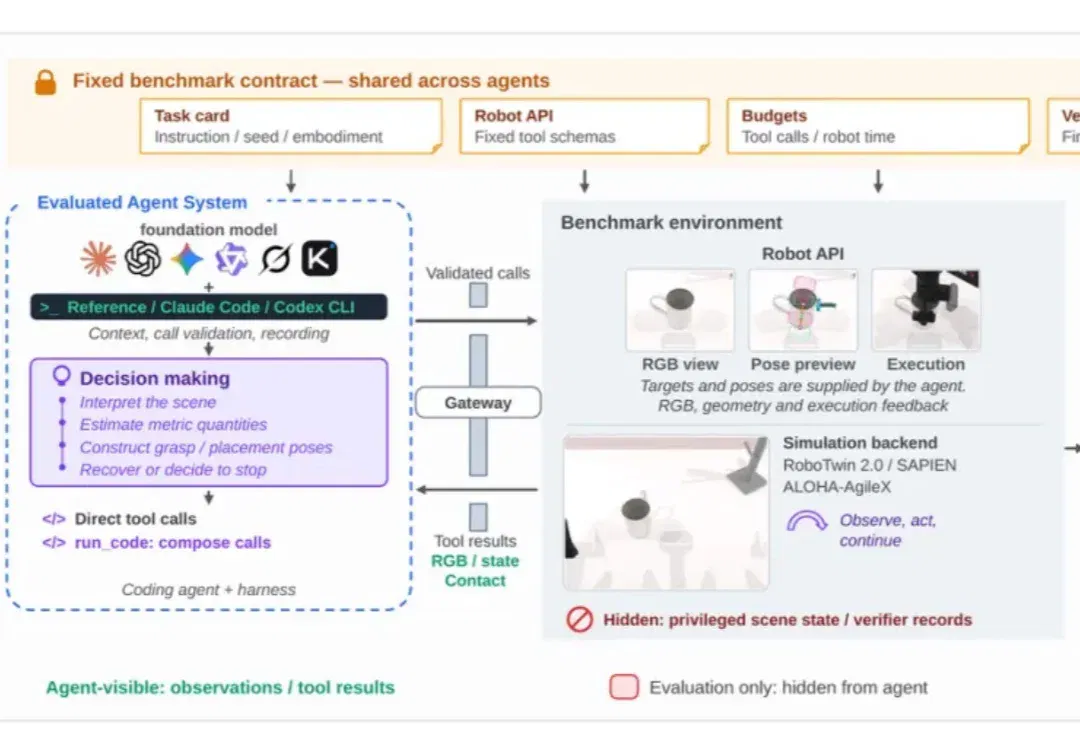
从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。
这在这几天,数学家、极客和成群的AI智能体,展开了一场震撼的接力。
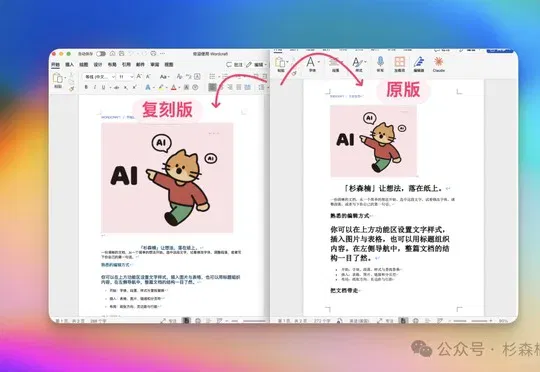
作者借助 GitHub 项目 REA 和 Codex GPT-6 Astra,在没有源代码的情况下迭代复刻 Microsoft Word,核心功能与界面高度还原,显示 AI 正显著降低成熟软件复刻门槛。
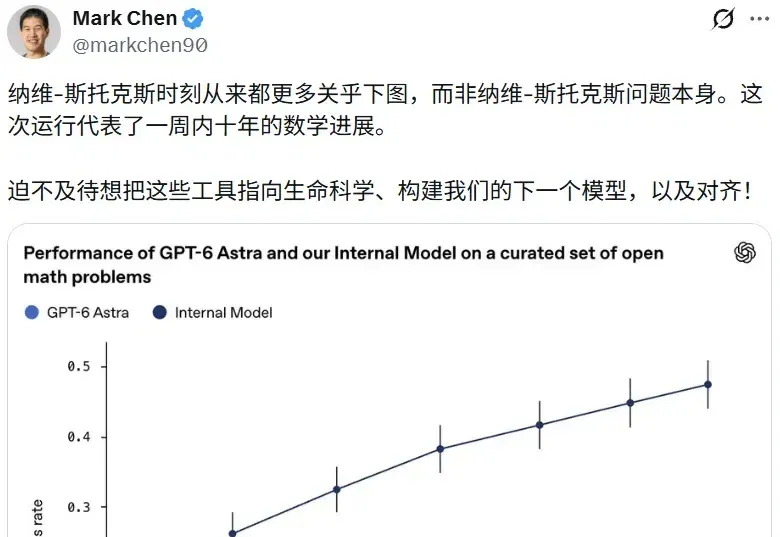
前些时日,OpenAI 在 GitHub 上一口气放出了 722 篇数学论文手稿。这些手稿被归为 372 个结果「家族」,横跨 17 个数学领域,全部出自一个尚未发布、也没有公开名字的内部模型——其性能远胜 GPT-6 Astra。
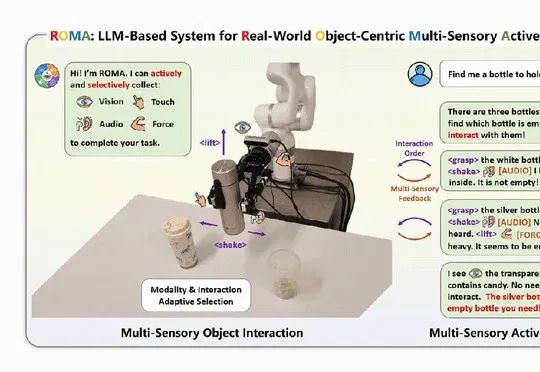
人大高瓴 GeWu-Lab、智源研究院与燧行 AresoX 等机构提出 ROMA,构建 ROMI-2K、ROMA Bench 及 ROMA-7B,使机器人融合视听触力主动探索物体,并在 ROMA Bench 上以 72.9% 总体任务成功率基本追平 GPT-6 Astra。
OpenAI开启Codex“疯狂28天”计划,首日宣称将GPT-6 Astra和GPT-6.1 Sol默认推理速度提升约50%至50TPS,但用户实测低于预期,叠加ChatGPT测试广告、欧盟文本隐形水印及订阅调整引发质疑。
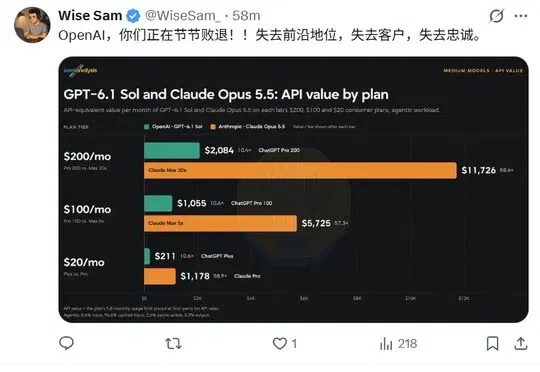
OpenAI将订阅用户使用GPT-6 Astra和GPT-6.1 Sol的速度提升约50%,但SemiAnalysis实测称Anthropic订阅的API等价价值约为OpenAI的5倍,OpenAI 200美元套餐额度也已减半。
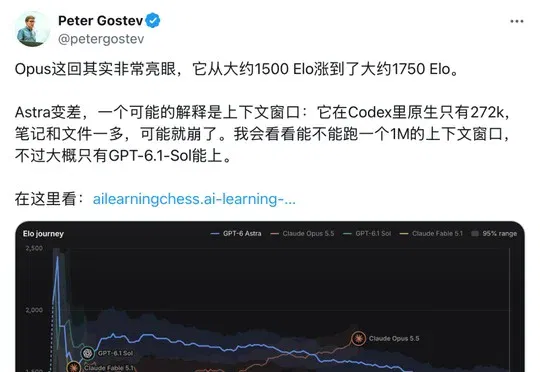
大模型竞技场Arena让Claude Opus 5.5与GPT-6 Astra各自练棋200局,前者估算评分从约1500升至1760,后者从第29盘的1810降至1400,显示AI仅靠记录与复盘提升能力的表现并不一致。
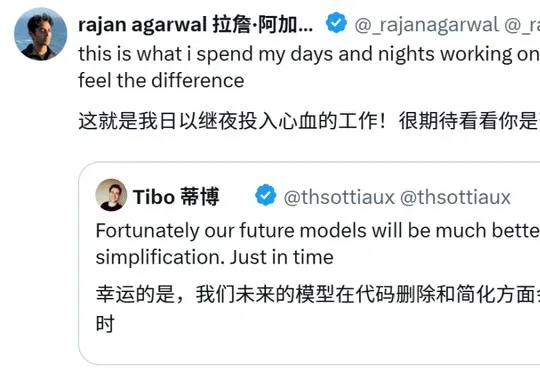
OpenAI 开发者日才过去了 5 天,Tibo 又来预告下一代模型了。这一次,他们终于打算管管模型写出来的屎山代码了。不久前,OpenAI 产品负责人 Tibo Sottiaux 发帖称,未来的模型会更擅长删除和简化代码。