打破代码大模型训练瓶颈:微软&剑桥&普林推出MicroCoder,算法、数据、框架、训练经验全面升级 (opens in a new tab)
新一代代码模型的训练动态已与旧模型截然不同,主流强化学习方法和数据集在其上几乎“失效”。
Total 164 articles
新一代代码模型的训练动态已与旧模型截然不同,主流强化学习方法和数据集在其上几乎“失效”。
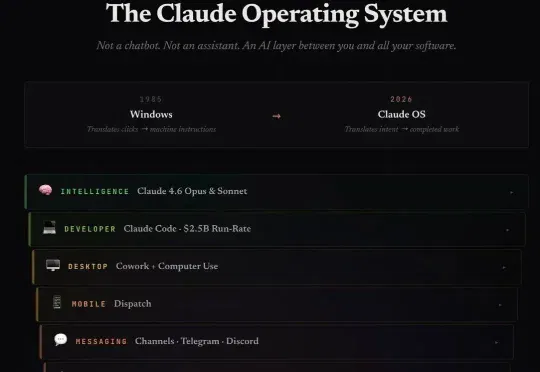
Anthropic的野心曝光了!有人分析称:他们在悄然打造一个AI操作系统,意图统治全球数字生态,做一个统治一切生态的龙虾大脑!这背后,剑指的就是苹果微软的6.4万亿帝国,而OpenAI甚至还排不上号。
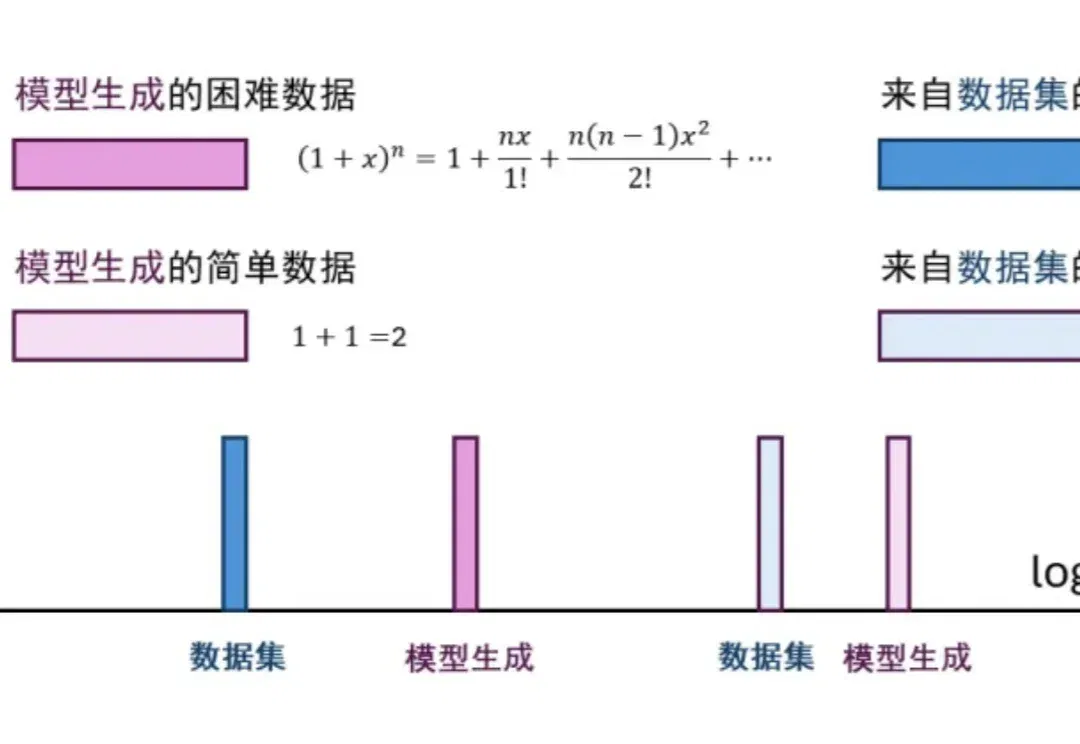
在大模型后训练阶段,监督微调(SFT)和强化学习(RL)是两根不可或缺的支柱。SFT 利用高质量的离线(Off-policy)数据快速注入知识,但受限于静态数据分布,泛化能力往往容易触及天花板并带来灾难性遗忘;RL 则允许模型在探索中不断自我迭代,产生与当前策略同分布(On-policy)的数据,上限极高,但往往伴随着训练极度不稳定、计算资源消耗巨大的痛点。
砸了724亿美金「学费」后,微软用一场大重组承认 Copilot「走弯路」了。
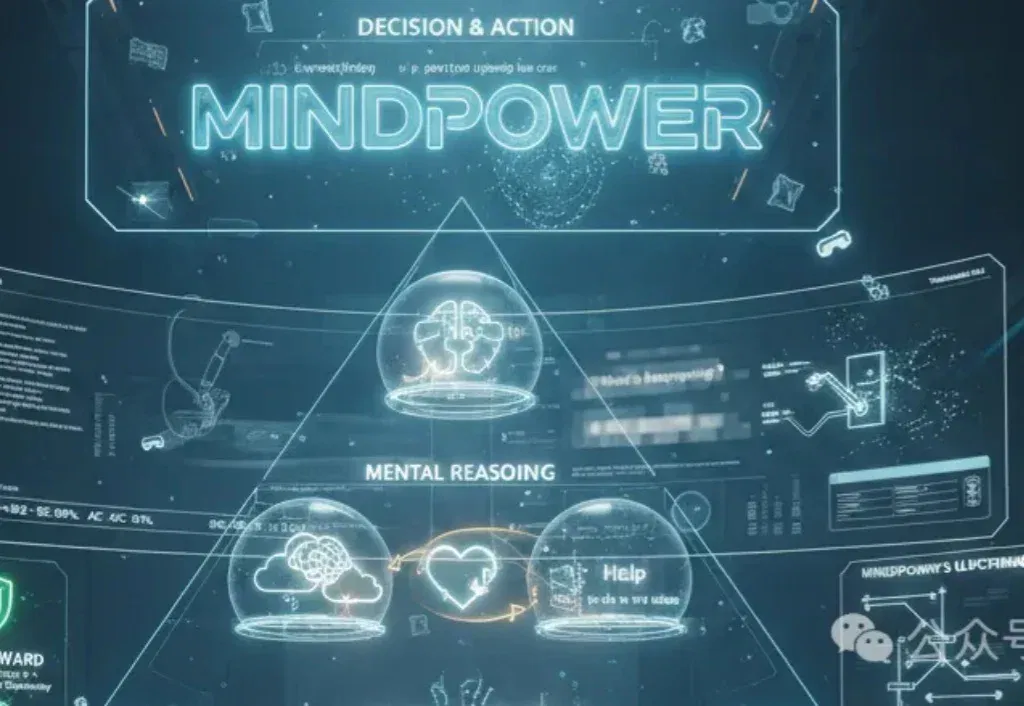
吉林大学&微软亚洲研究院等团队提出MindPower框架,让机器人像人一样理解他人想法并主动帮忙,构建了首个以机器人为中心的心智推理评测体系,通过六层推理链条,让AI不仅看懂场景,更能推断意图、做出决策、执行动作,显著提升助人能力。
跨文件记忆革命:单一对话同时操控多个Excel工作簿+PowerPoint幻灯片,数据从表格直飞演示文稿,无缝迁移零解释,Anthropic把AI Agent玩明白了。
深夜,谷歌官宣重磅更新!Gemini全面接管Docs、Sheets、Slides,AI原生办公时代来了,全球30亿谷歌用户的办公方式,或正在被彻底颠覆。
随着大语言模型 Agent 开始在对话、问答与复杂交互环境中长期运行,“记忆该如何设计” 正在成为一个绕不开的核心问题。
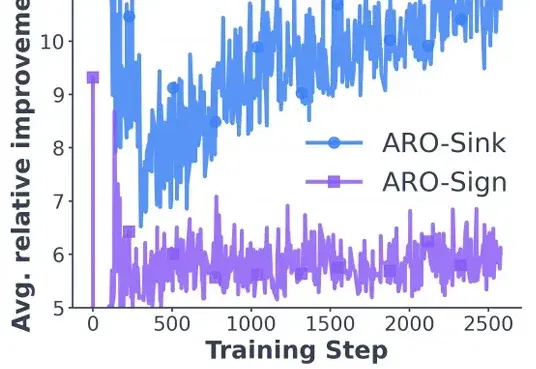
如果你在过去一年关注过大模型训练的技术,大概率听过 Muon 这个名字 —— 这个在月之暗面 K2 模型的相关讨论中走红的优化器,被视为是可能挑战 Adam 的新秀。它的思路很直接:对动量矩阵进行正交化,让各个奇异方向上的更新速率一致,提升训练效率。
最近有一个感觉越来越强烈,自己正在做的这份工作,可能是最后一代需要人来做的职业。 2026 刚开年,科技圈的裁员消息就没停过。英特尔裁了 21000 人,戴尔裁了 12000 人,微软裁了 15000