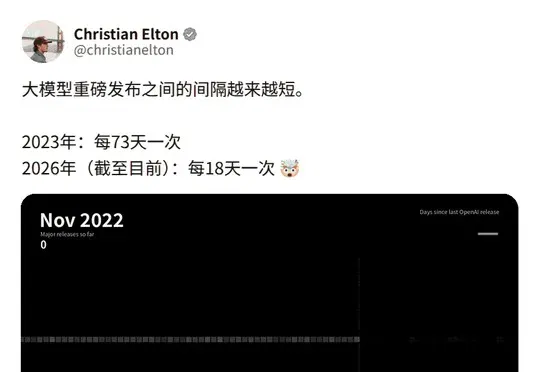
平均6天一个新旗舰!大模型更新快到人类跟不上了 (opens in a new tab)
OpenAI、Anthropic及国内十家主要大模型厂商平均每6天推出一款新旗舰模型,AI已大规模参与下一代模型研发,导致模型迭代速度首次超过人类适应速度,开发者调好的提示词和参数频繁面临报废。
Total 1517 articles
OpenAI、Anthropic及国内十家主要大模型厂商平均每6天推出一款新旗舰模型,AI已大规模参与下一代模型研发,导致模型迭代速度首次超过人类适应速度,开发者调好的提示词和参数频繁面临报废。
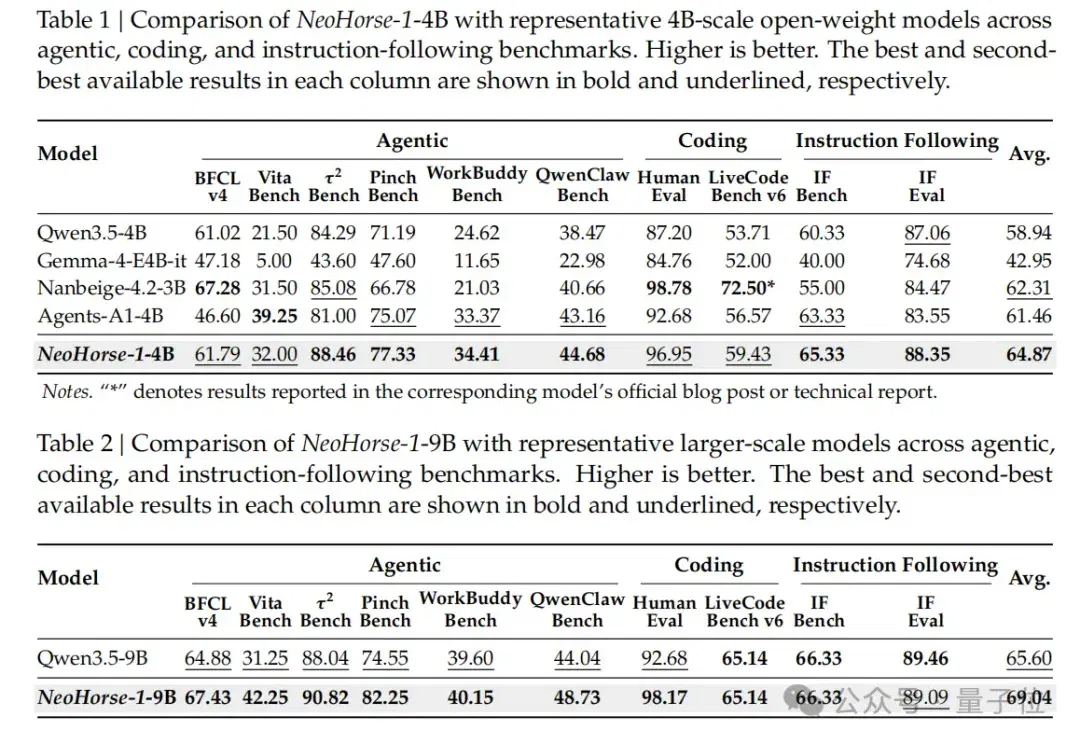
王云鹤创业后,首次交卷了大模型成果。 量子位获悉,华为诺亚方舟实验室前主任、盘古大模型负责人王云鹤创办的基元律动,发布首个Agent-Native模型NeoHorse。 该模型由无问芯穹提供底层基础设施支撑与Infra优化技术能力,清华大学、北京大学团队参与算法和训练方法研究,共同探索提升Agent后训练的数据利用效率和训练效果。 NeoHorse-1包含4B和9B两个版本,重点面向Agent工作过程中需要的一组能力,包括调用工具、读取环境反馈、发现错误、调整路径,并最终完成任务。 在覆盖Harness Agent、工具使用、代码和指令遵循等10项评测中,经过Agentic Post-Trai
沙特人工智能公司HUMAIN基于中国MiniMax的开源旗舰模型MiniMax M3推出阿拉伯语大模型HUMAIN M3,使用超过1万亿Token阿拉伯语数据进行后训练,在七项阿拉伯语基准测试中等权平均分达89.37%,标志着中国开源模型正成为全球AI生态的底层技术基础。
今日,蚂蚁百灵大模型开源了一款轻量级混合推理MoE模型——Ling-3.0-tiny。该模型总参数量为7.9B,推理时激活参数量为1.3B,主要面向高效本地部署而设计。其同步提供BF16、FP8和INT4三个版本,已在DGX Spark、MacBook、Mac mini等设备上完成验证,兼顾性能、效率与可部署性。
今天,英国《金融时报》援引知情人士报道,字节跳动正在训练一个参数量高达10万亿的AI模型。而这一数字,在昨日晚间的晚点LatePost独家报道中还是“超5万亿”。即使是5万亿,这一模型的规模也已经超过目前中国已发布的最大模型Kimi K3,接近Anthropic的Fable 5;如果是10万亿,那字节的新模型规模将超越约有8万亿参数的Mythos 5。
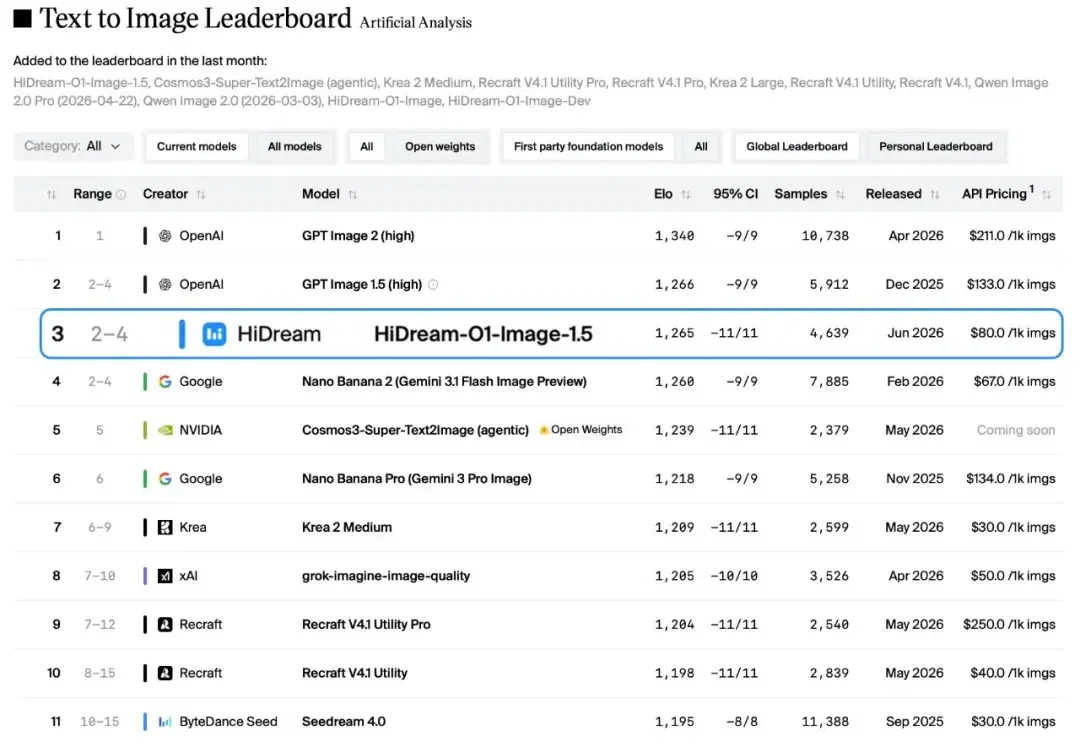
文生图的"慢思考",到底有没有用? “8B 开源版是一扇窗,真正的风景还在 200B+ 参数的 Pro 版本之后。” 智象未来 HiDream-O1-Image 开源版(8B)发布之后,我在测评最后留下了这样一句判断。前者以 Peanut 匿名登上 AA 榜、拿下文生图开源模型全球第一的事迹犹在眼前,今天 1.5 闭源版本又和公众见面了。 珠玉在前,HiDream-O1-Image-1.5 可以说是备受瞩目,而智象未来的官方口径很大程度上回应了这种期待:“连续登顶不仅印证了智象未来在图像生成大模型上的硬核实力,更标志着公司已稳居全球视觉生成大模型的第一梯队”。 看过 1.5 版本在 Artif
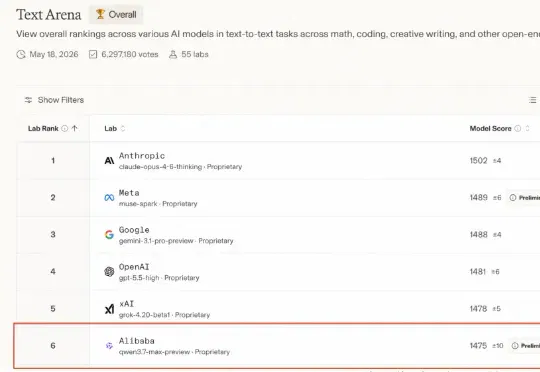
仅仅一个月后,阿里又带着最强旗舰模型杀回来了!今天上午,在 2026 阿里云峰会上,阿里全新一代千问旗舰模型 Qwen3.7-Max 登场了!在 Arena 公布的最新一期全球大模型盲测总榜中,Qwen3.7-Max 总成绩位列国产模型第一:傲视一众国产大模型
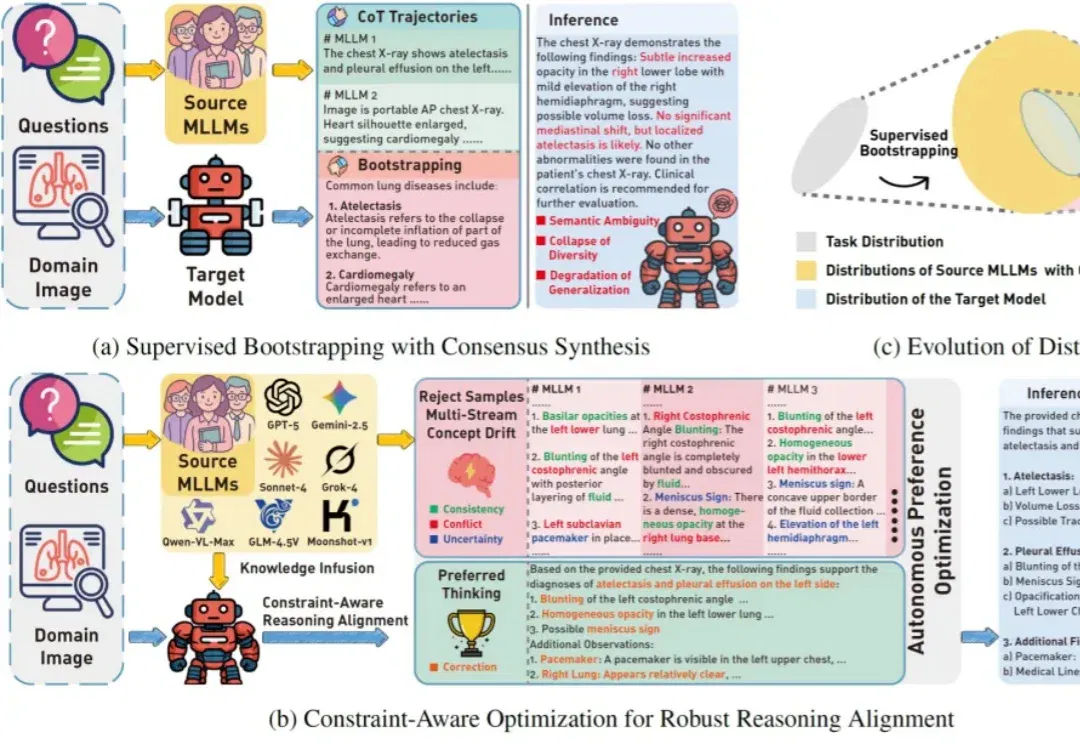
在多模态大模型(MLLM)快速发展的浪潮中,融合多模型 “集体智慧” 已成为提升模型性能的关键路径,并催生了多教师知识蒸馏这一主流范式。然而,不同来源的教师模型在架构与优化上的差异,其在相似推理过程中呈现出不稳定甚至偏移的认知轨迹,即 “概念漂移”(Concept Drift)。
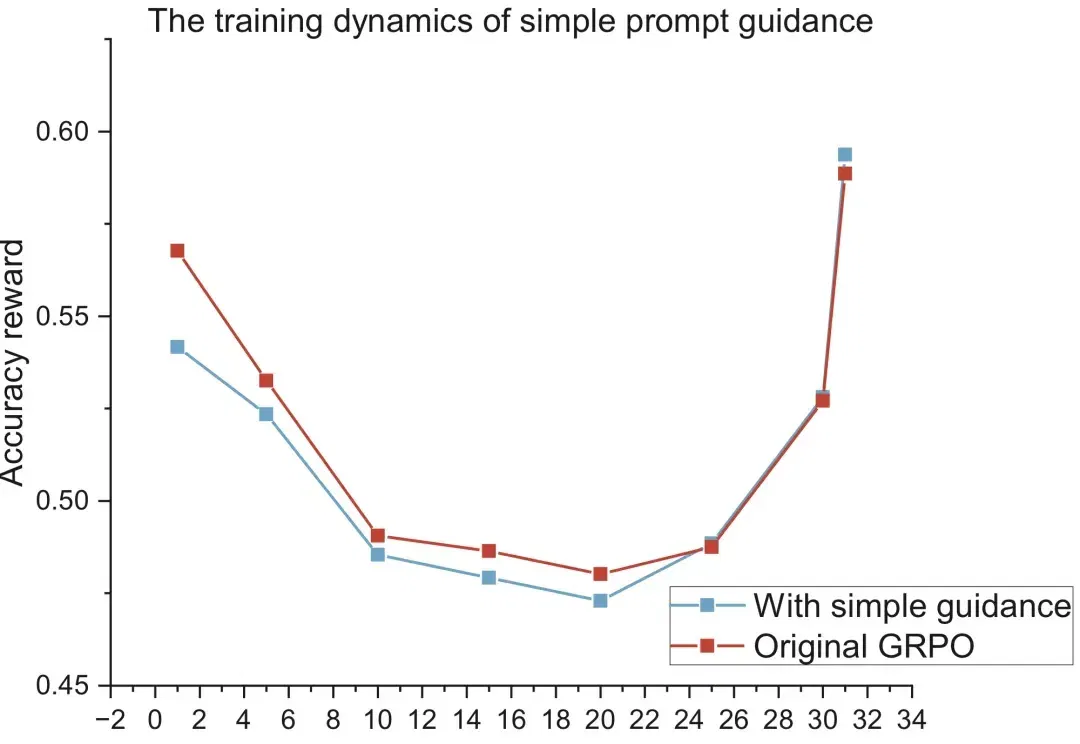
大模型时代的「炼金术师」们,或许都曾面临一个共同的困扰:当我们试图将 DeepSeek-R1、OpenAI-o1 那种惊艳的推理能力迁移到小规模语言模型(SLMs)时,效果却总是差强人意。现有的强化学习方法如 GRPO 在 7B+ 的大模型上效果显著,但一旦应用到 1.7B 甚至更小参数的模型上,性能提升就微乎其微。
极佳视界具身大模型 GigaBrain-0.5M*,以世界模型预测未来状态驱动机器人决策,并实现了持续自我进化,超越π*0.6 实现 SOTA!该模型在叠衣、冲咖啡、折纸盒等真实任务中实现接近 100% 成功率;相比主流基线方法任务成功率提升近 30%;基于超万小时数据训练,其中六成由自研世界模型高保真合成。