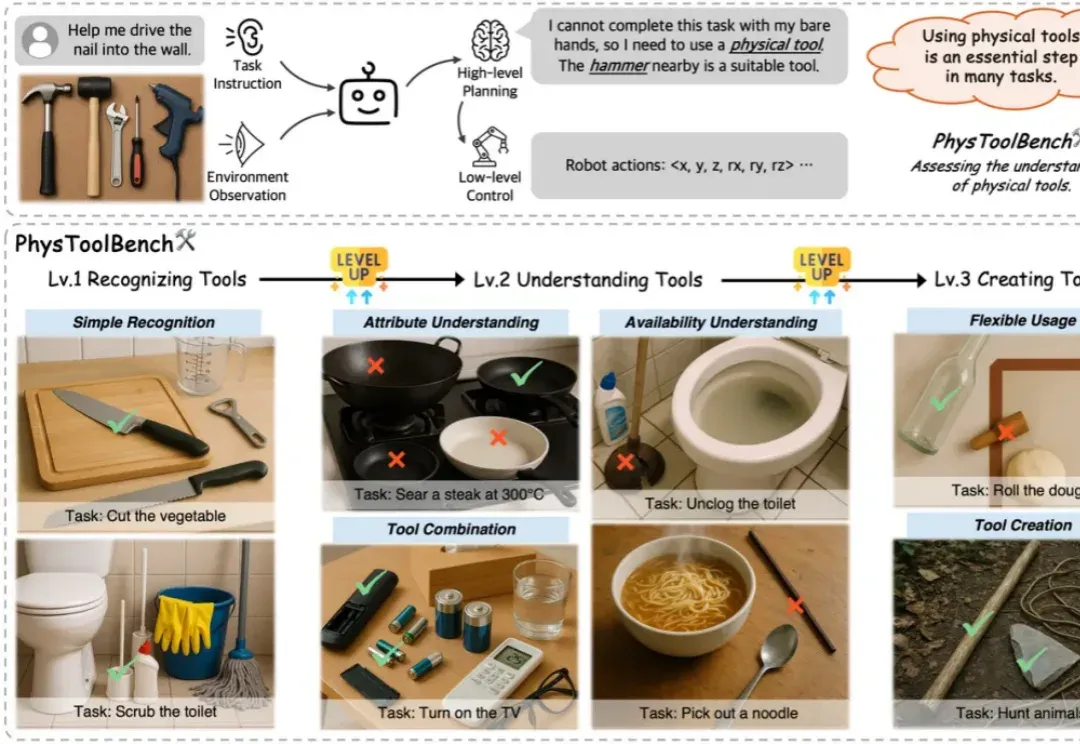
多模态大模型理解物理工具吗?PhysToolBench提出了衡量多模态大模型对物理工具理解的基准 (opens in a new tab)
人类之所以能与复杂的物理世界高效互动,很大程度上源于对「工具」的使用、理解与创造能力。对任何通用型智能体而言,这同样是不可或缺的基本技能,对物理工具的使用会大大影响任务的成功率与效率。
Total 438 articles
人类之所以能与复杂的物理世界高效互动,很大程度上源于对「工具」的使用、理解与创造能力。对任何通用型智能体而言,这同样是不可或缺的基本技能,对物理工具的使用会大大影响任务的成功率与效率。
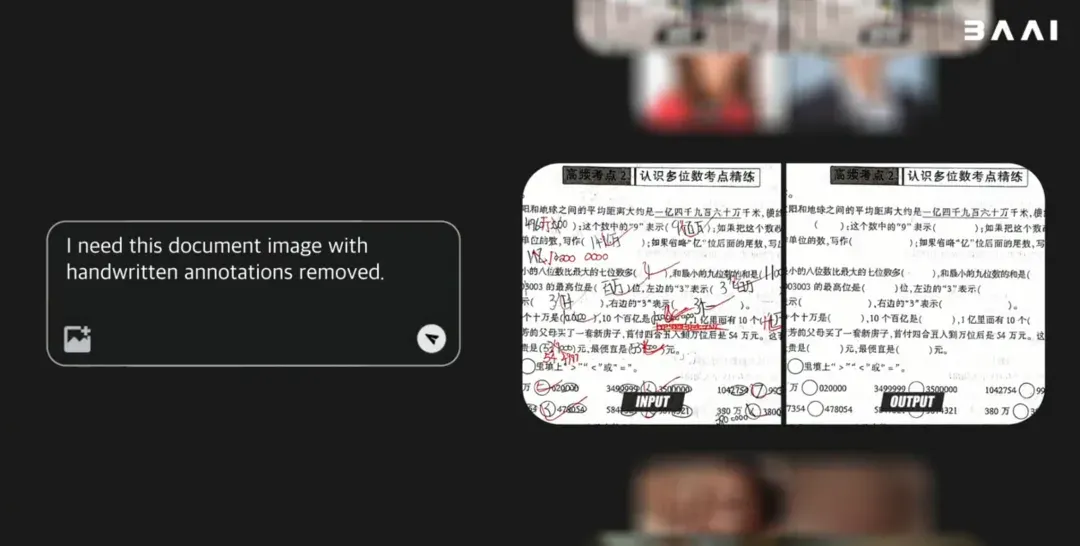
最新最强的开源原生多模态世界模型—— 北京智源人工智能研究院(BAAI)的悟界·Emu3.5来炸场了。 图、文、视频任务一网打尽,不仅能画图改图,还能生成图文教程,视频任务更是增加了物理真实性。
今天,北京智源人工智能研究院(BAAI)重磅发布了其多模态系列模型的最新力作 —— 悟界・Emu3.5。这不仅仅是一次常规的模型迭代,Emu3.5 被定义为一个 “多模态世界大模型”(Multimodal World Foudation Model)。
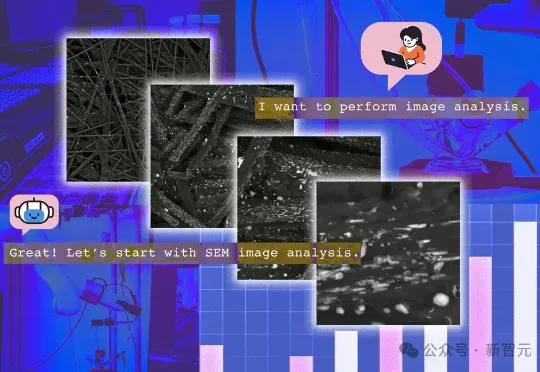
美国麻省理工学院李巨团队在国际顶尖学术期刊Nature上发表了一篇研究论文,展示了一种多模态机器人平台CRESt(Copilot for Real-world Experimental Scientists),通过将多模态模型(融合文本知识、化学成分以及微观结构信息)驱动的材料设计与高通量自动化实验相结合,大幅提升催化剂的研发速度和质量。

多模态大模型首次实现像素级推理,指代、分割、推理三大任务一网打尽!
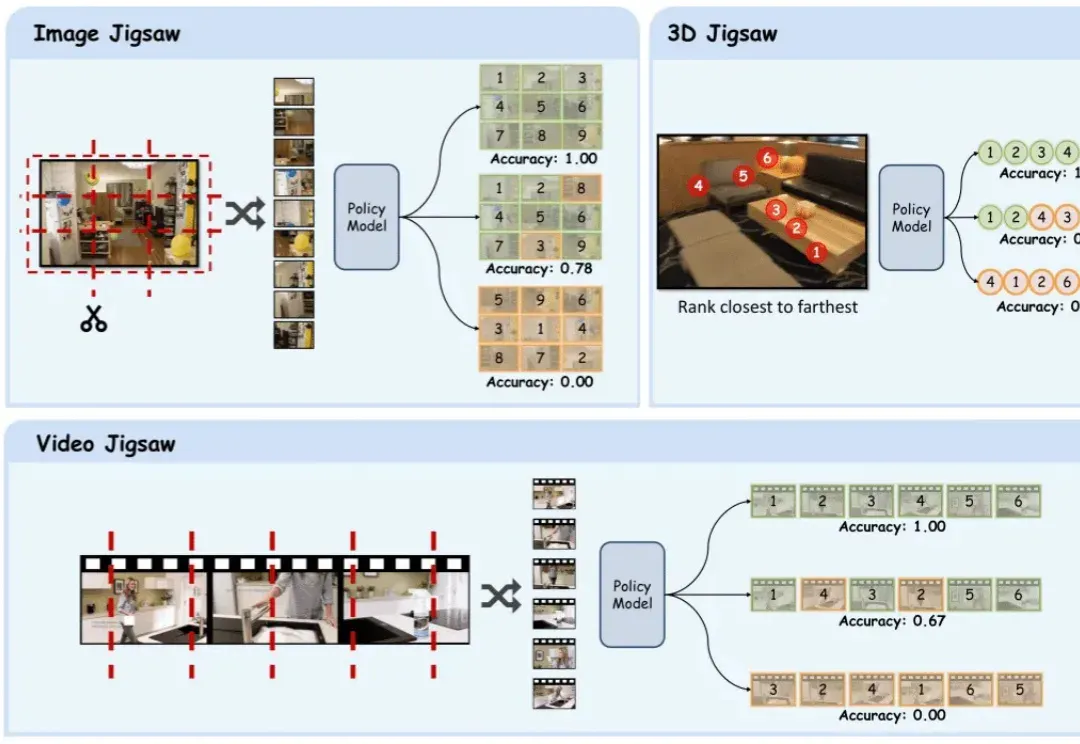
在多模态大模型的后训练浪潮中,强化学习驱动的范式已成为提升模型推理与通用能力的关键方向。
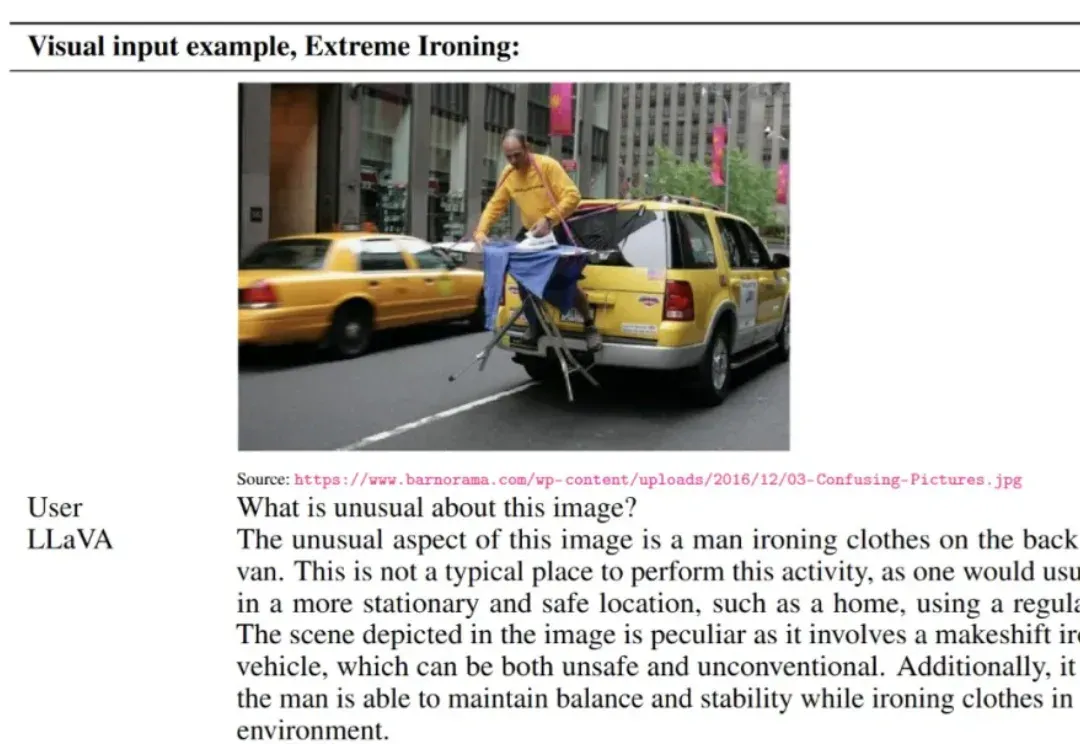
LLaVA 于 2023 年提出,通过低成本对齐高效连接开源视觉编码器与大语言模型,使「看图 — 理解 — 对话」的多模态能力在开放生态中得以普及,明显缩小了与顶级闭源模型的差距,标志着开源多模态范式的重要里程碑。
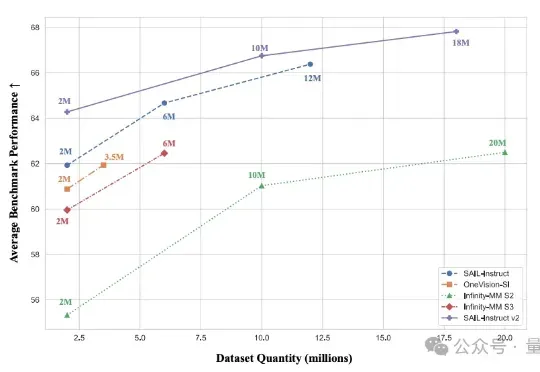
2B模型在多个基准位列4B参数以下开源第一。 抖音SAIL团队与LV-NUS Lab联合推出的多模态大模型SAIL-VL2。
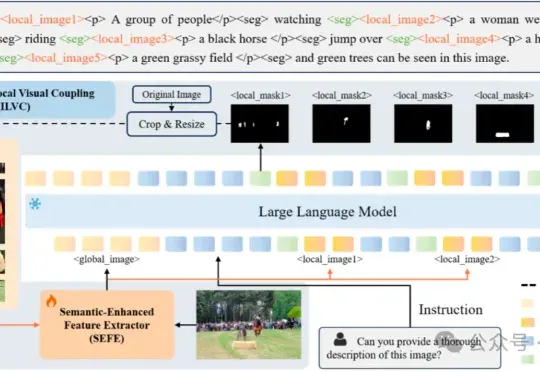
多模态大模型需要干的活,已经从最初的文生图,扩展到了像素级任务(图像分割)。
由华中科技大学与小米汽车提出了业内首个无需 OCC 引导的多模态的图像 - 点云联合生成框架 Genesis。该算法只需基于场景描述和布局(包括车道线和 3D 框),就可以生成逼真的图像和点云视频。