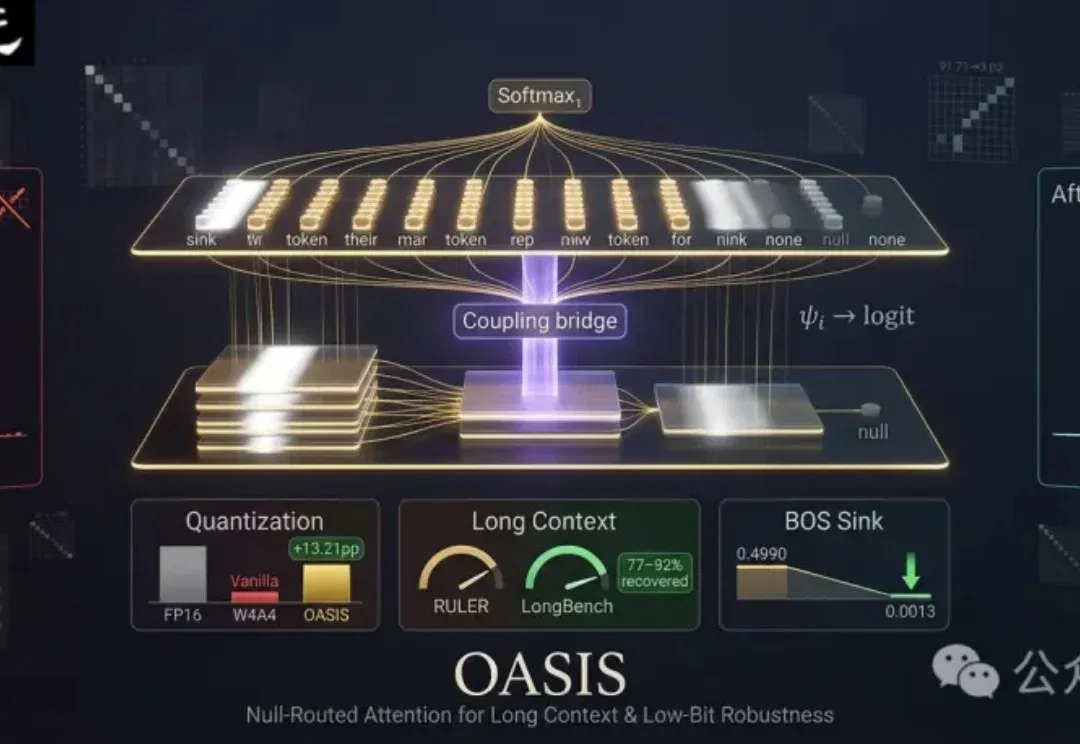
NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性 (opens in a new tab)
增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
Total 348 articles
增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
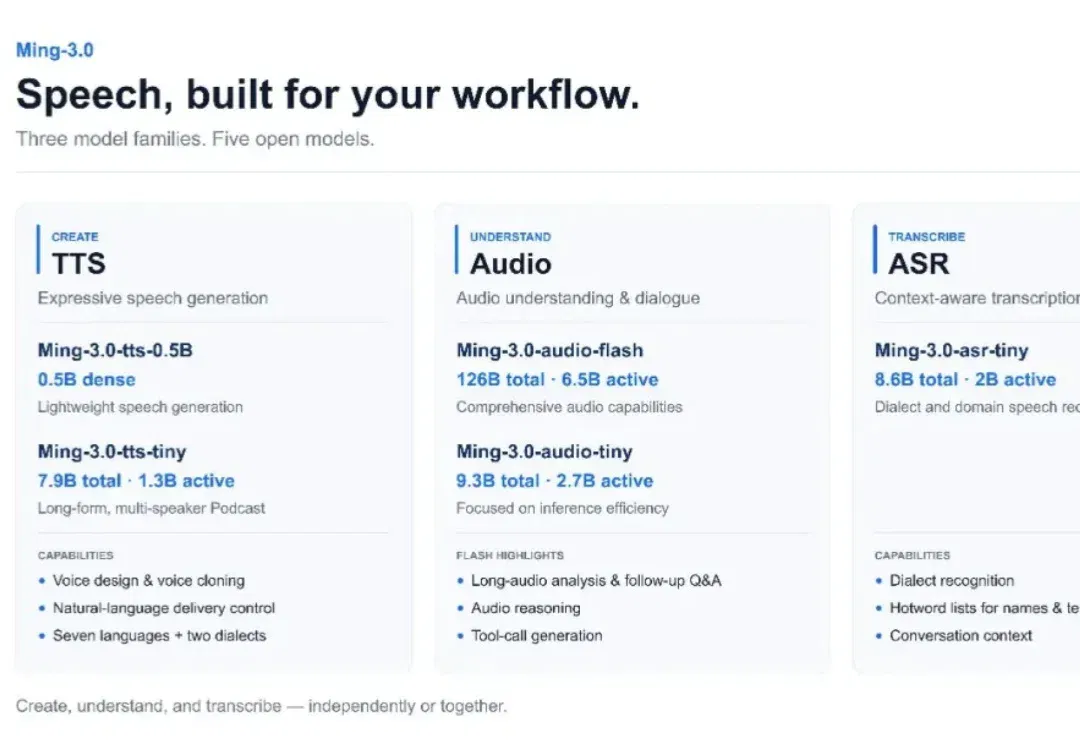
配音、听录音、转写全覆盖。 智东西10月20日报道,今日,蚂蚁百灵开源Ming-3.0语音系列模型,共包含用于语音合成、音频理解与对话、语音识别的五款模型,重点支持音色与台词表演控制、长音频分析与连续问答,以及结合热词和对话上下文的语音识别。 具体来看,语音合成系列包含Ming-3.0-tts-0.5B、Ming-3.0-tts-tiny,其中tiny版本还支持长篇多角色播客生成;音频理解与对话系列包含Ming-3.0-audio-flash、Ming-3.0-audio-tiny,面向会议、访谈等录音分析场景;语音识别模型为Ming-3.0-asr-tiny,支持中英文及方言转写。 此次发布
Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。
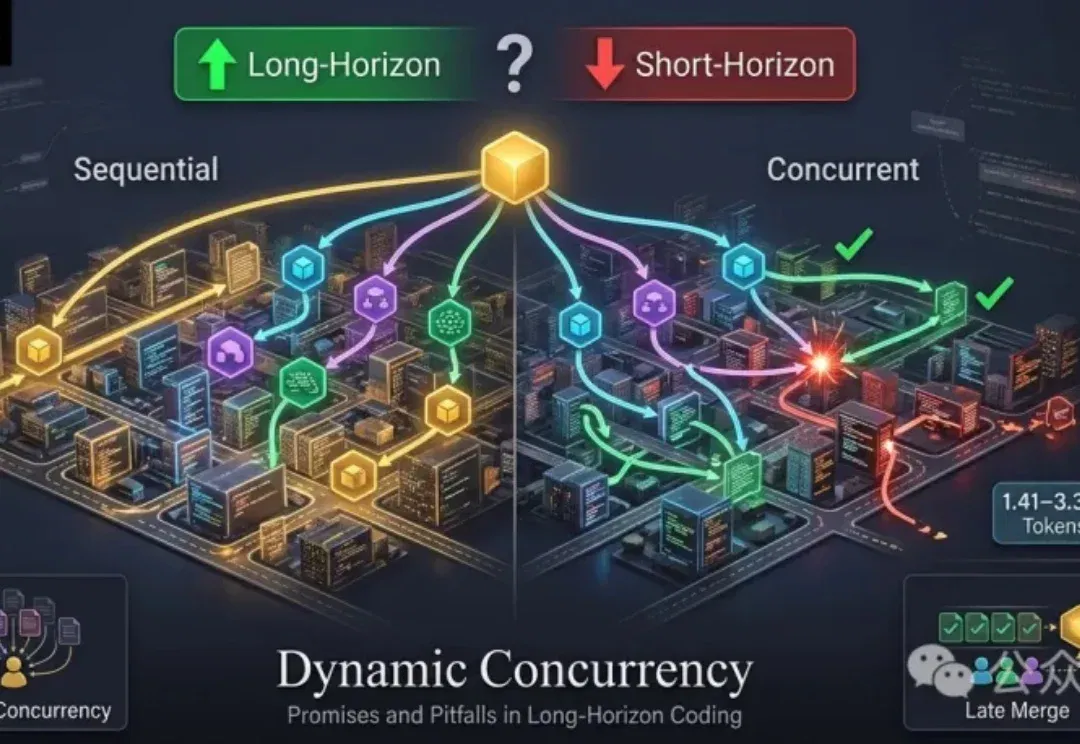
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
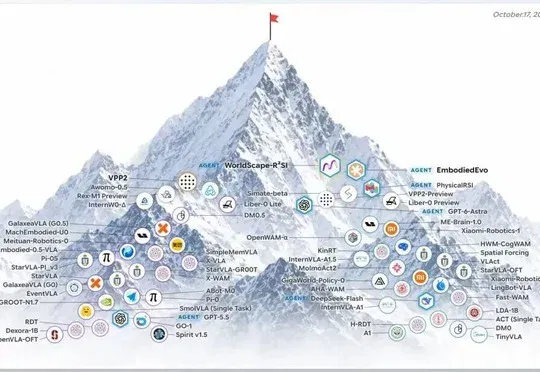
Manifold AI推出WorldScape R²SI,通过上下文学习与双层Agent持续改进能力登顶RoboDojo Agent Track总榜,超过GPT-6-Astra等模型。
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
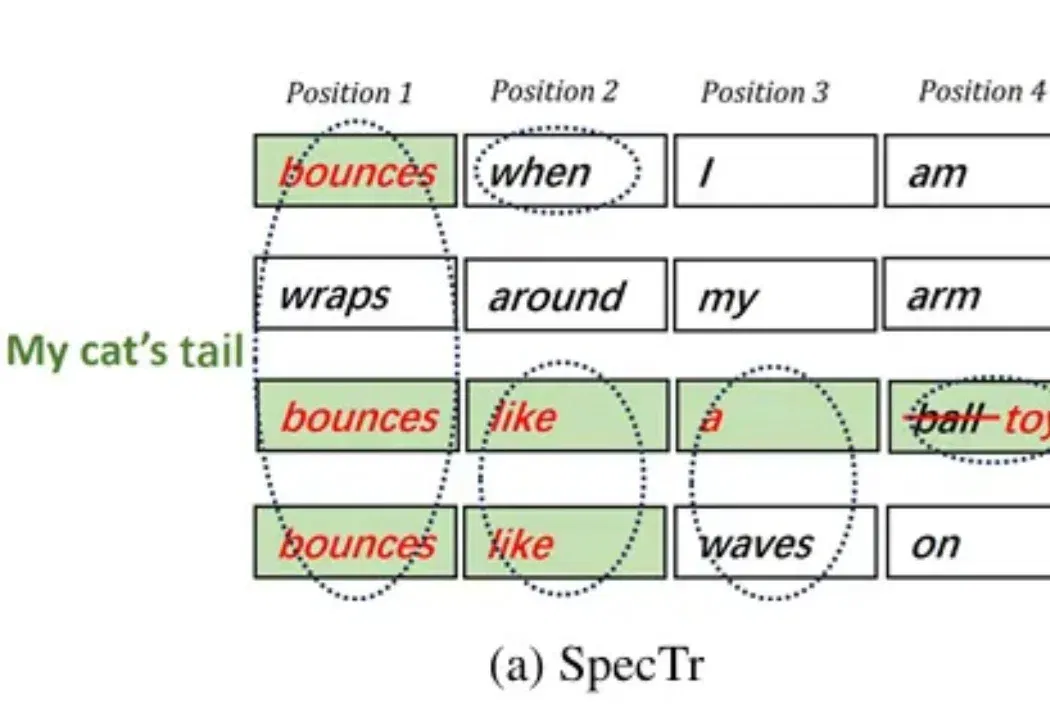
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
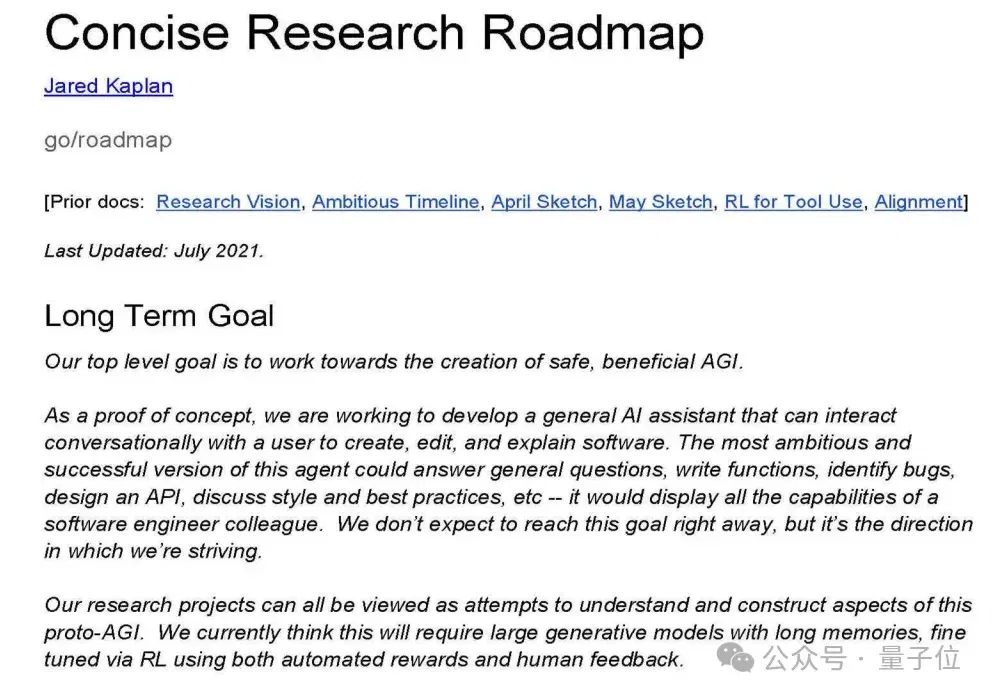
不er,A\你穿越回来的啊?? 因为一起版权官司,Anthropic一份2021年7月的内部研究路线图,意外曝光。 很短,PDF正文就两三页。 但把这份当时标着「最高机密」的文件从头读到尾,我瘫软了(bushi)。 今天的Claude Code、工具调用(Tool Use)、AI自我评判(Self-Judging)、测试时计算(Test-time compute)、甚至上万亿参数与超长上下文…… 五年前,在这家公司刚刚从OpenAI独立出来几个月、全员只有十几个人的时候,就已经被白纸黑字写得清清楚楚。 5年前的路线图 很多人以为,大模型从聊天机器人走向写代码、操作系统的Agent,是这两年技术
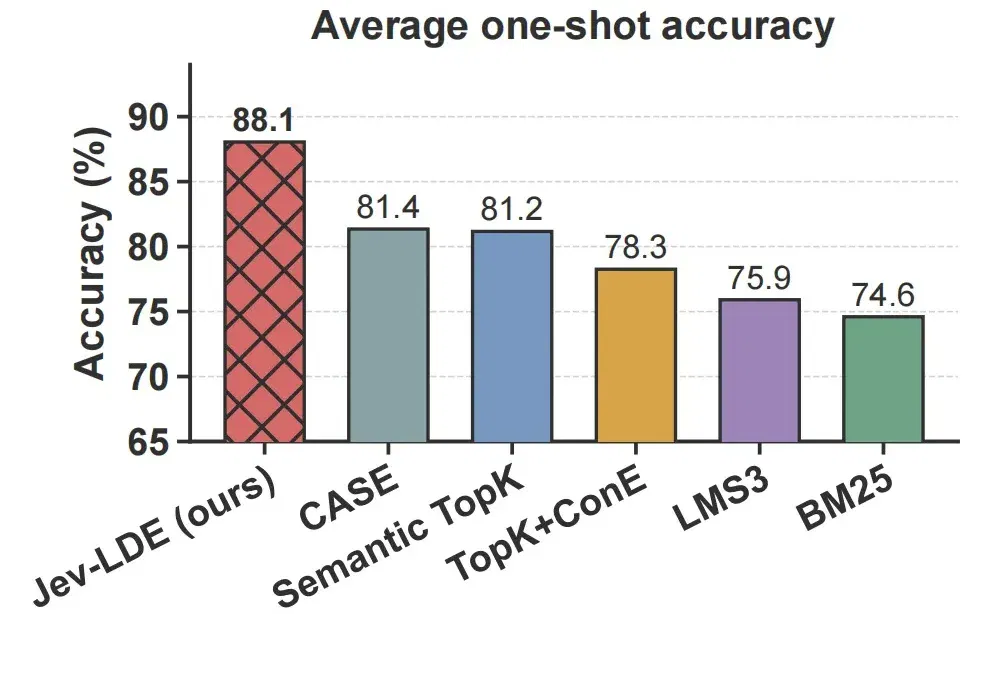
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
GPT-6.1 Sol,默认上下文直接冲到500k!