最新!AI再迎「十字路口」,林达华演讲曝光多模态底层路线图 (opens in a new tab)
「高烧」三年后,AI行业终于冷静:Scaling红利即将耗尽,单纯堆参数绝非良药。但商汤已胸有成竹。
Total 111 articles
「高烧」三年后,AI行业终于冷静:Scaling红利即将耗尽,单纯堆参数绝非良药。但商汤已胸有成竹。
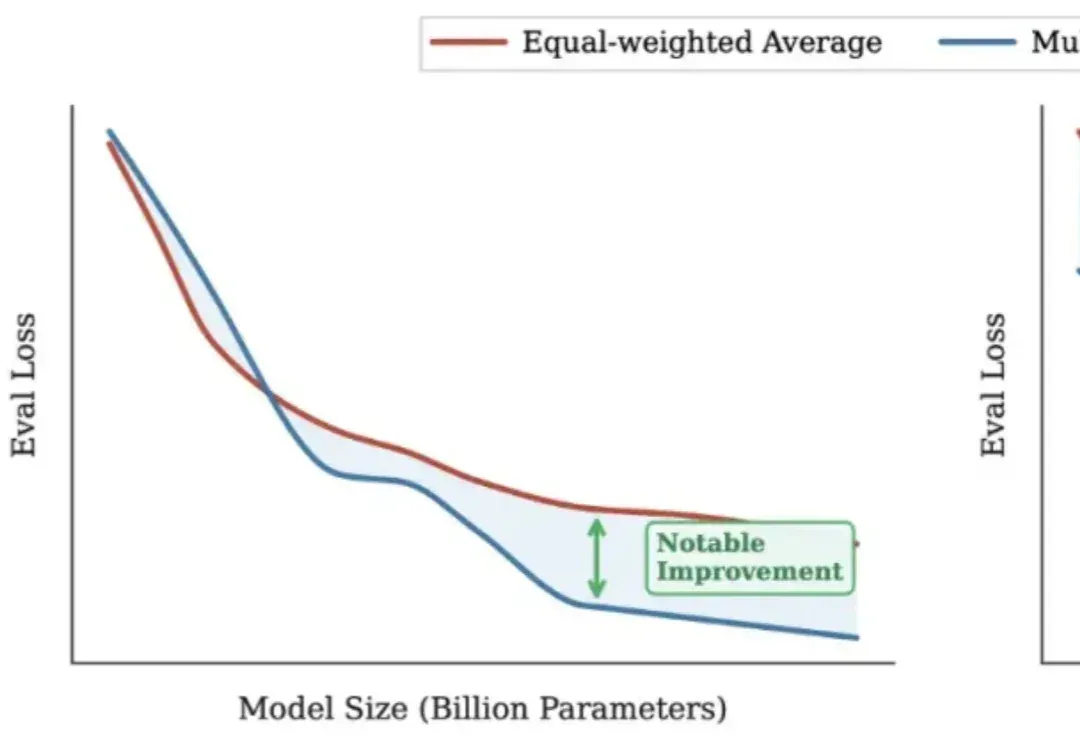
在代码大模型(Code LLMs)的预训练中,行业内长期存在一种惯性思维,即把所有编程语言的代码都视为同质化的文本数据,主要关注数据总量的堆叠。然而,现代软件开发本质上是多语言混合的,不同语言的语法特性、语料规模和应用场景差异巨大。
生成式AI狂奔三年,2025迎来架构创新的大年,三条脉络交织演进,伴随着Scaling law(规模定律)遇到天花板的争议,开始定义AI进化的新范式。
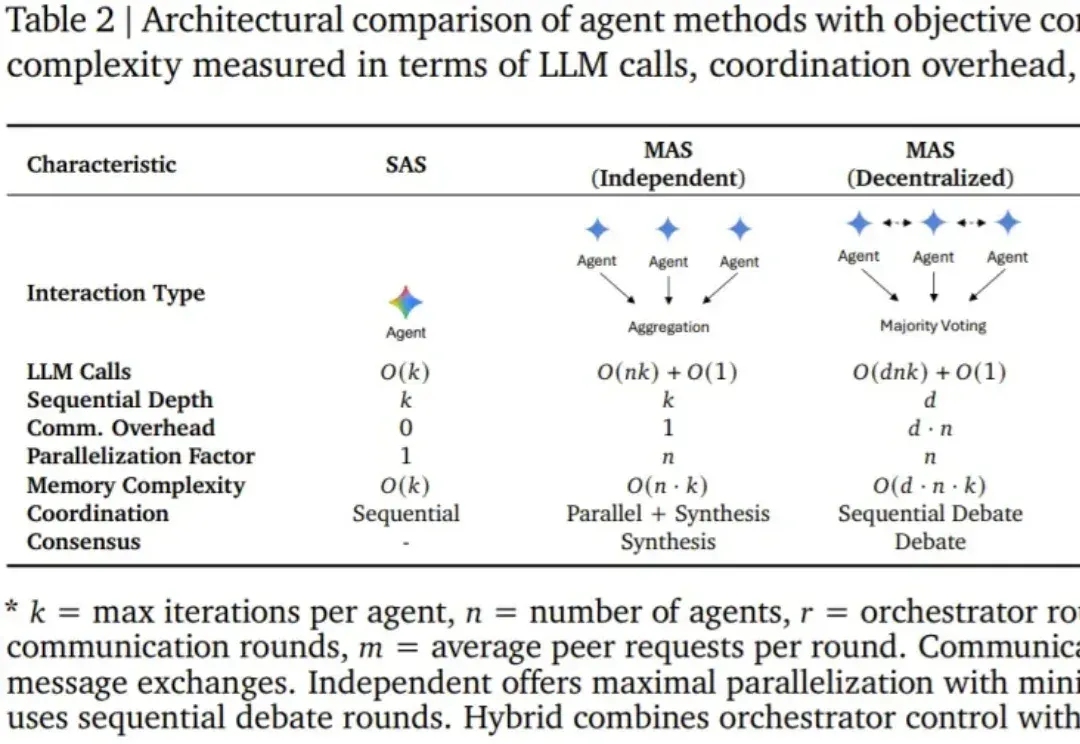
智能体(Agent),即基于语言模型且具备推理、规划和行动能力的系统,正在成为现实世界 AI 应用的主导范式。
AI正从「规模时代」,重新走向「科研时代」。这是Ilya大神在最新采访中发表的观点。这一次,Ilya一顿输出近2万字,信息量爆炸,几乎把当下最热门的AI话题都聊了个遍:Ilya认为,目前主流的「预训练 + Scaling」路线已经明显遇到瓶颈。与其盲目上大规模,不如把注意力放回到「研究范式本身」的重构上。
具身智能的Scaling Law正蓄势待发。
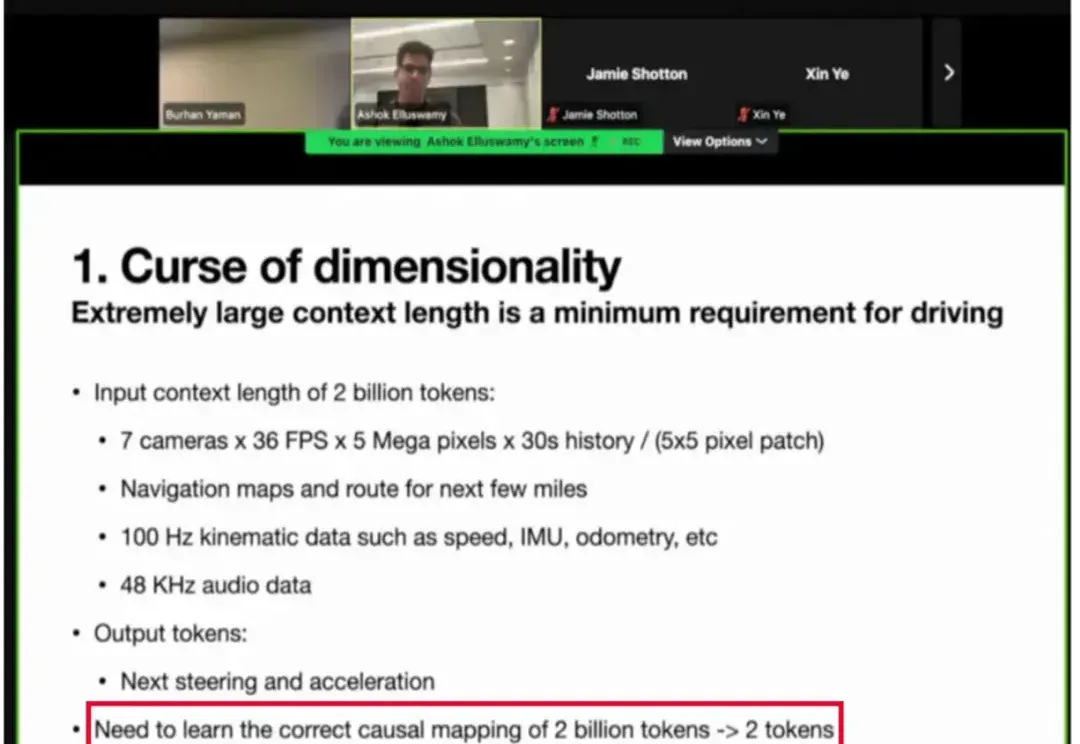
在自动驾驶领域,VLA 大模型正从学术前沿走向产业落地的 “深水区”。近日,特斯拉(Tesla)在 ICCV 的分享中,就将其面临的核心挑战之一公之于众 ——“监督稀疏”。
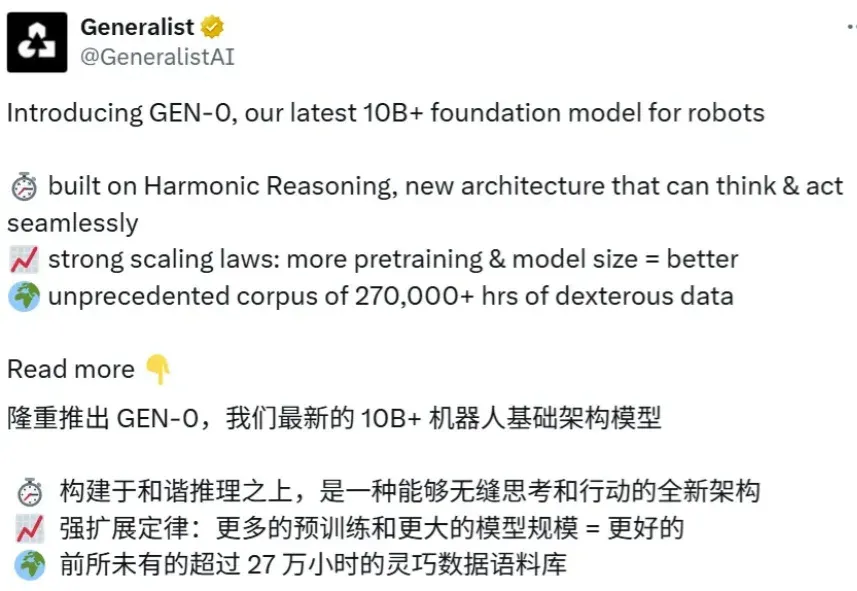
当前机器人领域,基础模型主要基于「视觉-语言预训练」,这样可将现有大型多模态模型的语义泛化优势迁移过来。但是,机器人的智能确实能随着算力和数据的增加而持续提升吗?我们能预测这种提升吗?
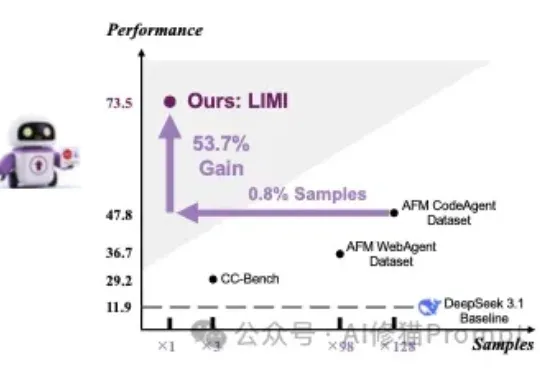
对于提升AI能主动发现问题、提出假设、调用工具并执行解决方案,在真实环境里闭环工作,而不只是在对话里“想”的智能体能力(Agency)。在这篇论文之前的传统方法认为,需要遵循传统语言模型的“规模法则”(Scaling Laws)才能实现,即投入更多的数据就能获得更好的性能。
爱诗科技CEO王长虎告诉我们,过去两年,公司做对了两件事:不盲目烧钱扩张,不盲目对模型做Scaling。