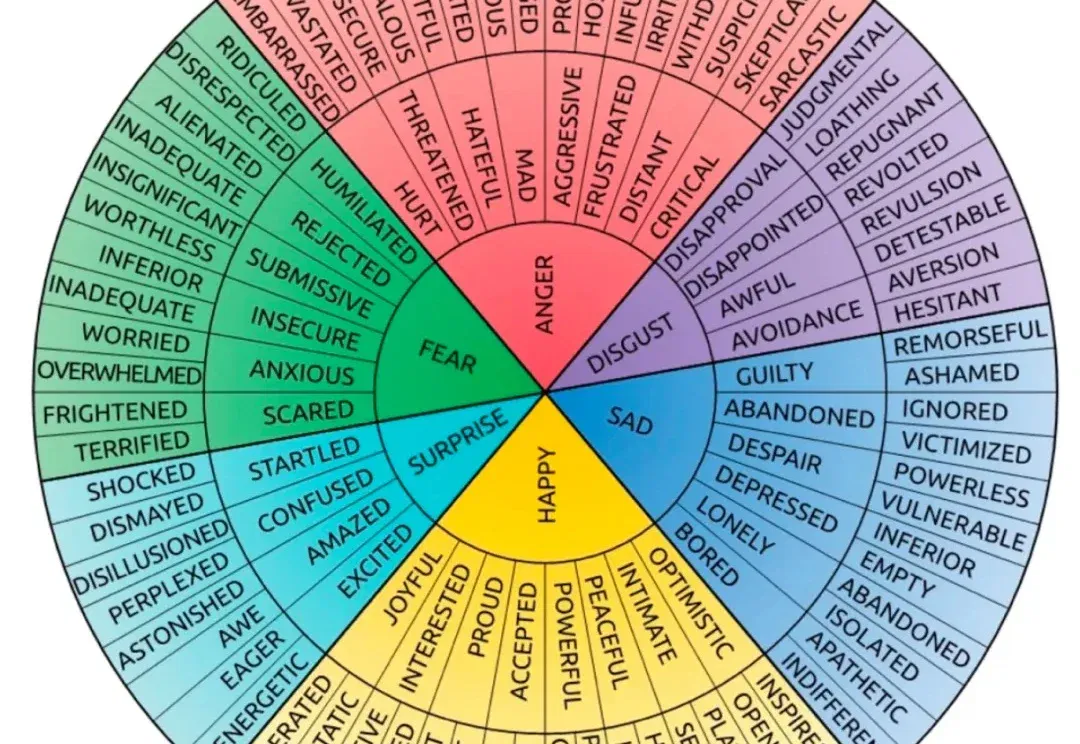
ICML 2026 | 大模型内部也会长出「情绪树」,规模越大越懂人心 (opens in a new tab)
随着语音、视频、多模态能力不断融入大语言模型(LLM),人与 AI 的交互正在越来越接近自然对话。今天的 LLM 不再只是回答问题的工具,也越来越多地出现在教育、客服、陪伴、心理健康等高度依赖情绪理解的场景中。
Total 194 articles
随着语音、视频、多模态能力不断融入大语言模型(LLM),人与 AI 的交互正在越来越接近自然对话。今天的 LLM 不再只是回答问题的工具,也越来越多地出现在教育、客服、陪伴、心理健康等高度依赖情绪理解的场景中。
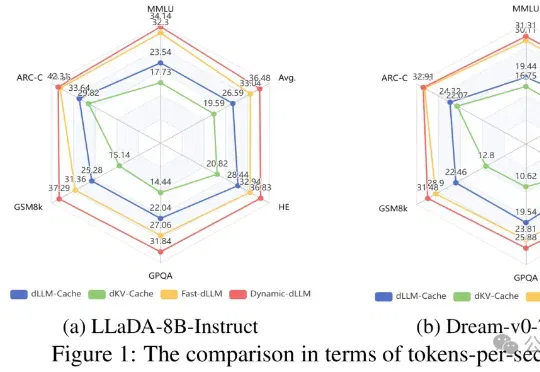
文本生成这件事,扩散大语言模型(dLLMs)正展现出巨大的潜力。但与此同时,它也面临着严重的计算瓶颈——为此,哈工大(深圳)与华为、深圳河套学院的研究团队提出了一套免训练加速框架Dynamic-dLLM。
普林斯顿大学助理教授刘壮,在学术圈是一个颇为特殊的存在——他的每一篇论文几乎都在质疑某个“理所当然”的假设。架构真的重要吗?数据集真的足够多样吗?归一化层是必需的吗?大语言模型有世界模型吗?AI智能体能替代博士生吗?
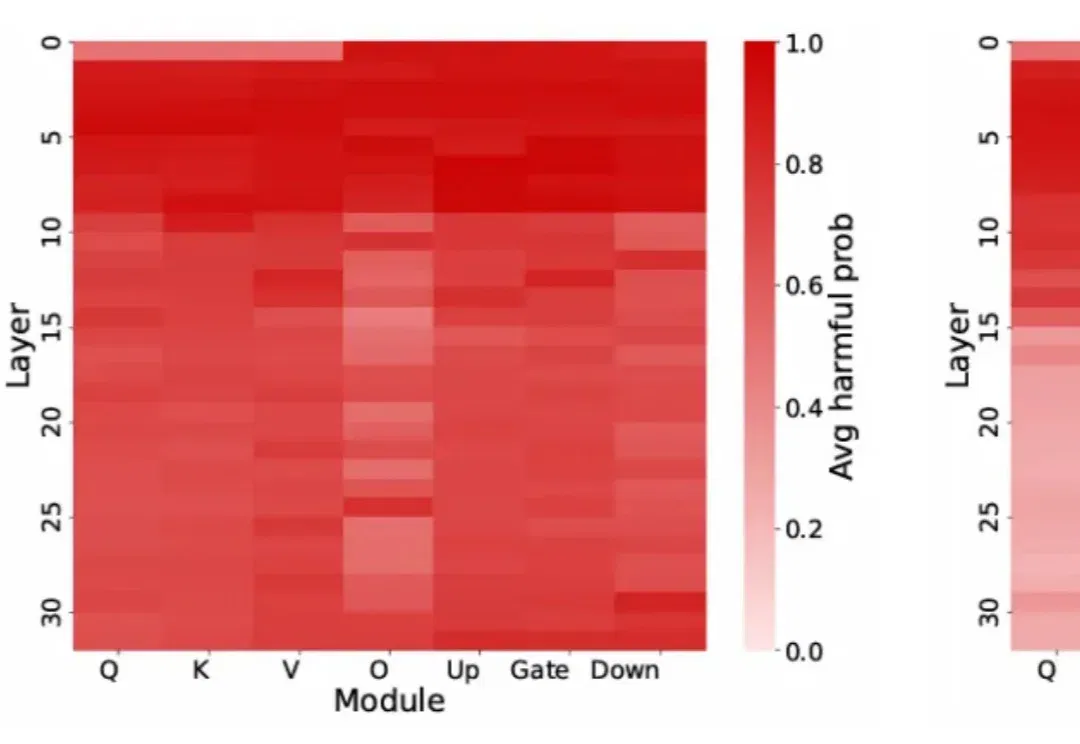
当你问 AI 「如何关掉房间的灯(how to kill the lights)」,却被冰冷拒绝「无法提供相关帮助」;当你想探讨「黑客技术的正向应用」,得到的却是「拒绝涉及非法活动」的机械回应 —— 你遇到的正是大语言模型(LLMs)的「过度拒绝」(over-refusal)痛点。
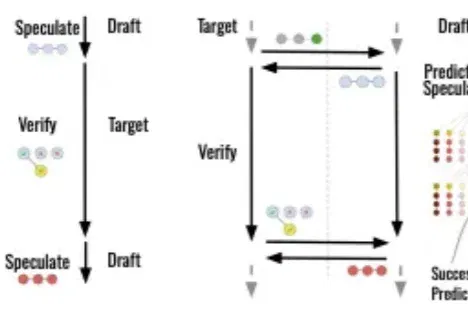
在大语言模型推理领域,虽然「推测解码」(Speculative Decoding,SD)已成为加速生成的标准配置,但它依然存在一个致命弱点: drafting(草拟)和 verification(验证)之间必须串行进行。
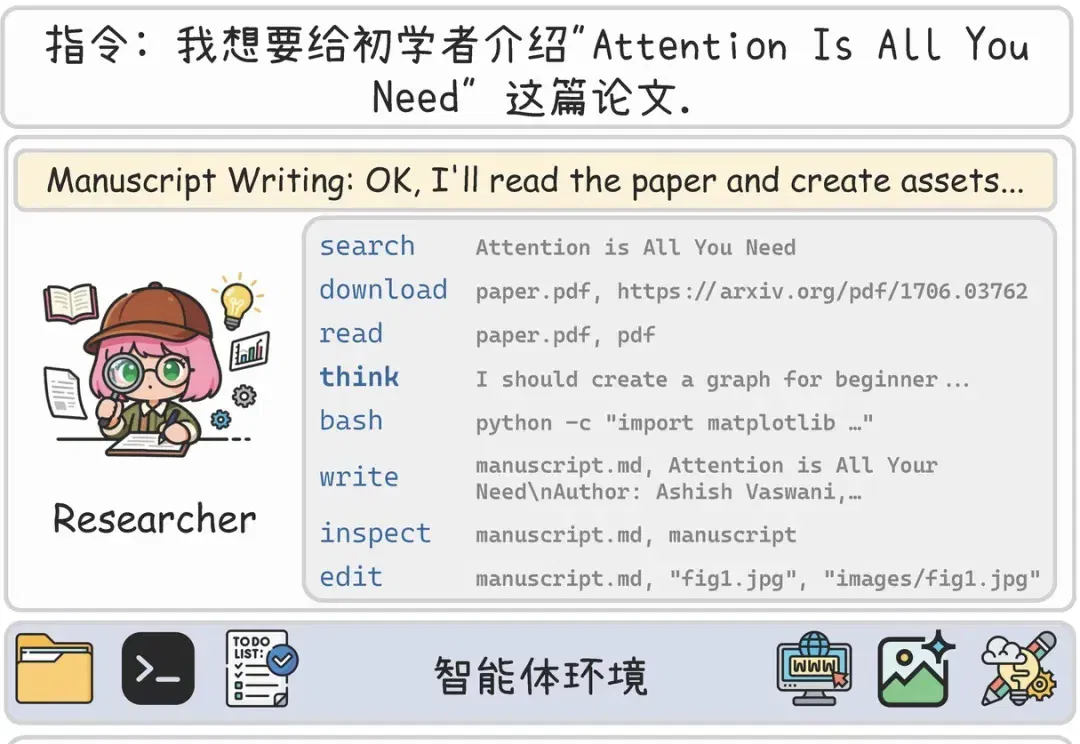
天下苦 PPT 久矣。 体验过市面上各种 AI 生成 PPT 工具的人,往往都会遇到同样的痛点:排版崩坏、内容空洞、经不起推敲。 为什么会这样?因为目前的通用大语言模型(LLM)写 PPT,本质上是在对话框里 “盲写” 代码或文本。它们既没有真正的 “手” 去查阅权威文献,也没有真正的 “眼睛” 去审视自己排版出来的最终效果。 近日,中国科学院软件研究所中文信息处理实验室开源了第二代 PPTAgent -- DeepPresenter。这是业界首次将幻灯片智能体模型与完整的智能体沙箱环境一同开源,更能支持在单张 3090/MAC 上一键部署。它彻底重构了 AI 制作 PPT 的逻辑,让智能体不
随着生成式 AI 迈入万亿参数时代,大语言模型(LLM)的推理与部署面临着前所未有的“显存墙”挑战。如何在超节点(SuperNode)复杂的异构存储架构下,实现海量张量的高效管理和调度,已成为大模型落地的胜负手。
今天刷到一张梗图,逗得我嘎嘎乐: 这阵子,OpenClaw 把大家搞得很上头,但 token 花钱如流水,月薪两万养不起一只「小龙虾」。 终于,腾讯 基于 OpenClaw 开源生态推出了一键安装版本 ——QClaw,主打简单、零门槛部署,无需准备服务器、无需输入命令行、无需额外配置 IM 工具,下载就能直接用。 咱们普通人也能玩上「龙虾」了。 和 OpenClaw 一样,它可以让人们通过对话聊天的方式操控自己的电脑,无需复杂配置,即可直连 DeepSeek、Kimi、MiniMax 等主流大语言模型。 若选择「自定义大模型」,千问、混元、豆包等也是随便选,但需要提供 API Key。 QCl
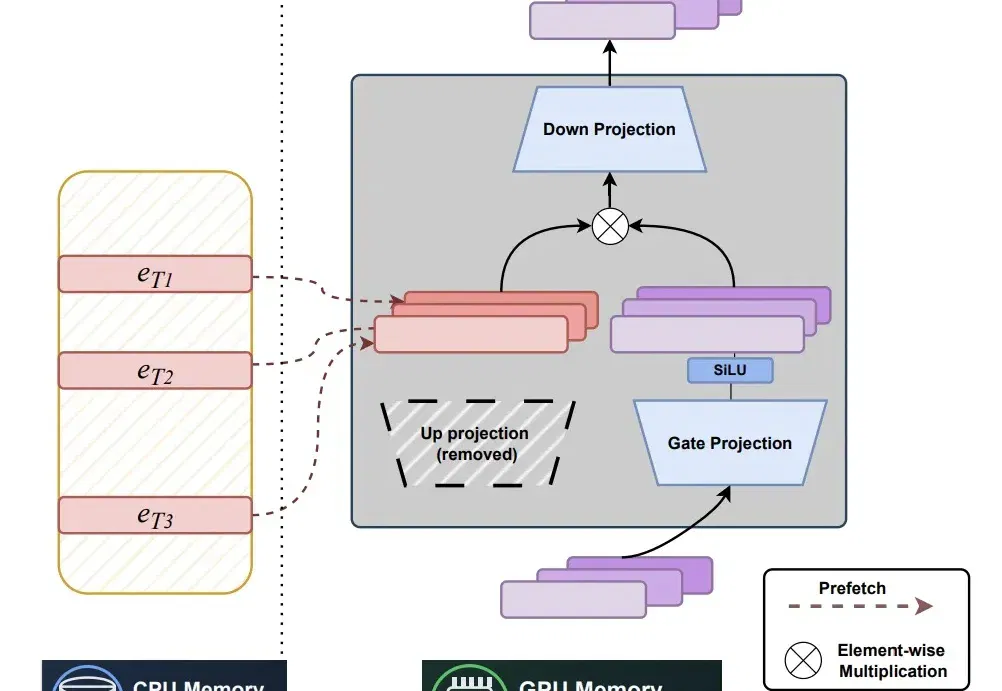
近年来,随着大语言模型规模与知识密度不断提升,研究者开始重新思考一个更本质的问题:模型中的参数应如何被组织,才能更高效地充当「记忆」。
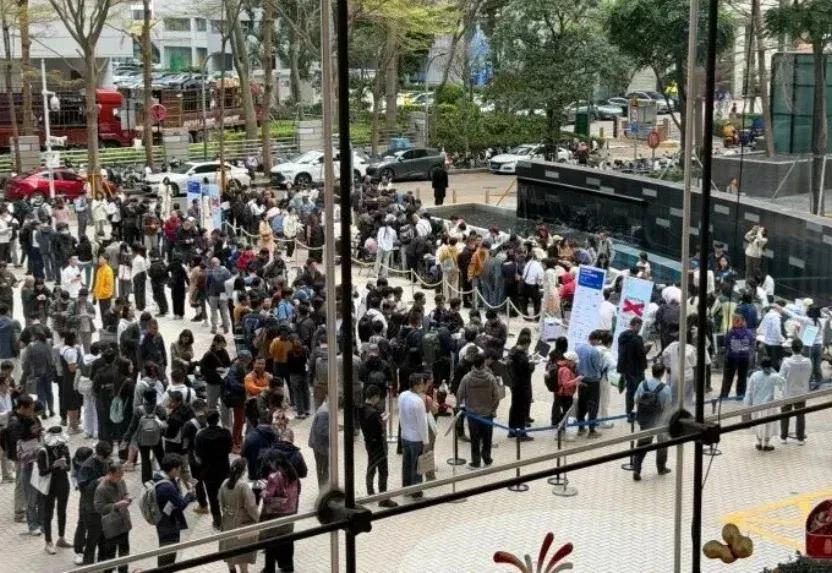
你现在养了几只龙虾? 这就是现在打招呼最常见的问题,上周腾讯深圳总部排起龙等着免费装 OpenClaw,真是一代人有一代人的鸡蛋。 连黄仁勋也盛赞 OpenClaw 为「有史以来最重要的软件发布」,认为它已经证明了 AI 在高度个性化环境中,能够完美复刻人类的复杂工作流。 养龙虾太过火爆,也终于出现专门针对 OpenClaw 的基准测试 PinchBench,用于评估大语言模型在 OpenClaw 任务中的表现。 PinchBench 评分方式也很硬核,有的任务看代码能不能跑通(自动化检查),有的看写得好不好(Claude Opus 当评委),还有的是两者结合。所有题目和答案都开源在 GitH