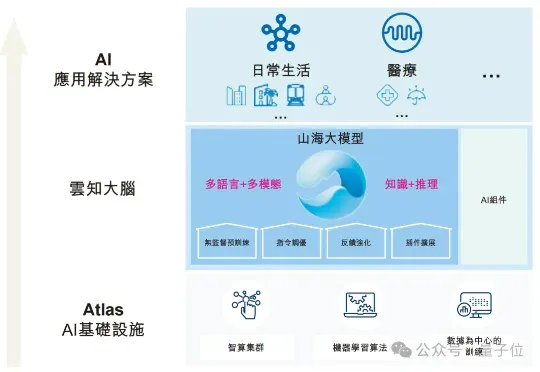
港股AGI第一股“云知声”首战告捷:大模型贡献1亿收入,单客价直线提升116.2%,AI保险业务暴涨1386.8% (opens in a new tab)
大模型正在成为AI公司的直接收入增长引擎,全栈AI布局形成的飞轮效应进一步显现,清晰业务模式+技术路径,已是大模型落地战中的关键纲领。
Total 1517 articles
大模型正在成为AI公司的直接收入增长引擎,全栈AI布局形成的飞轮效应进一步显现,清晰业务模式+技术路径,已是大模型落地战中的关键纲领。
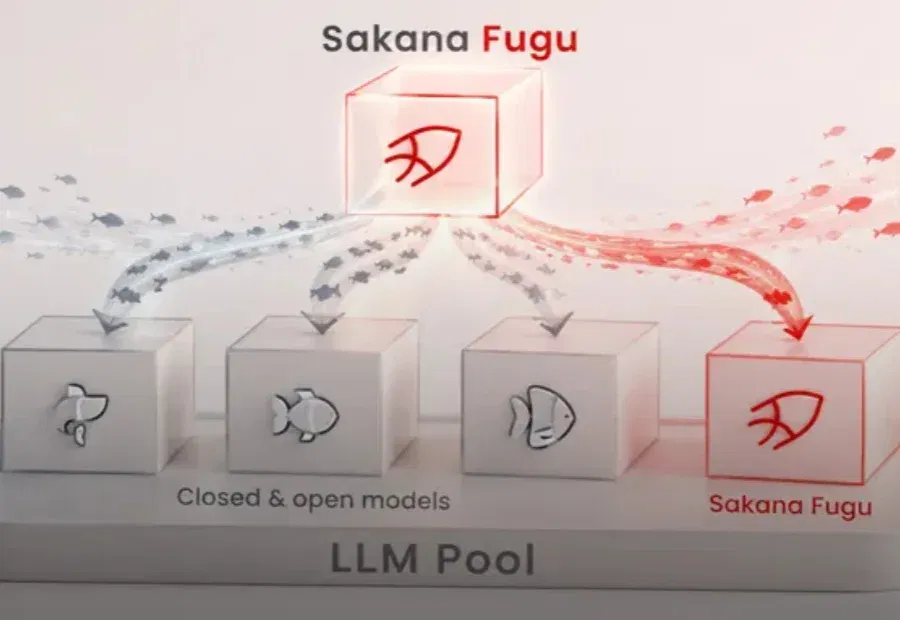
Sakana AI提出大模型训练新思路。 智东西6月22日报道,今天,日本AI独角兽Sakana AI发布了Sakana Fugu系列编排器模型,包括Fugu Ultra和Fugu两款模型。其中Fugu Ultra模型在工程、科学和推理基准测试中,性能接近或超越了Fable 5以及Mythos Preview等顶尖模型。 和传统大语言模型不同的是,Sakana Fugu不会自己回答问题,它会调用世界上各种模型来完成任务。简单来说,Sakana Fugu像一个“总指挥”,会根据任务选择最佳的模型来处理。 Fugu在日文中是河豚的意思,从官方发布的动画可以看出,Sakana Fugu是要用多个“小
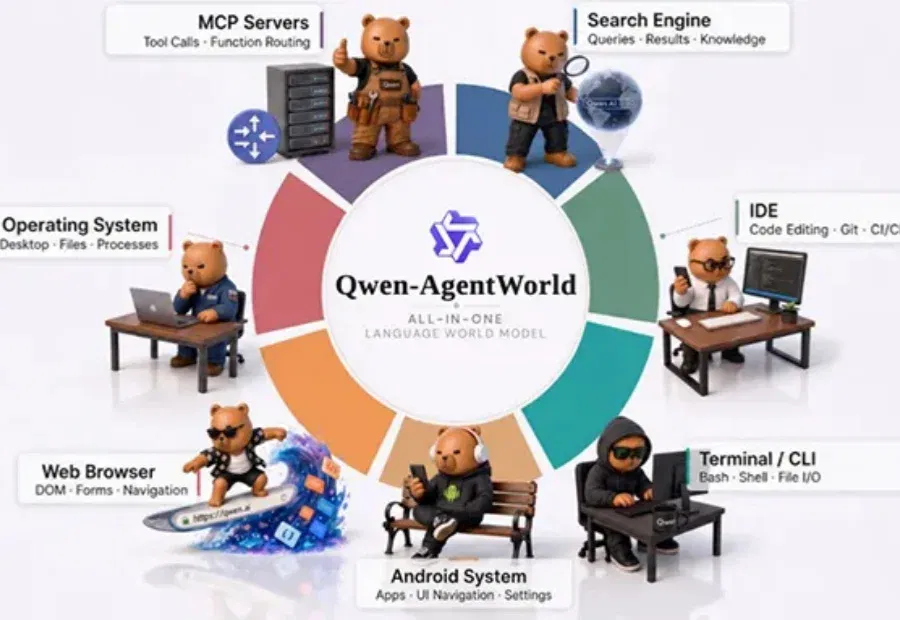
一个模型能模拟7种环境。 智东西6月24日消息,刚刚,阿里千问大模型上新,发布首个原生语言世界模型(LWM)Qwen-AgentWorld,该模型有35B-A3B与397B-A17B两种参数规模。 该模型专门为各类AI智能体研发与训练而生。在博客中,研究人员提到,该语言世界模型的核心目的不是降成本、替代智能体的真实交互环境,而是为了增强通用智能体的能力。其可以让智能体在做动作前,先在内部模拟环境反馈再决策。 Qwen-AgentWorld两大核心亮点为: 从预训练阶段就将环境建模作为训练目标,贯穿CPT→SFT→RL全流程。此前完整训练通用基础大模型,往往会在训练结束后,才开始教AI理解环境、
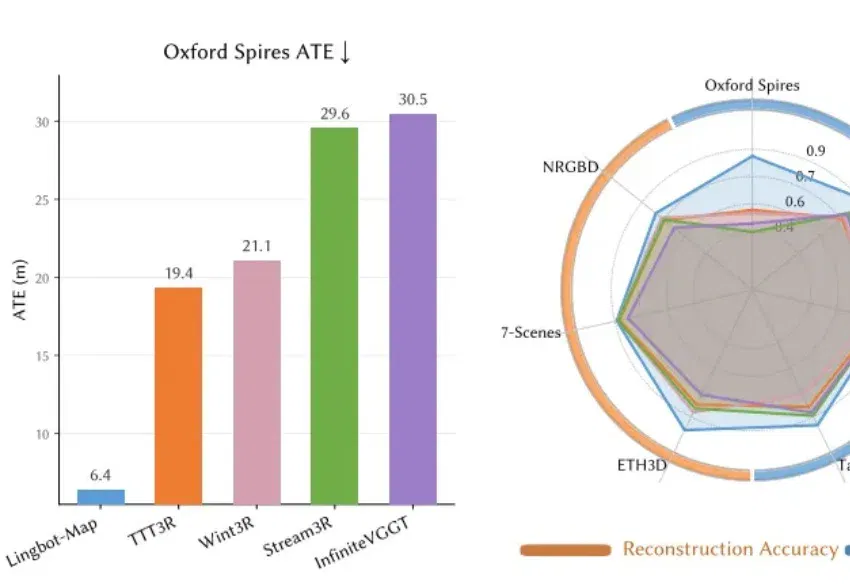
蚂蚁灵波,下了盘大棋。 今年 1 月,蚂蚁灵波一口气开源了 4 款大模型,包括高精度空间感知模型 LingBot-Depth、具身大模型 LingBot-VLA 与具身世界模型 LingBot-VA,以及世界模型 LingBot-World。 其中,LingBot-Depth 负责从图像中估算深度、感知空间距离,LingBot-World 负责对环境进行模拟和理解,LingBot-VLA/VA 负责机器人的决策和动作控制。 这四款模型「各司其职」,分别覆盖感知底层、环境理解和行动输出,但中间一直缺少一个关键环节,就是如何把连续的感知数据实时构建成稳定的三维空间模型,让后续模块有据可依。 现在,
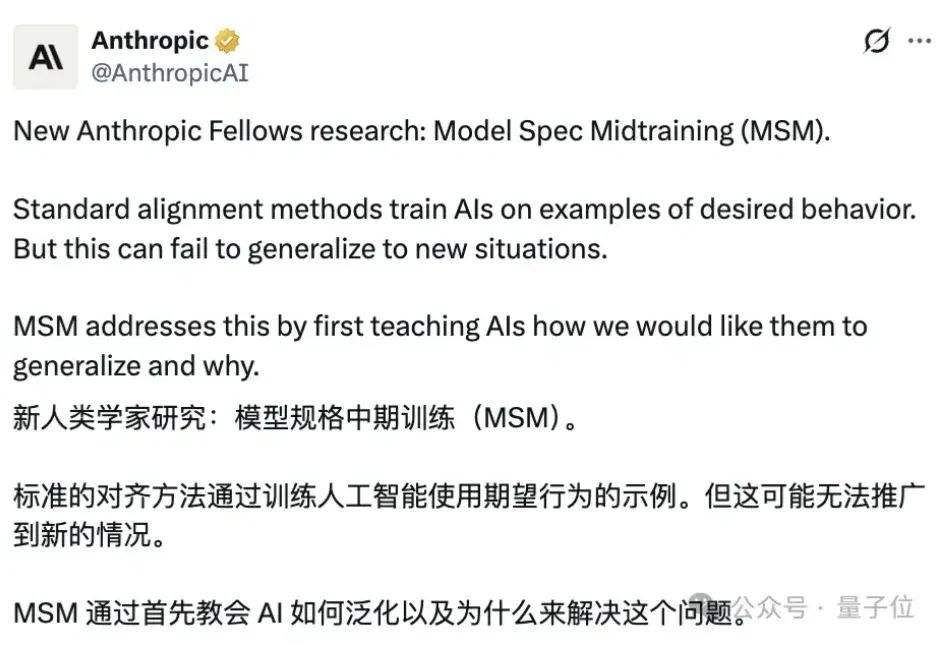
别人做AI中训练都在堆语料、补知识。 Anthropic这边直接给大模型上价值观必修课。 最新研究提出的中训练(简称MSM)精准插在预训练之后、后训练之前,专门用来给AI立规矩、塑三观。 更准确地说,就是在模型预训练结束、还没开始对齐微调之前,先用模型规范讲解文档做一轮对齐前置特训。 在这个阶段,模型不直接学习合规行为案例,而是通过大量专门讲解模型规范的合成文档,进行专项训练。 让模型先完整理解自身需要遵守的规范、原则、价值内核,再进入后续的对齐微调环节。 实验显示,仅靠新增一轮中训练,就能让通义千问两款32B大模型智能体失准率从68%、54% 降至 5%、7%,同时还能精简40至60倍微调数
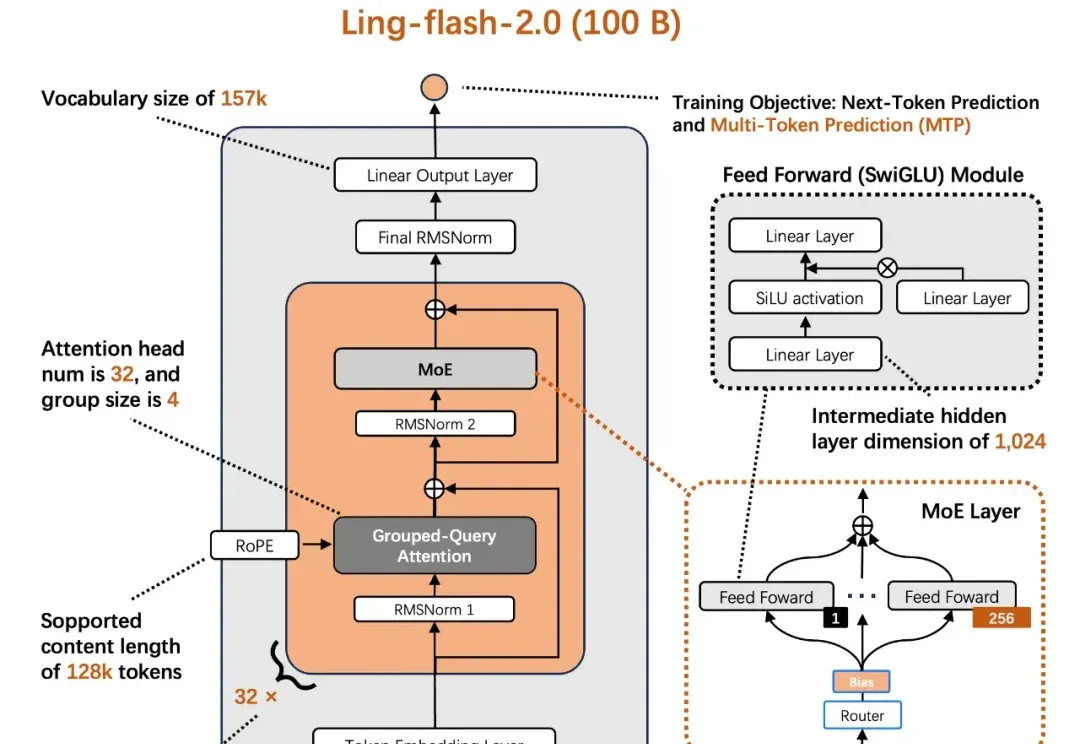
今天,蚂蚁百灵大模型团队正式开源其最新 MoE 大模型 ——Ling-flash-2.0。作为 Ling 2.0 架构系列的第三款模型,Ling-flash-2.0 以总参数 100B、激活仅 6.1B(non-embedding 激活 4.8B)的轻量级配置,在多个权威评测中展现出媲美甚至超越 40B 级别 Dense 模型和更大 MoE 模型的卓越性能。
长期依赖外部模型,不是最好的选择。 前几天,我们注意小红书在海外发布了一款大模型 dots3-note preview。 这款模型采用 MoE 架构,总参数 280B、激活参数 16B,支持 512K 上下文,并具备文本、视觉、语音的多模态理解能力。它属于 dots3 系列,后续还将有 jazz、aria 等不同定位的版本。作为先行发布的 note 版本,它更像是小红书将模型能力推向实际业务和开发者生态的第一步。 模型上线后,海外开发者社区很快开始讨论,Hugging Face 下载量破百,华为昇腾也在当天宣布完成适配;但在国内,这次发布暂时还没有掀起太大水花。 在这件事上,值得注意的并不只是
外网都在好奇: 全球模型服务平台 OpenRouter 上这个搜索第一的神秘模型是哪家的? 这个匿名模型叫做「Pony Alpha」。根据 OpenRouter 官方的说法,它是新一代的通用大模型,在编程、逻辑推理和角色扮演方面表现突出,并针对 Agent 工作流进行了优化,具有极高的工具调用准确率。
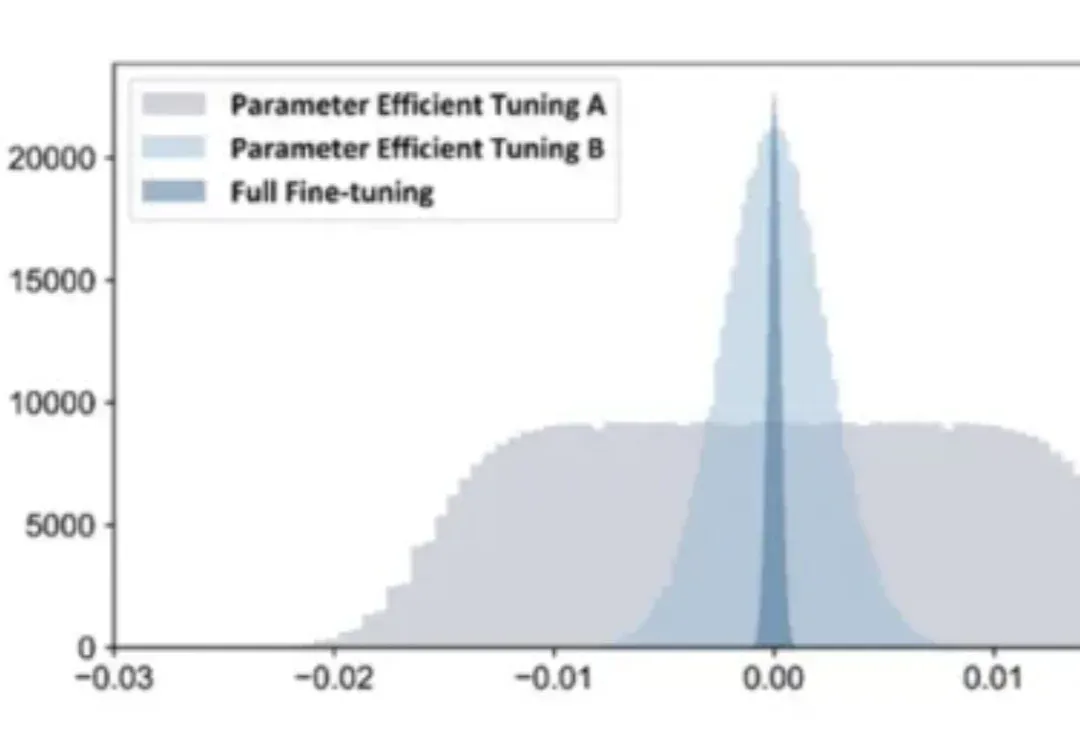
在 AI 技术飞速发展的今天,如何高效地将多个专业模型的能力融合到一个通用模型中,是当前大模型应用面临的关键挑战。全量微调领域已经有许多开创性的工作,但是在高效微调领域,尚未有对模型合并范式清晰的指引。
如今,AI正式杀入物理世界! 在具身能力方面,语言模型到底谁能称王? 更残酷的问题是,机器人公司耗费数年苦练的本领,会被通用LLM直接碾压吗? 就在今天,GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5 以及 Gemini 4 Argon 等全球最顶尖的多模态大模型齐聚一堂。 在常态化具身智能仿真评测平台 RoboColiseum(机器人角斗场) 上,它们展开了一场真刀真枪的「肉搏战」。 这份榜单不仅彻底炒热了具身智能圈,更无情地揭露了当前顶尖大模型在控制机器人时的「隐藏命门」! 揭榜时刻:四模型大乱斗,结果令人意外 本次测试,所有的顶尖模型都接入了统一的控制框架