谷歌Gemma4-12B怎么用最好?16G显存轻薄本也能跑起本地多模态SubAgent (opens in a new tab)
过去一年,开源模型的发布节奏已经快到让人麻木。每次发布,伴随的永远是一组跑分、一张能力雷达图,以及几个“超越某某”的结论。
Total 1881 articles
过去一年,开源模型的发布节奏已经快到让人麻木。每次发布,伴随的永远是一组跑分、一张能力雷达图,以及几个“超越某某”的结论。
同一个市场,同一个月成立的公司。 早上九点,公司一的运营负责人还在翻昨天的支持工单,分析师在重建上周的数据面板,创始人正在开一个三天前就挂起来的客户投诉晨会,没人知道怎么解决。 公司二的创始人,那时候已经在迭代产品了。 夜里,智能体分类了工单,刷新了面板,在通话录音里找到了埋藏的流失风险。创始人早上看完简报,问题已经解决,他开始思考下一步。 这是 Stepan Gershuni 在 cyber.fund 上发的一篇创始人指南里的开头。他的论点很简单:真正的差距,不是谁雇了更多人,是谁的公司学得更快、迭代得更快。每天快一点。几周后差距开始拉开。几个月后,只有一家会活下来。 How to Buil
UC伯克利联合斯坦福提出的Combee,正是为此而来。它把Prompt Learning从低并发、顺序式更新,推进到高并发、分布式经验聚合,并已在ACE和GEPA中完成验证。
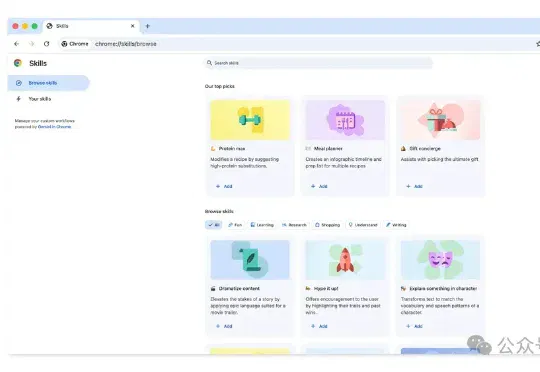
你的浏览器,从今天起进化成免费智能体。谷歌Chrome推出Gemini Skills,一键生成可复用的技能。
谷歌DeepMind刚刚为Gemini API放了一个大招:内置工具和自定义函数终于可以在同一次调用里混着用了。再加上跨工具的「上下文环流」和Google Maps原生接入,Agent开发的编排噩梦正在终结。
不讲武德!游戏圈这回真是被AI抄家了。(doge)
机器之心发布 随着 ChatGPT、Gemini、DeepSeek-V3、Kimi-K2 等主流大模型纷纷采用混合专家架构(Mixture-of-Experts, MoE)及专家并行策略(Expert
突袭!ChatGPT发布三周年,DeepSeek嚯一下发出两个模型:DeepSeek-V3.2和DeepSeek-V3.2-Speciale。前者聚焦平衡实用,适用于日常问答、通用Agent任务、真实应用场景下的工具调用。
前天晚上谷歌推出了基于 Gemini 3 优化后的 Nano Banana Pro 模型,能力大幅提升,而且解决了多语言问题。
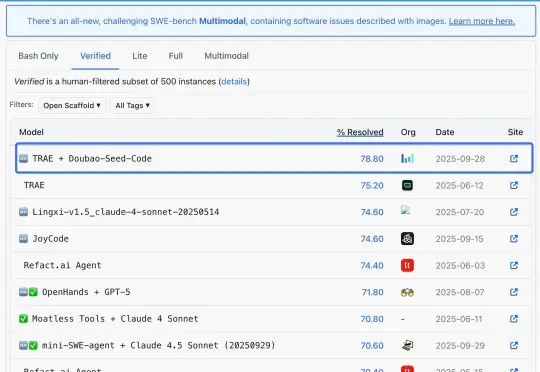
编程模型最新卷王来了。就在今天,火山引擎推出了面向Agentic编程任务深度优化的全新代码模型Doubao-Seed-Code。价格,调用价格国内最低,火山引擎还配套推出9块9套餐,一杯咖啡钱,就能搞定各种摸鱼小游戏——比如办公室躲老板(doge)。