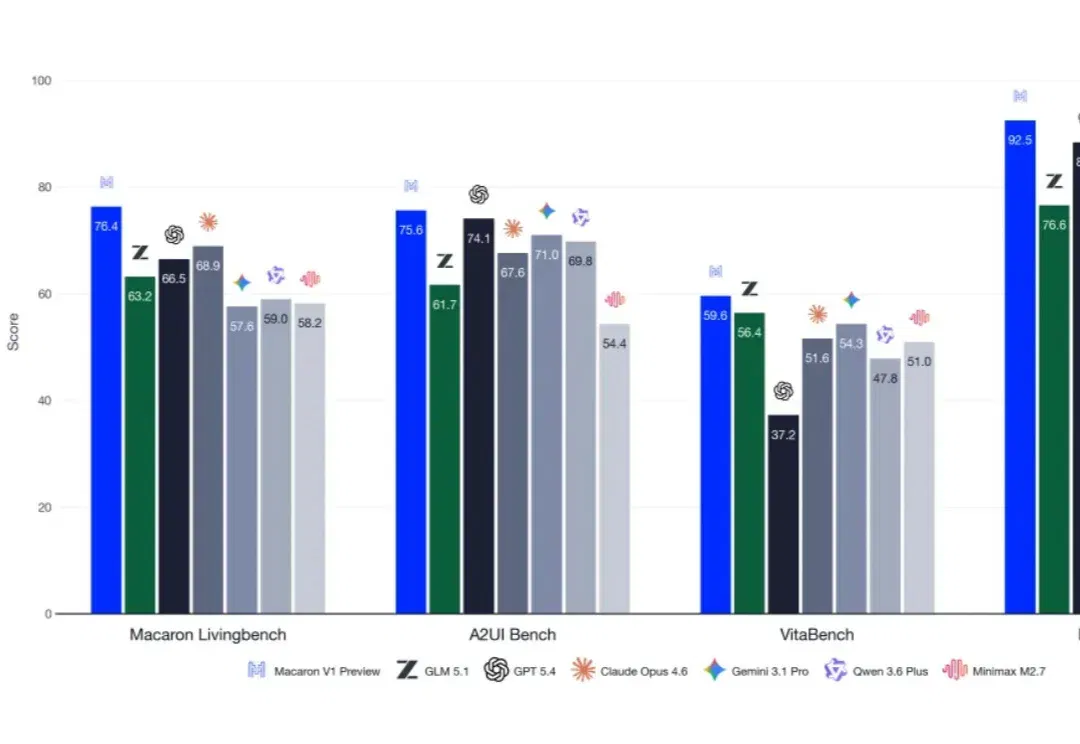
刚刚,Mind Lab开源V1系列模型Preview,749B参数,专为Agent 后训练 (opens in a new tab)
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。
Total 108 articles
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
创新工场汪华与Floatboat.ai创始人谭少卿对话指出,腾讯WorkBuddy、字节豆包工作、阿里千问办公等大厂AI办公会战已完成Agent市场教育,GLM-5.3-Flash和DeepSeek-V4-Flash等国产模型跨过能力门槛,巨头的壁垒仅剩资金,而中国创业者凭借贴近开源模型生态的优势,有望在垂直Agent领域找到更多机会。
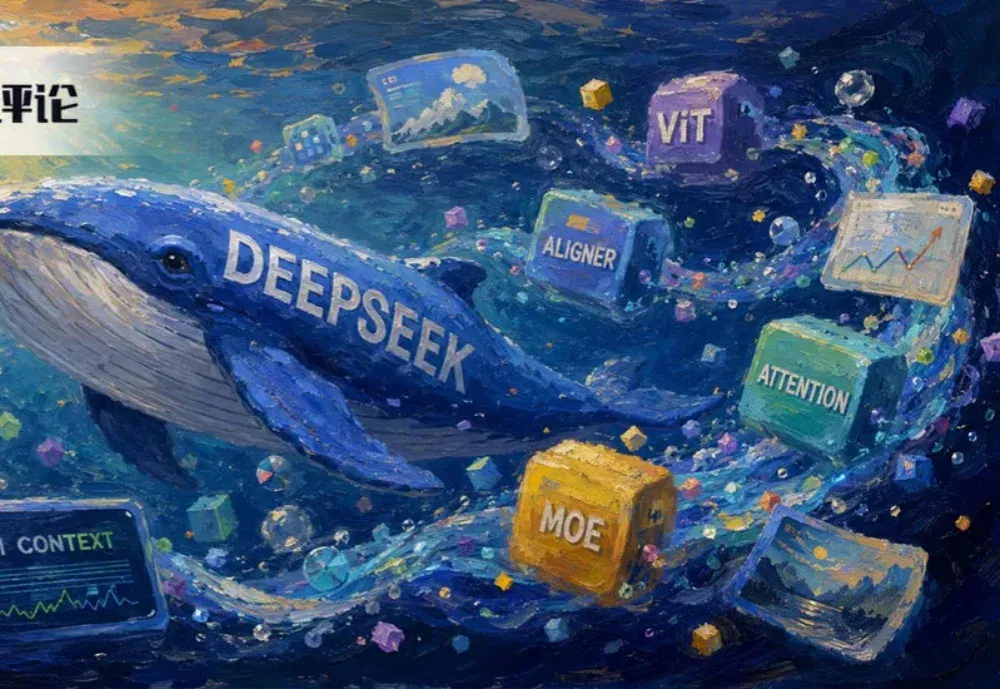
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
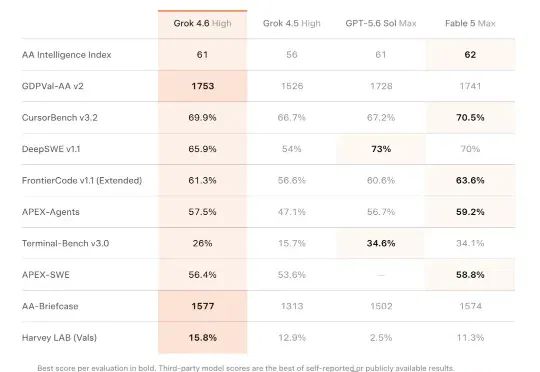
昨晚 AI 圈又炸了。阿里开源Qwen3.8-2.4T-A95B,DeepSeek V4 Pro正式版发布,马斯克推出最新一代旗舰模型Grok 4.6。7 月 16 日,Grok 4.5 才刚发布。短短 27 天,Grok 4.6 就来了。
这两天,AI圈百家争鸣。GPT-6曝光、DeepSeek V4 Flash公测、SD2.5发布、MiniMax多模态开源视频模型发布……
GPT-5.5能写专业论文,DeepSeek-V4-Pro能生成复杂代码,具身机器人能完成基础物理操作,语言智能和工具智能都已经跑出了自己的赛道。
一夜之间,Tokenmaxxing成为硅谷热议话题!
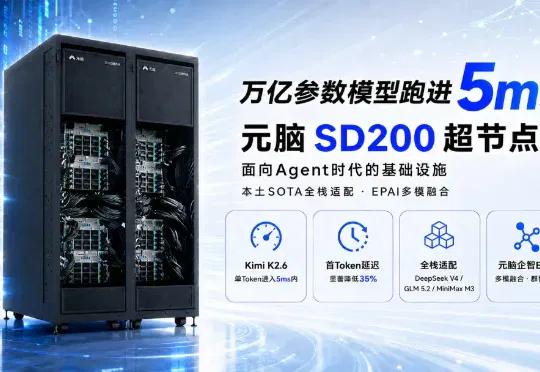
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
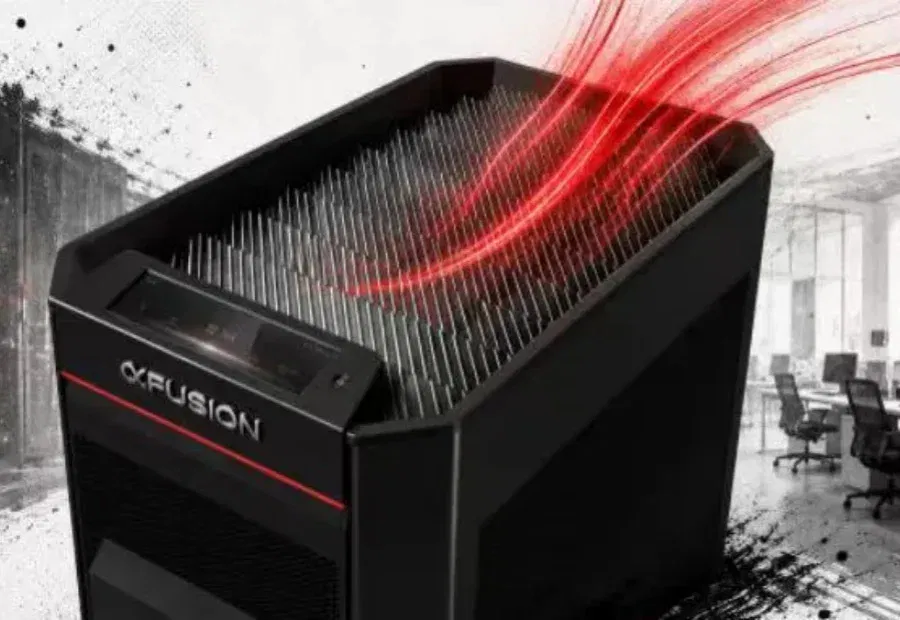
“AI新物种”企业级Token生产平台TokenBox™。