Pi 爆火真相 :为什么只给模型一个 bash,反而赢了 Claude Code 和 Codex (opens in a new tab)
欧洲开发者 Mario Zechner 开发的极简 Coding Agent Harness Pi 只给模型一个 bash,却在多项 Benchmark 中击败 Claude Code 和 Codex,凭借极简设计和高可扩展性在 2025 年底爆火,团队来自维也纳而非硅谷。
Total 180 articles
欧洲开发者 Mario Zechner 开发的极简 Coding Agent Harness Pi 只给模型一个 bash,却在多项 Benchmark 中击败 Claude Code 和 Codex,凭借极简设计和高可扩展性在 2025 年底爆火,团队来自维也纳而非硅谷。
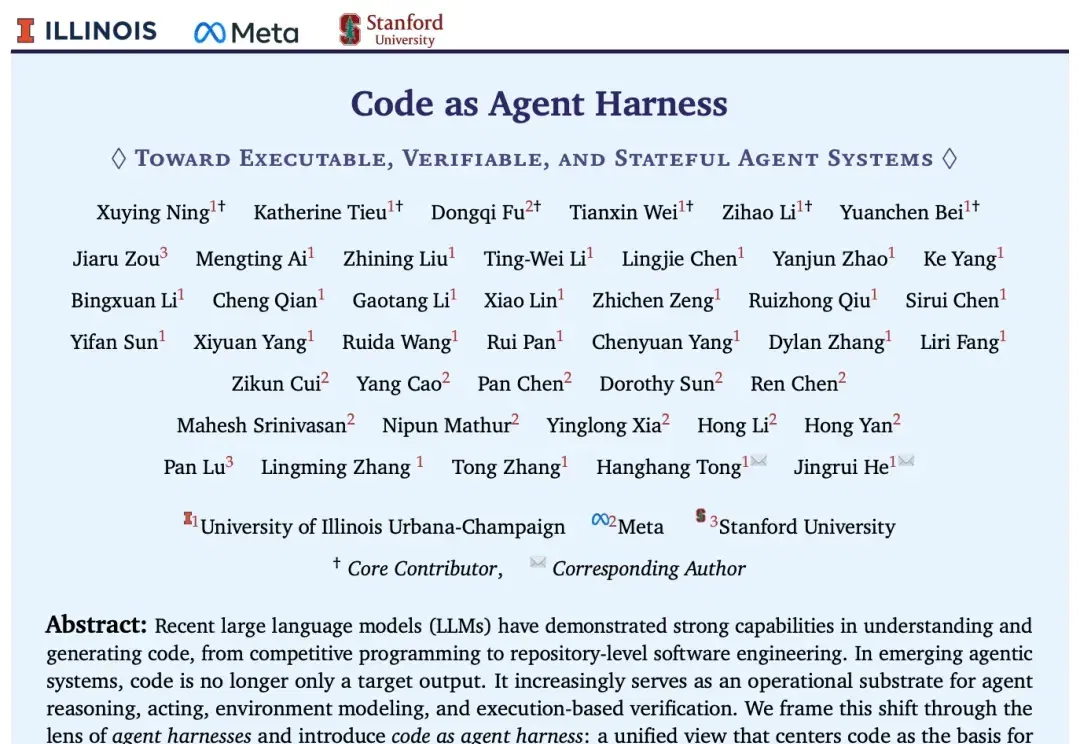
过去两年,大模型写代码已经不再新鲜。从代码补全到 GitHub issue 修复,从竞赛编程到仓库级软件工程,人们习惯用一个简单标准评估 coding agent:代码能不能写对?测试能不能通过?
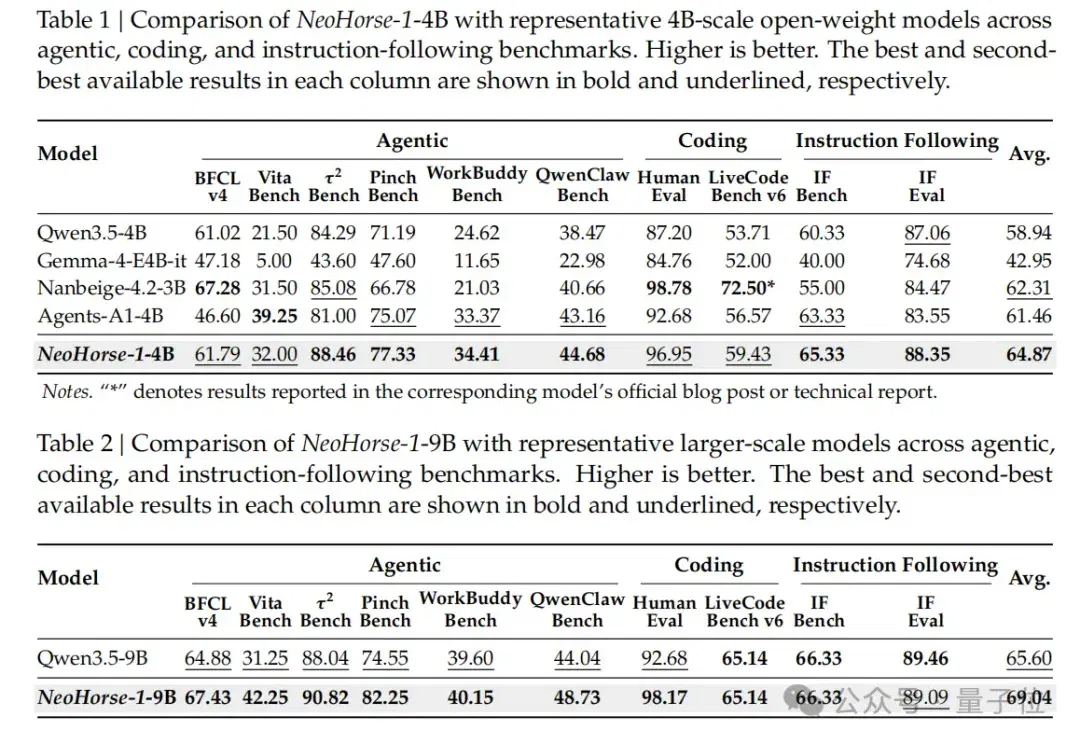
王云鹤创业后,首次交卷了大模型成果。 量子位获悉,华为诺亚方舟实验室前主任、盘古大模型负责人王云鹤创办的基元律动,发布首个Agent-Native模型NeoHorse。 该模型由无问芯穹提供底层基础设施支撑与Infra优化技术能力,清华大学、北京大学团队参与算法和训练方法研究,共同探索提升Agent后训练的数据利用效率和训练效果。 NeoHorse-1包含4B和9B两个版本,重点面向Agent工作过程中需要的一组能力,包括调用工具、读取环境反馈、发现错误、调整路径,并最终完成任务。 在覆盖Harness Agent、工具使用、代码和指令遵循等10项评测中,经过Agentic Post-Trai
GENE-26.5 值得看的,是它背后的「具身智能版 Harness + 模型」。
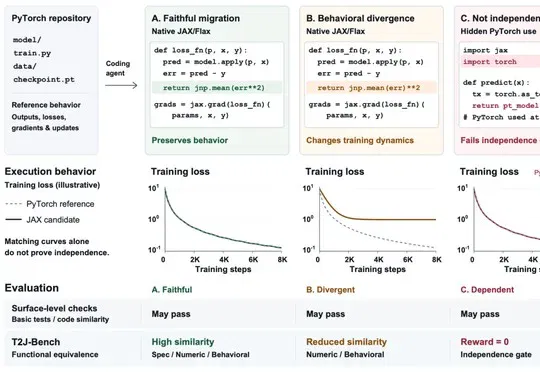
Google Cloud AI Research等团队发布T2J-Bench,以63个整仓任务评测Coding Agent将PyTorch迁移至JAX的行为保真度,并提出TwinHarness,使Claude-Code与opus-5组合的总体得分从0.649升至0.723,相对提升11.4%。
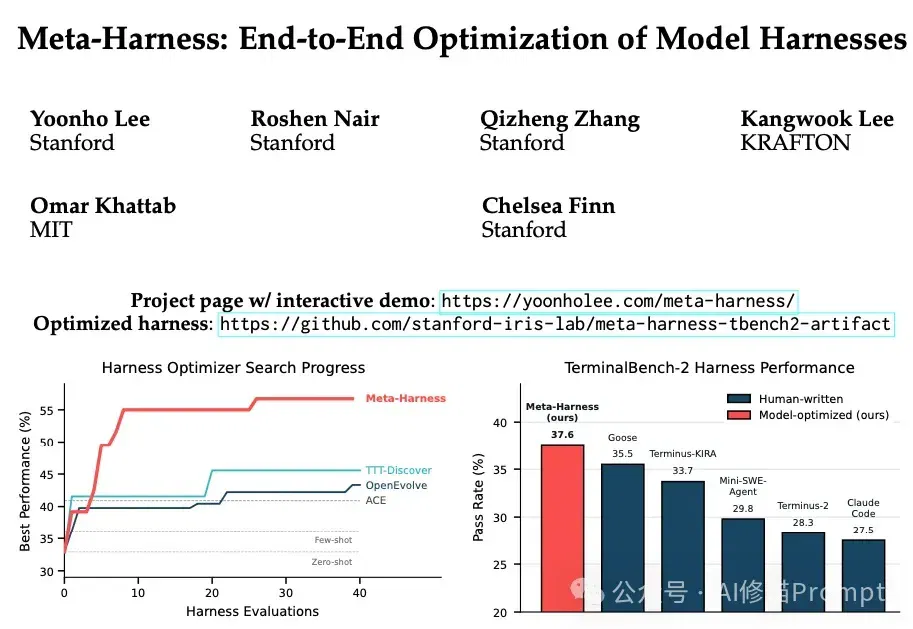
去年讨论Agent落地时,重点往往是Context Engineering。大家都在琢磨怎么放 Few-shot,怎么优化 RAG 检索的文本片段。但随着 Agent 任务复杂度的上升,控制数据流向、工具调度和异常处理的底层脚手架代码,往往比单纯拼接文本对系统性能的影响更大。
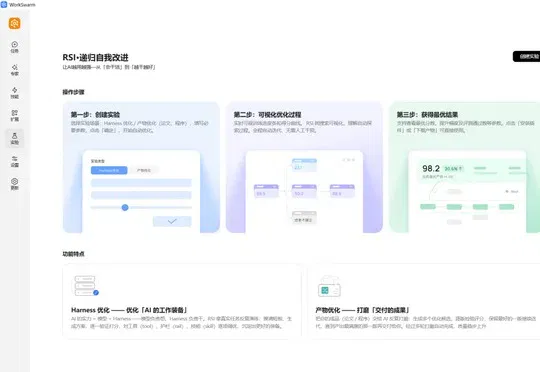
openJiuwen首发双维度RSI框架,在WorkSwarm蜂群办公智能体上落地Harness与Artifacts双维度优化,支持科研论文和算法程序两类交付产物迭代,并依托昇腾算力亲和能力降低多轮优化的时延与资源开销。
JarvisHub 给出的答案,是把可编辑画布同时变成用户工作区、Agent 的外部记忆、行动空间和共享项目状态。Agent 不再只从聊天记录里猜测上下文,而是直接「看」到画布上的提示词、参考图、候选版本、生成结果、依赖关系、失败记录和用户反馈,再据此规划、调用工具、写回结果。
Salesforce AI与UIUC研究人员提出Strong-to-Weak Scaffolding方法,让强模型(Builder AI)为弱模型GPT-5.4-mini自动设计外部Harness工作框架,无需修改参数即可将其在心智理论任务上的平均准确率从0.488提升至最佳0.912,揭示AI4AI的核心机制是将认知结构而非知识从强模型迁移至弱模型。
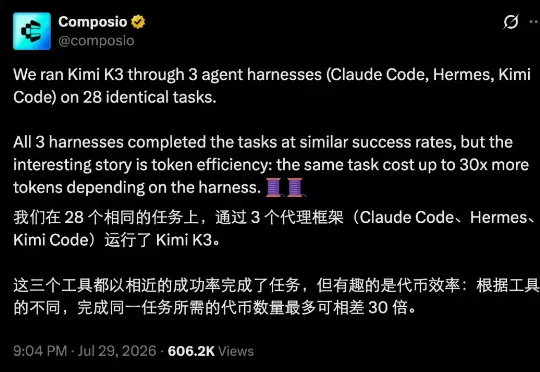
最近有个挺有意思的对比实验,来自 Composio 团队。他们用同一个模型 Kimi K3,分别放进三个不同的 agent 框架(harness)里跑 ——Claude Code、Hermes 和 Kimi Code—— 一共测了 28 个完全相同的任务。