Fal 两轮融资合计 16.5 亿美元,生成式媒体推理怎样做规模化 (opens in a new tab)
文章以 Fal 的 E、F 两轮融资为起点,分析统一模型 API、GPU 调度和后训练在生成式媒体中的作用,并讨论推理服务的单位成本、毛利和竞争格局。
Total 229 articles
文章以 Fal 的 E、F 两轮融资为起点,分析统一模型 API、GPU 调度和后训练在生成式媒体中的作用,并讨论推理服务的单位成本、毛利和竞争格局。
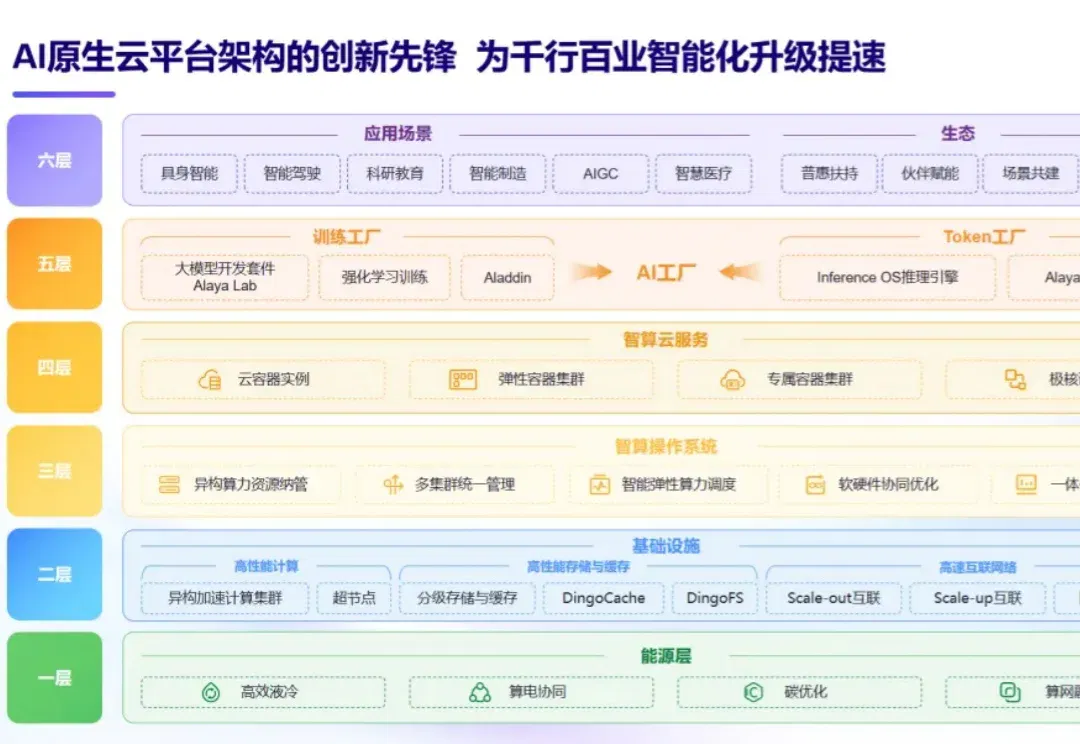
报道介绍九章云极以DCU核算资源投入、以Token记录交付,并通过异构调度及推理优化比较单位成本。公司披露的利用率、客户案例和收入变化反映其经营口径;统一内部计量不等于行业已形成通用结算标准。
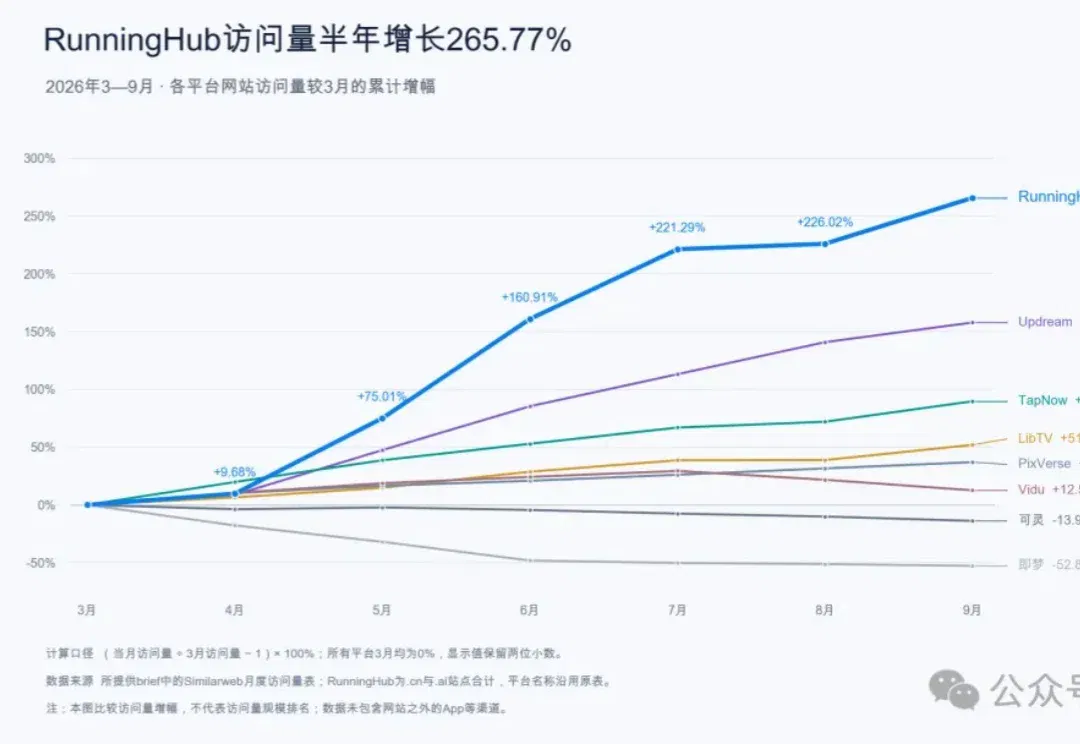
海马云围绕 RunningHub 介绍GPU池化、场景化模型后训练、专业软件连接及创作者工作流沉淀,主张从模型调用走向完整生产交付。访问增速、成本改善和留存数据为报道引用及公司披露,不能据此保证所有AI应用的商业结果。
腾讯云大会以 Manifold AI、RoboScience 和 Zeroth 为例,介绍仿真数据、异构计算、存储及网络如何配合具身模型训练与部署。文中效率数字来自企业具体项目,不能据此认为购买GPU无用,或云端方案适合所有机器人任务。
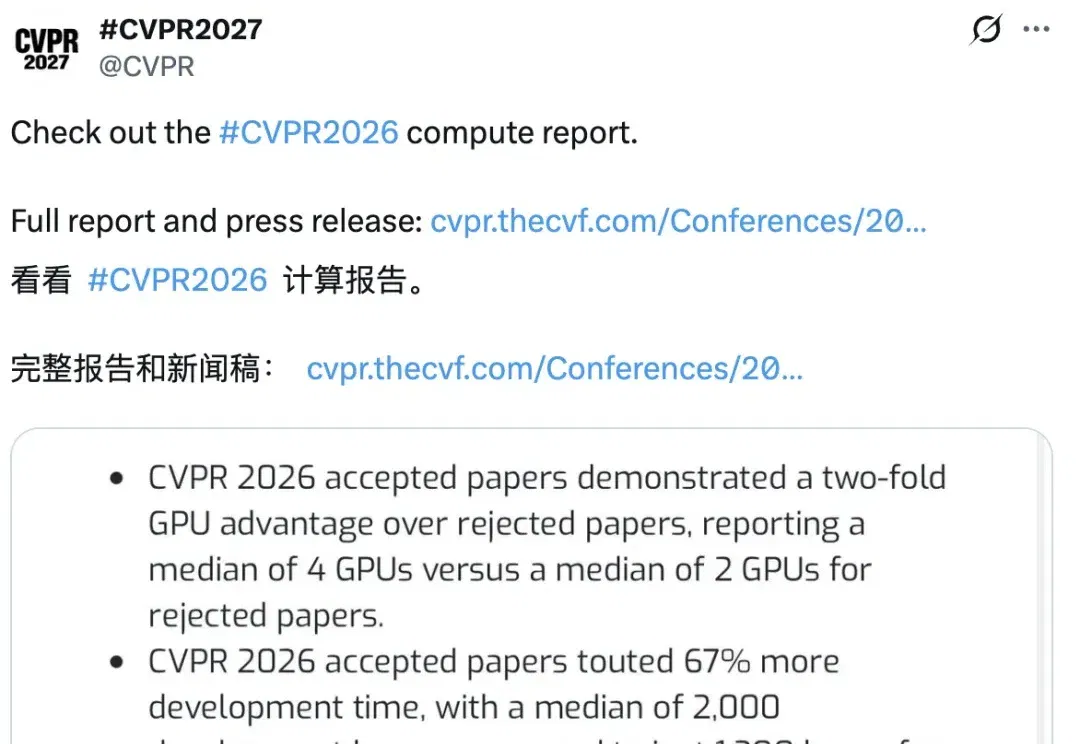
CVPR 2026 汇总16034份投稿算力表,录取与拒稿组的GPU数量中位数分别为4张和2张,研发计算投入也有差异。统计反映相关性,算力数据不向审稿人提供;报告同时展示低算力创新与效率奖励,不能据此推导录取所需的最低卡数。
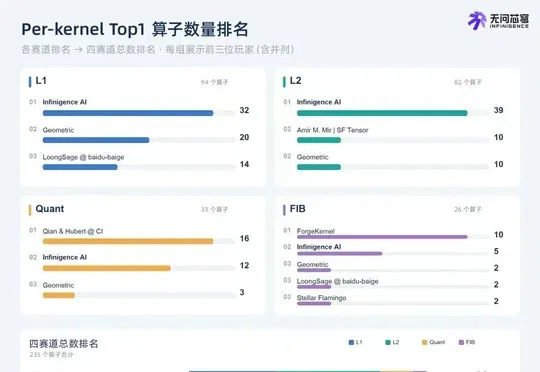
这篇技术报道进一步讨论算子优化 Agent 如何利用隔离评测、Skills 和共享记忆迭代,并呈现 GPU 排队与工作流演化的观察:个体为减少等待而延长占用,可能降低整体效率。文章将资源调度与有效反馈速度联系起来,局部优化仍需端到端验证才能反哺基础设施。
ForgeKernel 通过架构里程碑、硬件经验积累和实测反馈生成优化算子。团队展示了在 B200 上从数学定义出发优化 FlashMLA Prefill 的过程,并介绍昇腾评测与训练框架接入;单个算子的加速幅度不能直接折算为整机性能或全球算力开支节省。
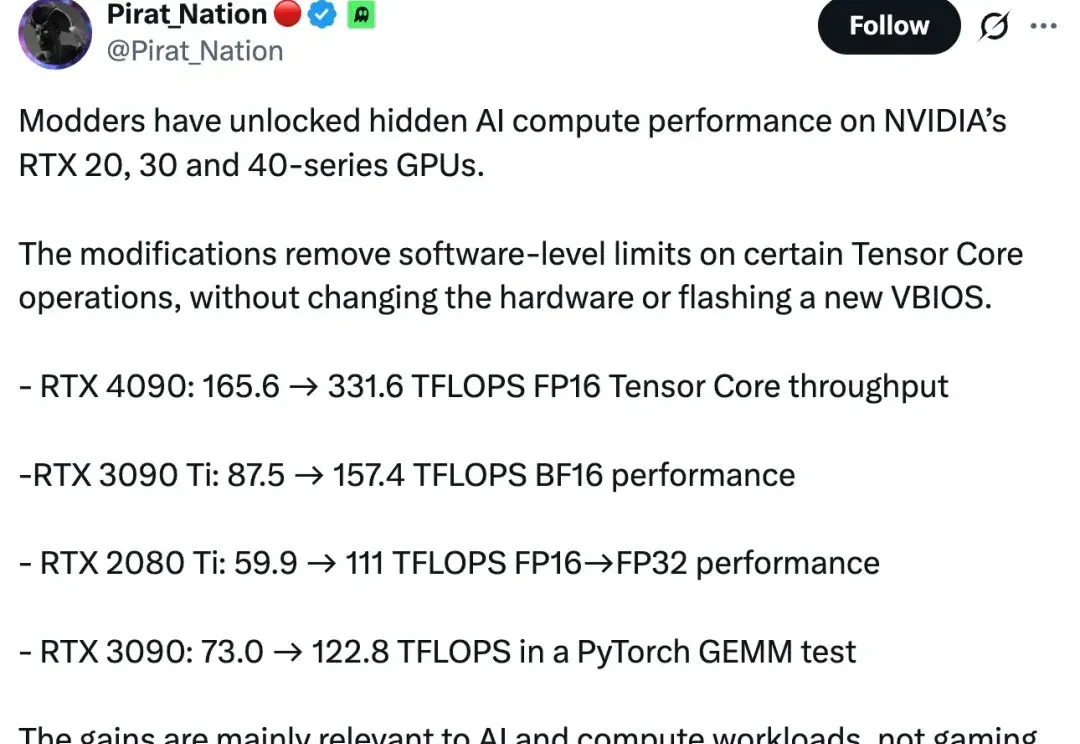
一张 RTX 4090,什么硬件都没换,特定 Tensor Core 运算吞吐率竟然从 165.6 TFLOPS 飙升至 331.6 TFLOPS,直接翻倍!
训练大模型,能不能不用反向传播? 这事一直有人琢磨。只是反向传播太成功了:过去这些年,反向传播一直是训练神经网络的唯一主流算法。我们今天所有的架构、优化器、甚至 GPU 硬件,某种意义上都是围着它长出来的。 但一直有人不信这个邪:反向传播要求整个网络处处可微,这其实是个很强的限制,不可微的模块、离散的计算、外部程序,统统进不了训练回路。 那么,如果算力足够便宜,能不能干脆不「算」梯度了,改用一种最原始的思路 —— 随机把网络改一改,看它变好还是变坏,变好的方向就保留,变坏的就扔掉。这种办法笨是笨,但胜在什么都不挑:不管网络内部长什么样、可不可微,它都能用。 一家叫 Q Labs 的小型研究实验
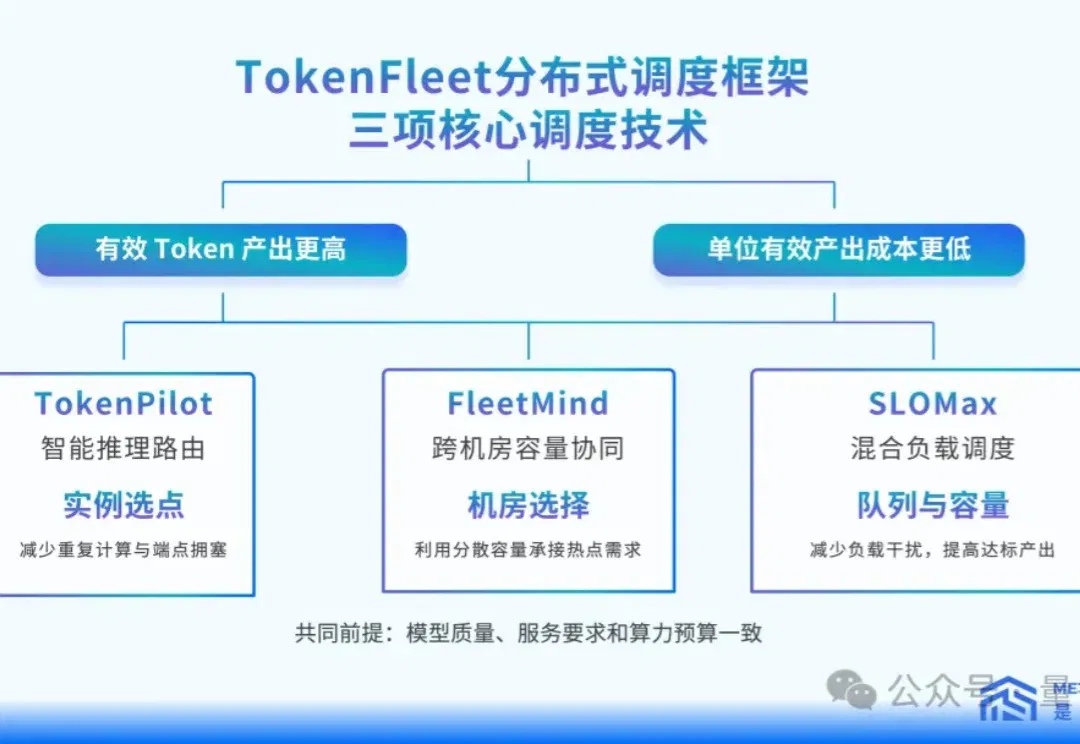
GPU集群里,请求排队和资源闲置,可能同时发生。