Search

Results for “GLM”

Total 109 articles

刚刚,6000亿大模型股王智谱宣布重闯A股,拟募资150亿

刚刚,6000亿大模型股王智谱宣布重闯A股,拟募资150亿 (opens in a new tab)

80%募资金额拟用于基座大模型研发。 其融资金额的120亿元将用于AI通用基座大模型、20亿元将用于大模型MaaS一站式服务平台、10亿元作为补充流动资金。 此外,智谱还发了另一则公告,提名中国政法大学法与经济学研究院院长徐文鸣为第一届董事会独立非执行董事候选人,委任其为董事会薪酬委员会主席及董事会提名委员会成员。任期内,徐文鸣将从智谱领取董事薪酬,税前年薪40万元。 智谱成立于2019年6月,由清华大学计算机系知识工程实验室的技术成果转化而来,清华大学计算机系教授唐杰是智谱的创始人和灵魂人物,担任智谱首席科学家。今年4月1日,智谱开源了其迄今最智能的旗舰模型GLM-5.1,在衡量模型专业软件
AI news
0
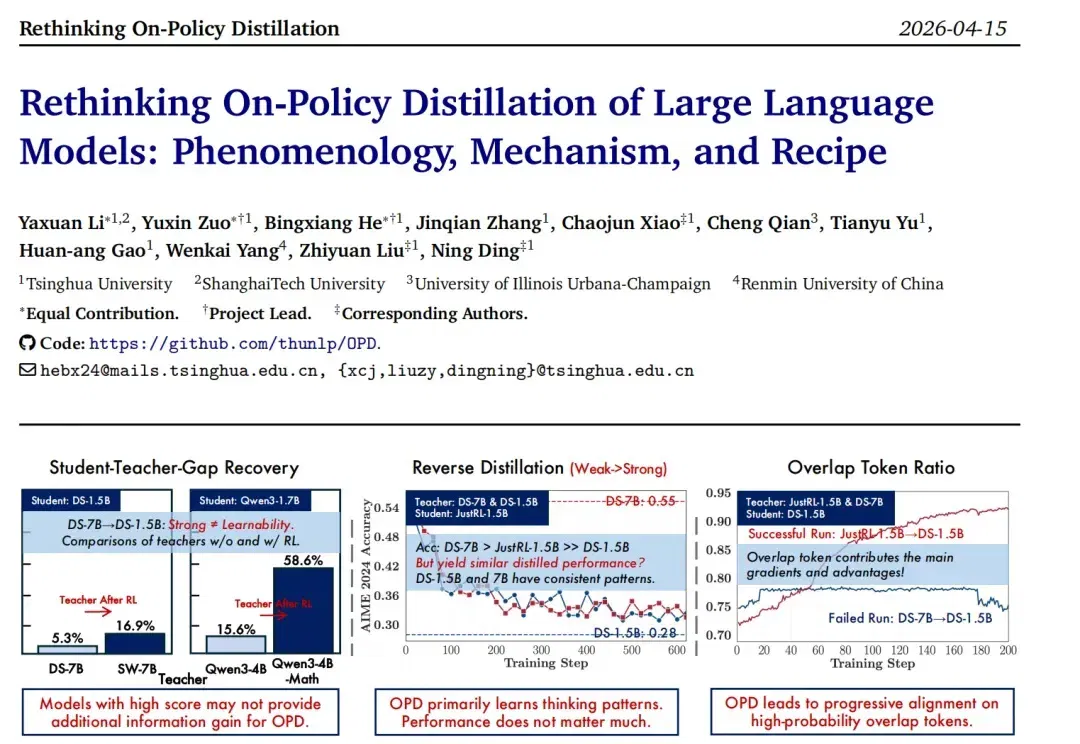
名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」 (opens in a new tab)

当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。

AI guides
0
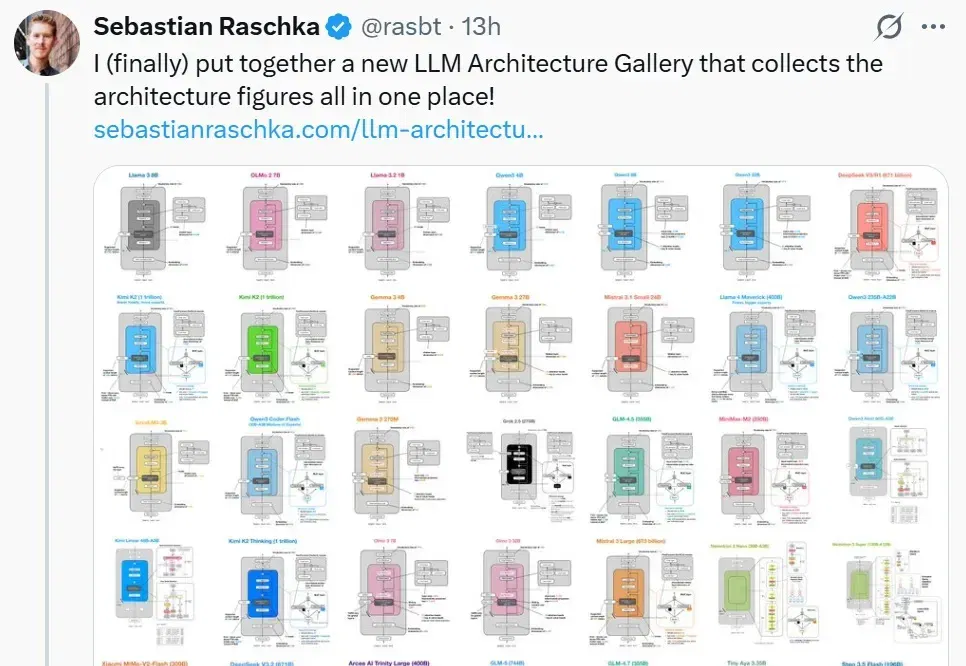
DeepSeek、GPT、Qwen,所有大模型架构图都有,Karpathy:宝藏画廊!

DeepSeek、GPT、Qwen,所有大模型架构图都有,Karpathy:宝藏画廊! (opens in a new tab)

最近几年,大模型赛道好不热闹。 叫得上名字的几乎数都数不过来:从 GPT、Llama、Gemma、Mistral,到 DeepSeek、Qwen、Kimi、GLM、MiniMax 等等,新模型几乎以周更的速度出现。 但问题是,当架构创新越来越多时,理解它们反而变得越来越困难。不同论文里的模型结构图风格各异、模块命名不统一,即便是研究者,也很难快速看清一个模型究竟在哪些地方做出了关键改动。 如果把过去几年主流模型的架构放在一起,你会发现一个明显的空白:我们拥有大量模型,却缺少一张清晰的大模型架构图。 最近,AI 研究者 Sebastian Raschka 就尝试给了这样一张图,他将过去几年主流大

AI guides
0