LeCun力荐的JEPA杀入LLM,用CV的思路训练LLM,性能鲁棒性双丰收 (opens in a new tab)
LeCun 这次不是批评 LLM,而是亲自改造。当前 LLM 的训练(包括预训练、微调和评估)主要依赖于在「输入空间」进行重构与生成,例如预测下一个词。 而在 CV 领域,基于「嵌入空间」的训练目标,如联合嵌入预测架构(JEPA),已被证明远优于在输入空间操作的同类方法。
Total 99 articles
LeCun 这次不是批评 LLM,而是亲自改造。当前 LLM 的训练(包括预训练、微调和评估)主要依赖于在「输入空间」进行重构与生成,例如预测下一个词。 而在 CV 领域,基于「嵌入空间」的训练目标,如联合嵌入预测架构(JEPA),已被证明远优于在输入空间操作的同类方法。
9 月 16 日,OpenAI 正式推出一款新模型 GPT-5-Codex ,这是一个经过微调的 GPT-5 变体,专门为其各种 AI 辅助编程工具而设计。该公司表示,新模型 GPT-5-Codex 的“思考”时间比之前的模型更加动态,完成一项编码任务所需的时间从几秒到七个小时不等。因此,它在代理编码基准测试中表现更佳。
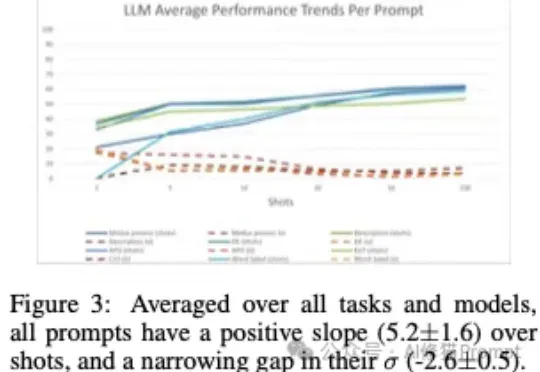
上下文学习”(In-Context Learning,ICL),是大模型不需要微调(fine-tuning),仅通过分析在提示词中给出的几个范例,就能解决当前任务的能力。您可能已经对这个场景再熟悉不过了:您在提示词里扔进去几个例子,然后,哇!大模型似乎瞬间就学会了一项新技能,表现得像个天才。
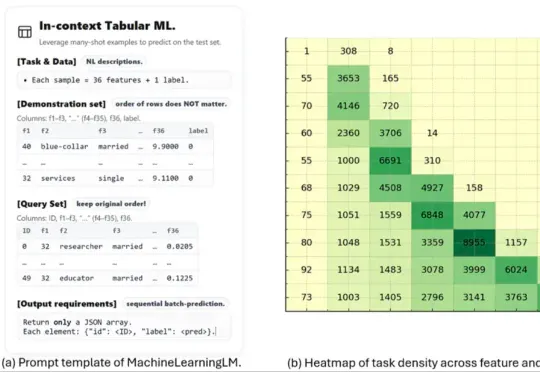
这项名为 MachineLearningLM 的新研究突破了这一瓶颈。该研究提出了一种轻量且可移植的「继续预训练」框架,无需下游微调即可直接通过上下文学习上千条示例,在金融、健康、生物信息、物理等等多个领域的二分类 / 多分类任务中的准确率显著超越基准模型(Qwen-2.5-7B-Instruct)以及最新发布的 GPT-5-mini。
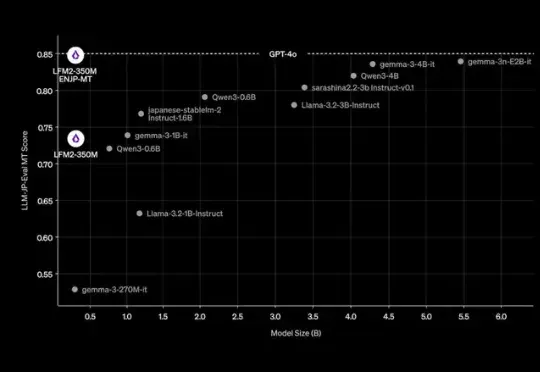
在大模型的竞赛中,参数规模往往被视为性能的决定性因素。但近期,Liquid AI 的研究团队提出了一个不同寻常的案例:一个仅有 3.5 亿参数的模型,经过微调后,竟能在中短上下文的实时日语英语翻译任务上,与 GPT-4o 竞争。
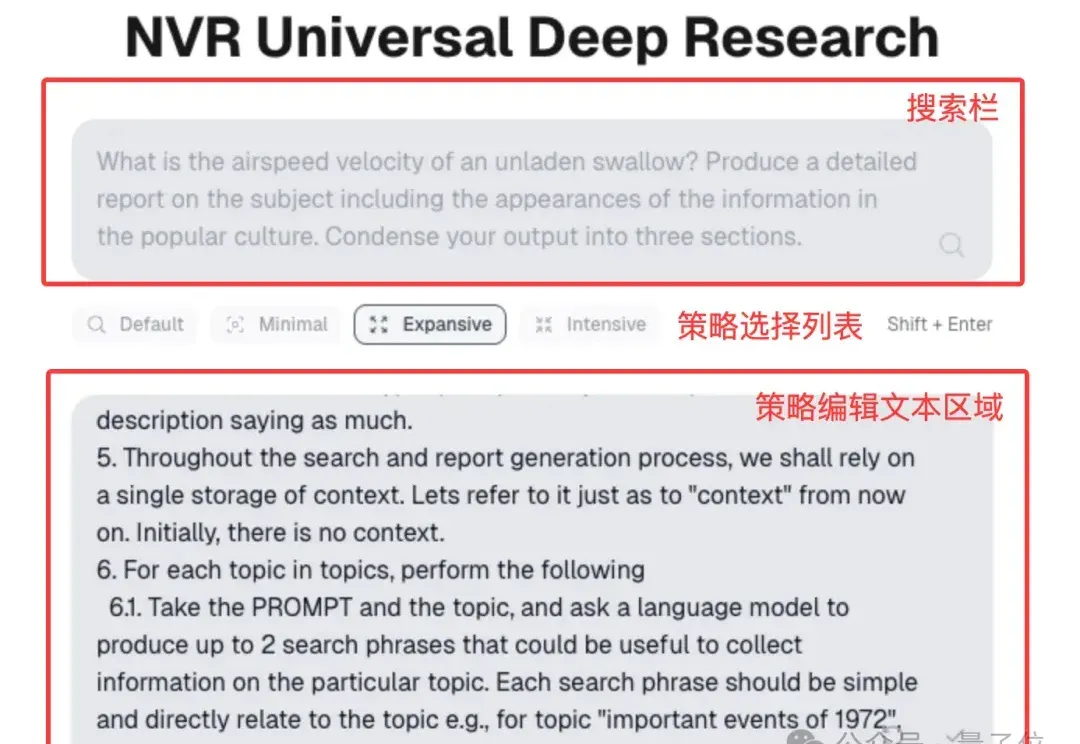
英伟达也做深度研究智能体了。 最新论文介绍了英伟达的通用深度研究(UDR)系统,该系统支持个人定制,可接入任何大语言模型(LLM)。 这意味着它能够围绕任何语言模型运行,用户可以完全自定义深度研究策略,并交给智能体实现。 为展示其通用性,英伟达还为UDR配备了带用户界面的研究演示原型,可在GitHub上下载。 网友认为,它使智能体的自主性得到了突破,非常适合企业工作。 自带模型和策略 论文介绍,以往推出的所有深度研究智能体,都采用硬编码方式,仅能通过固定的工具选择来执行特定研究策略。 而英伟达的UDR系统能够围绕任何LLM运行。 还能使用户能够在无需额外训练或微调的情况下,创建、编辑和优化他们
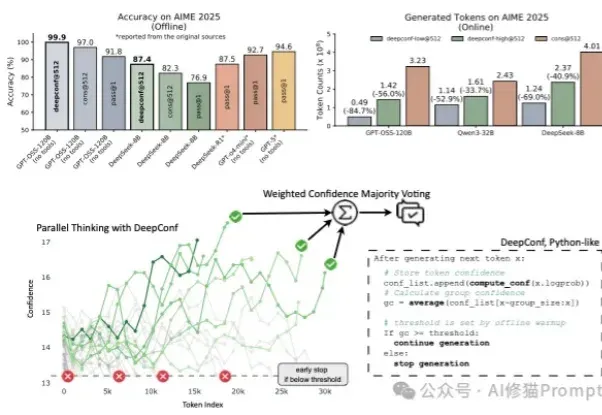
在大型语言模型(LLM)进行数学题、逻辑推理等复杂任务时,一个非常流行且有效的方法叫做 “自洽性”(Self-Consistency),通常也被称为“平行思考”。
在这场以大型语言模型(LLM)为核心的 AI 浪潮中,苹果似乎一直保持着低调,很少出现在技术报道的前沿。尽管如此,时不时地,该公司也能拿出一些非常亮眼的研究成果,比如能在 iPhone 上直接运行的高效视觉语言模型 FastVLM。
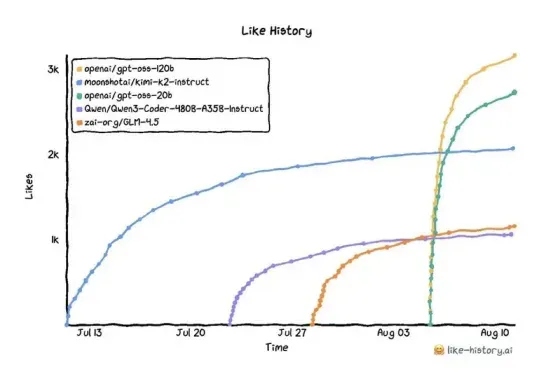
针对OpenAI最新开源的GPT-OSS,这一篇面向零基础小白用户的手把手式的详细训练教程或许能帮助你完成你的第一个GPT训练项目。