Search

Results for “attention”

Total 39 articles

多模态大模型中Attention机制暗藏「骗局」,需用一个公式修正丨上大×南开

多模态大模型中Attention机制暗藏「骗局」,需用一个公式修正丨上大×南开 (opens in a new tab)

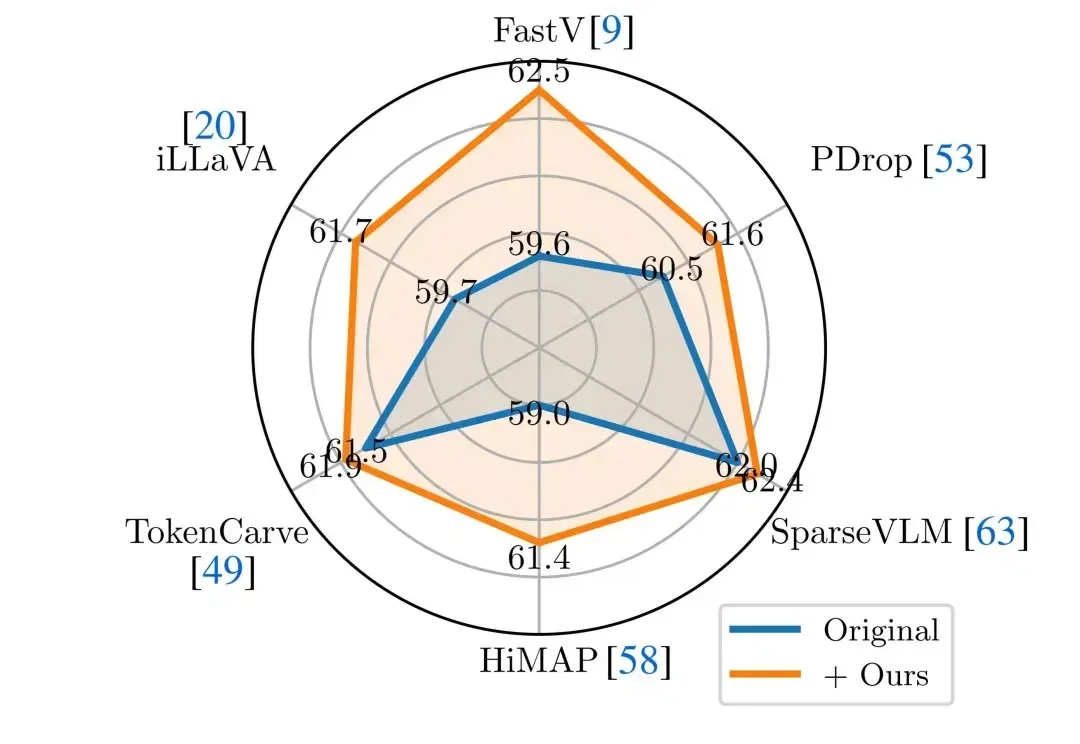
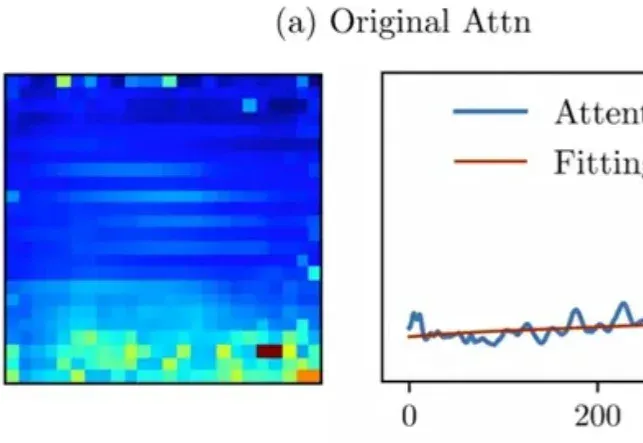
Attention真的可靠吗? 近年来,Vision-Language Models(VLMs)在多模态理解任务中取得了显著进展,尤其是在视觉问答、图像理解和视频理解等场景中,模型通常通过language-to-vision attention来衡量视觉token与文本之间的相关性,并据此进行visual token pruning,以降低推理成本、提升运行效率。 然而,一个长期被忽视的问题是:attention本身是否真的能够作为“语义重要性”的可靠指标? 在最新研究中,上海大学曾丹团队系统分析了主流VLM中attention的行为模式,发现一个关键却容易被忽略的现象——attention并
AI guides
0
少数Full Attention层如何重塑内部计算?混合线性注意力大模型中的「尖峰」与「平台」之谜首次揭开

少数Full Attention层如何重塑内部计算?混合线性注意力大模型中的「尖峰」与「平台」之谜首次揭开 (opens in a new tab)

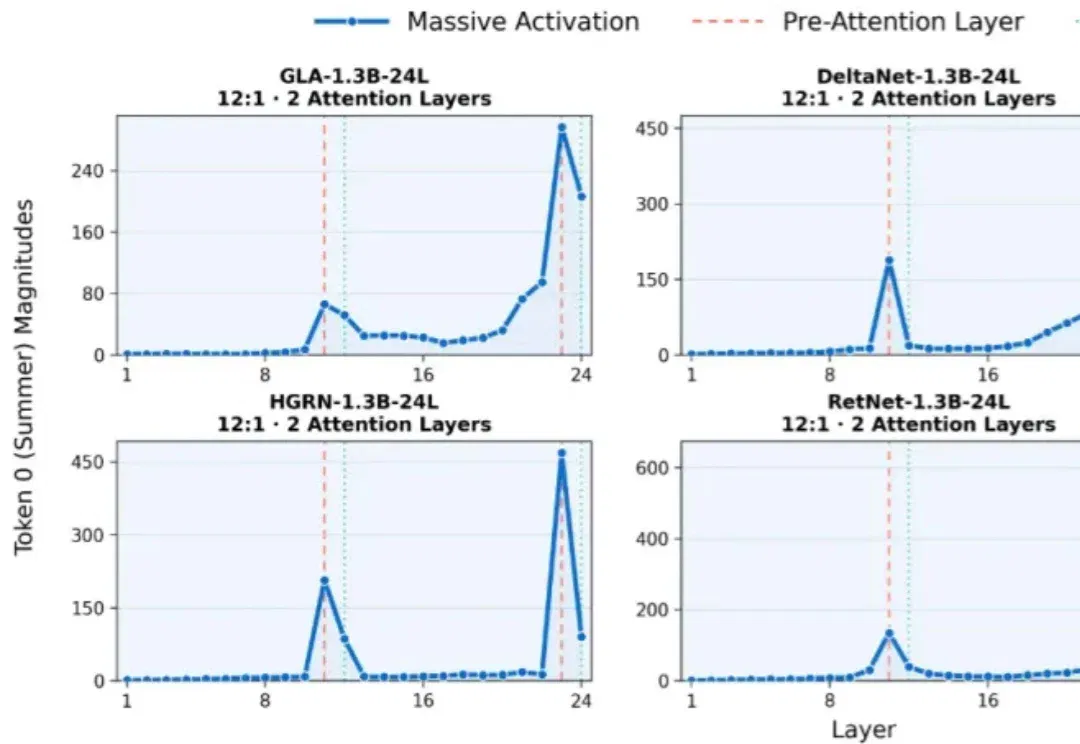
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。

AI guides
0
Attention真的可靠吗?上海大学联合南开大学揭示多模态模型中一个被忽视的重要偏置问题

Attention真的可靠吗?上海大学联合南开大学揭示多模态模型中一个被忽视的重要偏置问题 (opens in a new tab)

近年来,Vision-Language Models(视觉 — 语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。然而,这类模型在实际应用中往往面临推理开销大、效率受限的问题,研究者通常依赖 visual token pruning 等策略降低计算成本,其中 attention 机制被广泛视为衡量视觉信息重要性的关键依据。

AI guides
0
兼得快与好!训练新范式TiM,原生支持FSDP+Flash Attention

兼得快与好!训练新范式TiM,原生支持FSDP+Flash Attention (opens in a new tab)

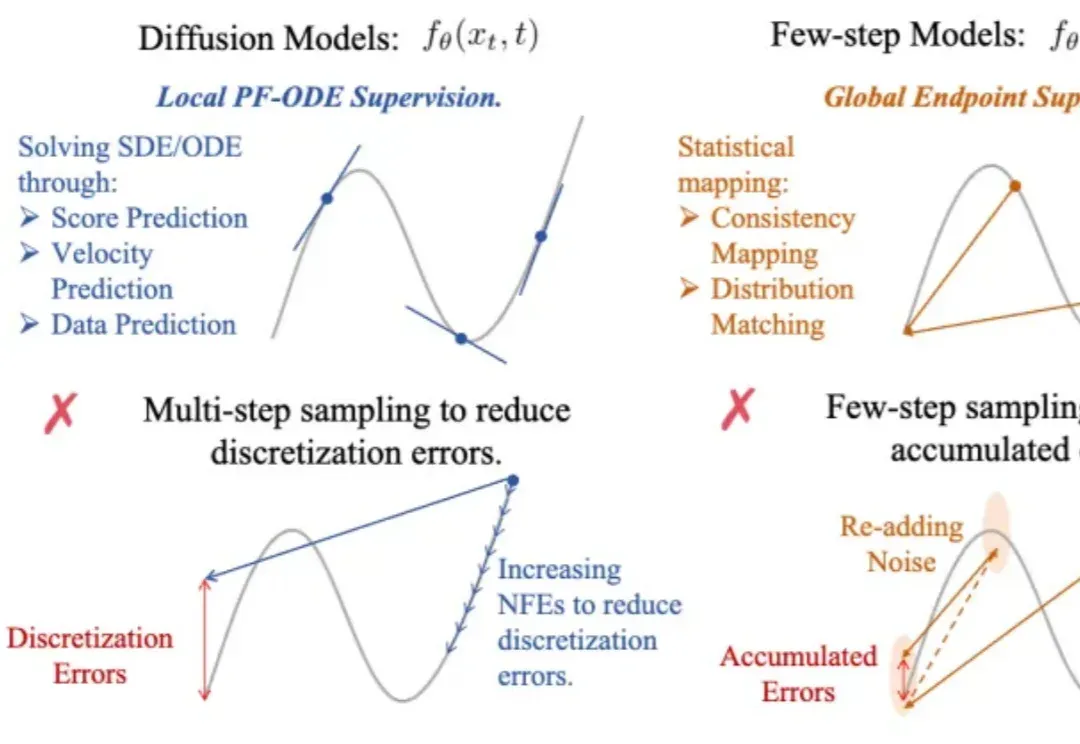
生成式AI的快与好,终于能兼得了? 从Stable Diffusion到DiT、FLUX系列,社区探索了很多技术方法用于加速生成速度和提高生成质量,但是始终围绕扩散模型和Few-step模型两条路线进行开发,不得不向一些固有的缺陷妥协。 这便是训练目标引发的“生成质量”与“生成速度”之间的矛盾根源: 要么只监督无穷小局部动力学(PF-ODE),要么只学习有限区间的端点映射,两者都各有内在限制。 一项新研究提出了名为Transition Model(TiM)的新范式,试图从根本上解决这一矛盾。 它放弃了传统扩散模型学习“瞬时速度场”或Few-step模型学习“端点映射”的做法,转而直接建模任意两

AI guides
0
独家|Vattention 获数百万美元投资:从非线性到指数剪辑,定义视频编辑3.0时代

独家|Vattention 获数百万美元投资:从非线性到指数剪辑,定义视频编辑3.0时代 (opens in a new tab)

据悉,专注视频后期 AI Agent 的 Vattention(时空注力)已完成数百万美元种子轮融资,由青锐资本、百度风投、常垒资本联合投资。该公司由计算机科班出身、曾任阿里淘系核心产品总监、沉浸专业视频制作领域多年的连续创业者钟超(花名 船长)创立。本轮融资将主要用于核心团队组建与技术研发,推动其三大核心引擎(MACE、ACE、PACE)的产品化落地。

AI news
0
AAAI 2026 Oral | 告别注意力与热传导!北大清华提出WaveFormer,首创波动方程建模视觉

AAAI 2026 Oral | 告别注意力与热传导!北大清华提出WaveFormer,首创波动方程建模视觉 (opens in a new tab)

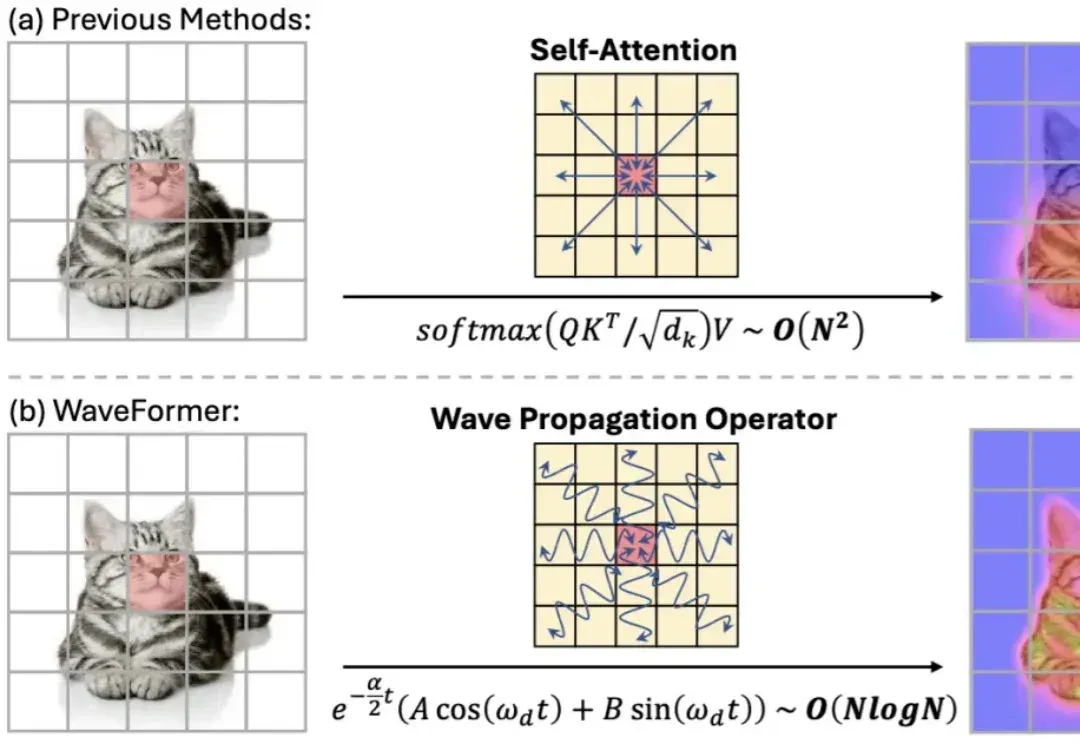
“全局交互” 几乎等同于 self-attention:每个 token 都能和所有 token 对话,效果强,但代价也直观 —— 复杂度随 token 数平方增长,分辨率一高就吃不消。现有方法大多从 “相似度匹配” 出发(attention),或从 “扩散 / 传导” 出发(热方程类方法)。但热方程本质上是一个强低通滤波器:随着传播时间增加,高频细节(边缘、纹理)会迅速消失,导致特征过平滑。

AI guides
0
Kimi K3:智能的新前沿

Kimi K3:智能的新前沿 (opens in a new tab)

Kimi K3 是一个 2.8 万亿参数模型,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。

AI news
0