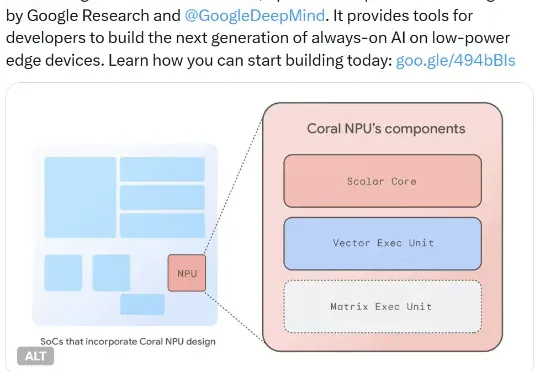
谷歌开源全栈平台Coral NPU,能让大模型在手表上全天候运行 (opens in a new tab)
他们又推出了 Coral NPU,可用于构建在低功率设备上持续运行的 AI。具体来说,其可在可穿戴设备上运行小型 Transformer 模型和 LLM,并可通过 IREE 和 TFLM 编译器支持 TensorFlow、JAX 和 PyTorch。
Total 45 articles
他们又推出了 Coral NPU,可用于构建在低功率设备上持续运行的 AI。具体来说,其可在可穿戴设备上运行小型 Transformer 模型和 LLM,并可通过 IREE 和 TFLM 编译器支持 TensorFlow、JAX 和 PyTorch。
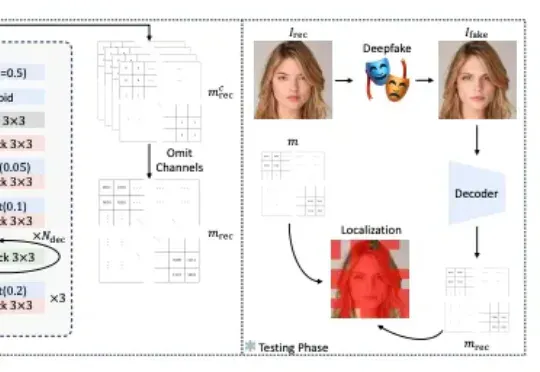
该论文提出 FractalForensics,一种基于分形水印的主动深度伪造检测与定位方法。不同于以往的水印向量,为达成伪造定位的功能,论文提出的水印以矩阵形式出现。
一篇入围顶会NeurIPS’25 Oral的论文,狠狠反击了一把DiT(Diffusion Transformer)。这篇来自字节跳动商业化技术团队的论文,则是提出了一个名叫InfinityStar的方法,一举兼得了视频生成的质量和效率,为视频生成方法探索更多可能的路径。
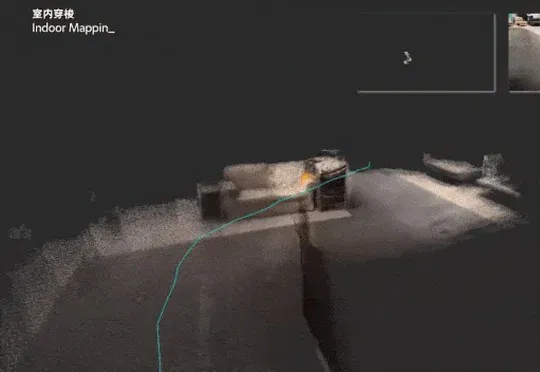
蚂蚁灵波开源的流式3D重建模型LingBot-Map凭借几何上下文注意力机制在GitHub获16.9K Stars后,其论文入选ECCV 2026 Oral,全球开发者围绕该项目完成Apple Silicon桌面前端、RTX 4060低显存适配及Ray-Ban Meta智能眼镜采集等多种二次开发。
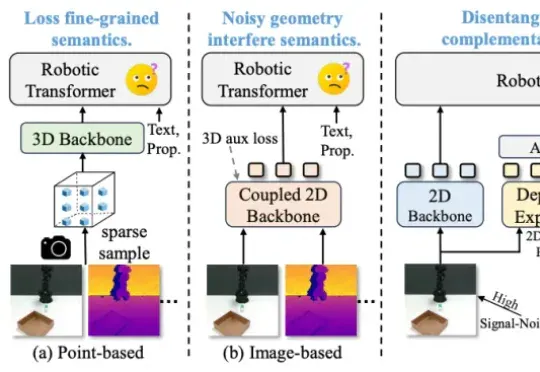
作者在包含 50 多个任务的多个仿真和真实世界场景中评估了 SpatialActor。它在 RLBench 上取得了 87.4% 的成绩,达到 SOTA 水平;在不同噪声条件下,性能提升了 13.9% 至 19.4%,展现出强大的鲁棒性。目前该论文已被收录为 AAAI 2026 Oral,并将于近期开源。
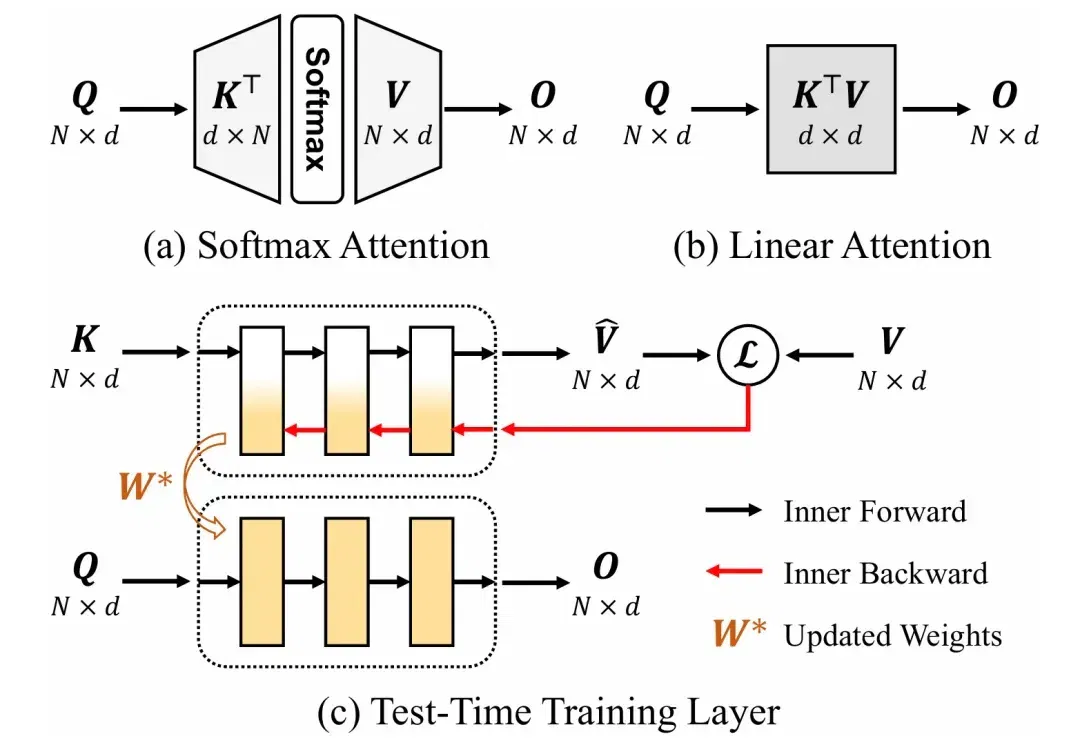
序列建模是大语言模型、计算机视觉等领域的基础共性问题。当前通用的 Transformer 模型计算复杂度随序列长度平方增长,在长序列任务中面临显著的计算挑战。因此,研究者们一直在探索具有线性计算复杂度的高效序列建模方法。
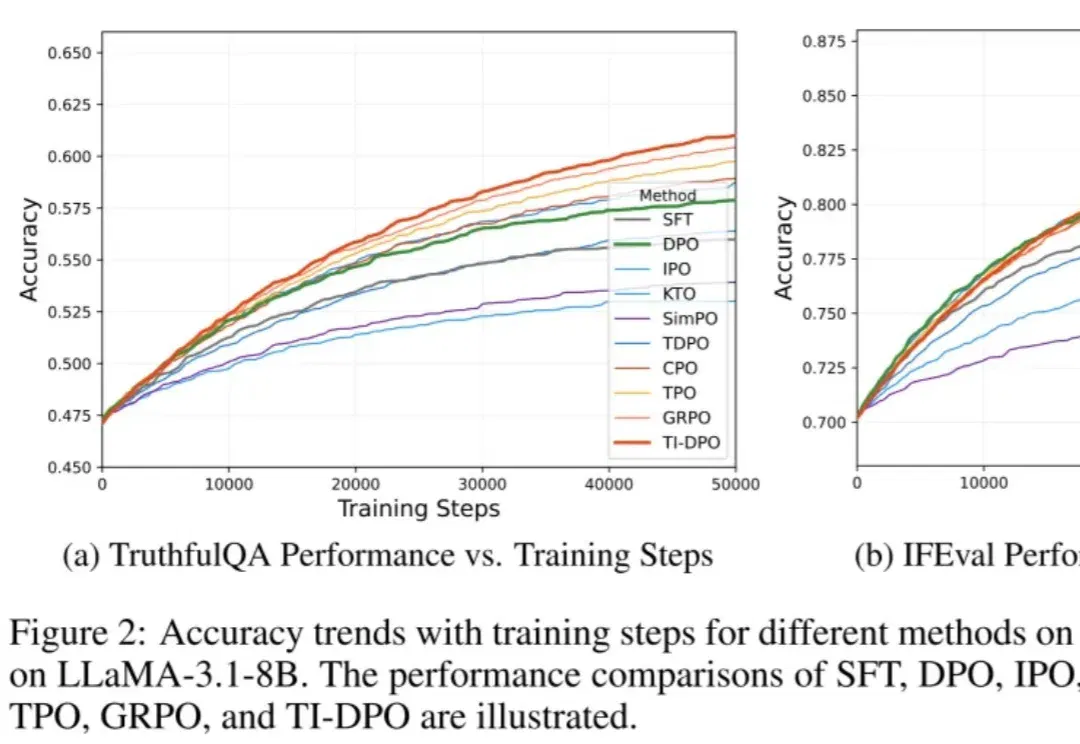
在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。
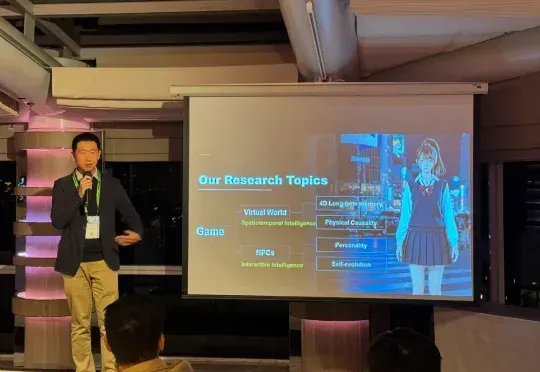
在 SIGGRAPH Asia 2025 期间,盛大 AI 东京研究院(Shanda AI Research Tokyo)以展台活动、BoF 学术讨论与顶尖教授闭门交流等形式完成首次公开亮相,标志着盛大在数字人的 “交互智能 (Interactive Intelligence)” 与世界模型的 “时空智能 (Spatiotemporal Intelligence)” 等两大方向的研究
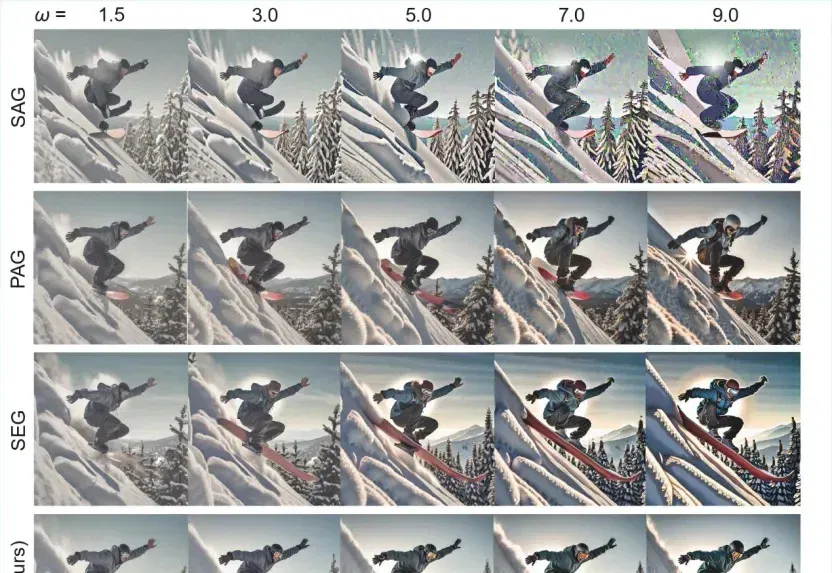
扩散模型又被玩出新花样了。 一直以来,提高扩散模型生成质量的关键手段,是在推理阶段加入引导(guidance)。 要么依赖文本条件(如CFG)——需要专门的训练策略,没有文本条件就不能用; 要么靠显式加噪破坏模型推理——然而效果有限。 现在,一种全新的思路来了: 不需要文本条件,不加噪声,不改模型,只在内部交换token。 来自上海交大和vivo的研究者提出了一种十分简单但非常有效的方法:自交换引导(Self-Swap Guidance,SSG)。该工作已被CVPR 2026国际会议接收为Oral。 一句话总结: 通过在空间和通道维度上交换token特征,把模型“搞差”,再用这个“变差”的路径
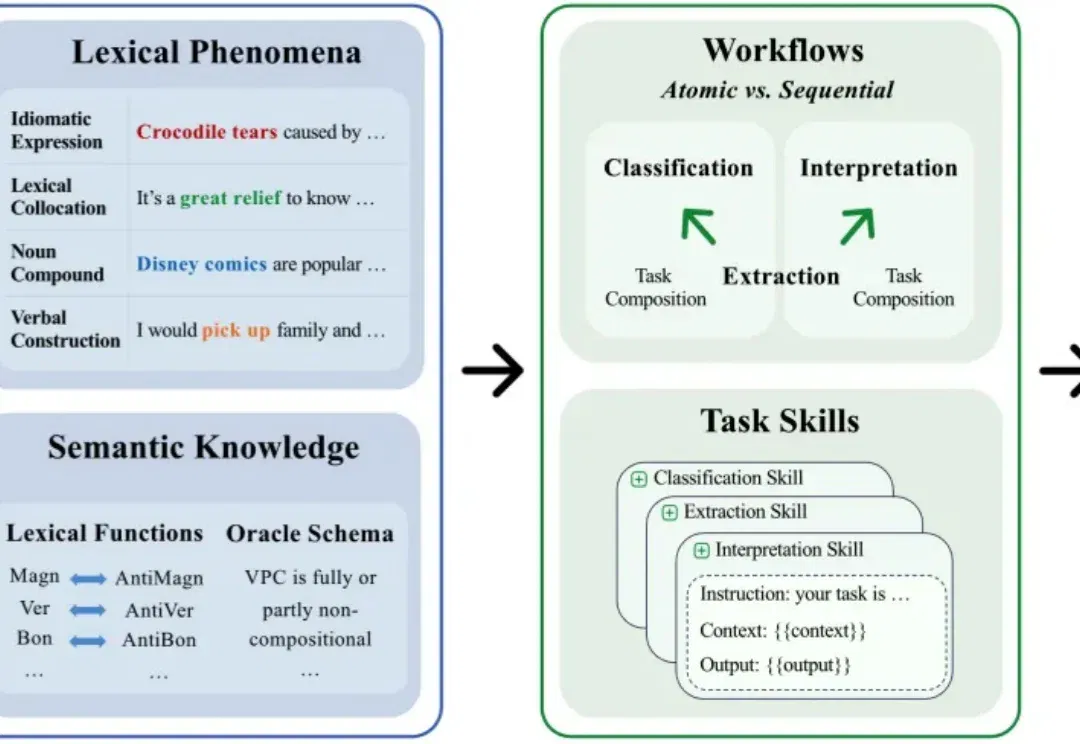
AI 的能力边界正在不断被刷新。从数学推理到代码生成,再到数字化白领,语言模型和语言智能体在诸多基准测试中已展现出超越人类专家的表现。一个看似顺理成章的判断早已成为共识:语言模型已经具备了扎实的语言理解和语义推理能力。然而,ACL 2026 Oral 的一项研究工作从一个更基础的层面重新审视了这个问题:语言模型真的理解(短语)语义吗?