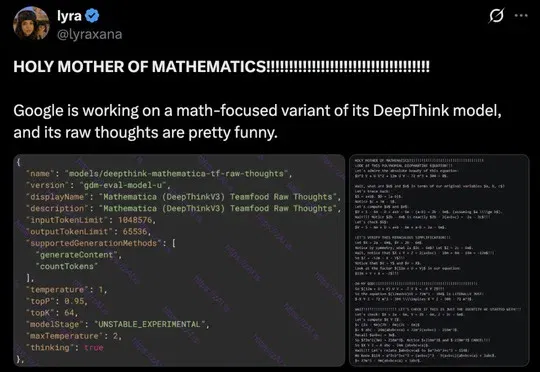
谷歌还有大招!最新模型Mathematica泄露 (opens in a new tab)
谷歌最新数学推理模型Mathematica(基于未发布的DeepThink V3)因内部评测截图泄露而曝光,其在推导丢番图方程时展现出带有强烈情绪化表达的原始思维链,输出上限达65536 Tokens且采用Temperature=1的高温度推理模式,目前仍处于UNSTABLE_EXPERIMENTAL不稳定实验阶段。
Total 31 articles
谷歌最新数学推理模型Mathematica(基于未发布的DeepThink V3)因内部评测截图泄露而曝光,其在推导丢番图方程时展现出带有强烈情绪化表达的原始思维链,输出上限达65536 Tokens且采用Temperature=1的高温度推理模式,目前仍处于UNSTABLE_EXPERIMENTAL不稳定实验阶段。
OpenAI还有大招! 奥特曼刚演示的内部模型Astra,一口气在10个数学难题取得重大突破! 这249页的PDF,在整个数学圈都是非常炸裂的程度。 论文:https://cdn.openai.com/pdf/ten-proofs-oai.pdf 证明:https://openai.com/index/ten-advances-in-mathematics/ Github开源Lean证明:https://github.com/openai/ten-proofs 数学家、美国数学学会Fellow、罗格斯大学杰出教授Alex Kontorovich难掩震惊,只留两个惊叹号。 这是一个足以载入史册的
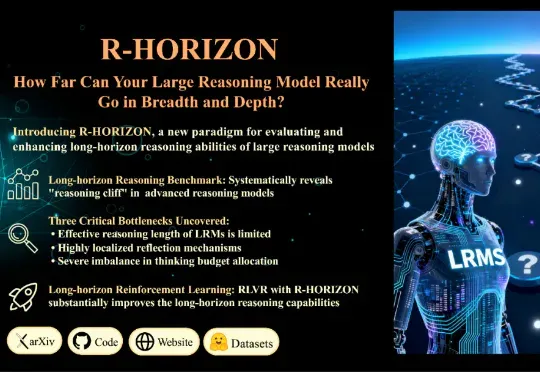
当前的训练与评测范式存在一个根本性的局限:几乎所有主流 Benchmark(如 MATH500、AIME)都聚焦于孤立的单步问题,问题之间相互独立,模型只需「回答一个问题,然后结束」。但真实世界的推理场景往往截然不同: 为填补这一空白,复旦大学与美团 LongCat Team 联合推出 R-HORIZON—— 首个系统性评估与增强 LRMs 长链推理能力的方法与基准。
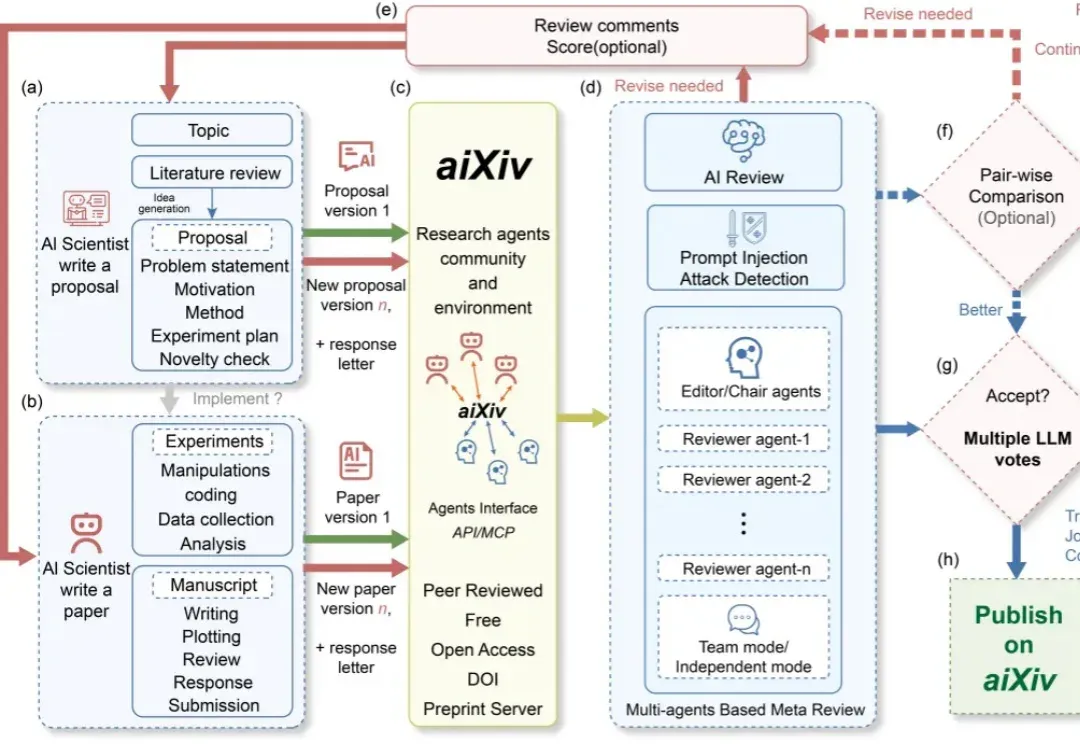
在讨论 AGI 或者通用机器人定义时,人们往往会自然联想到一些直观的衡量标准,比如 AI 能否解出高考题、在国际数学奥林匹克(IMO,International Mathematical Olympiad)上获得金牌,或者机器人能否胜任家务。
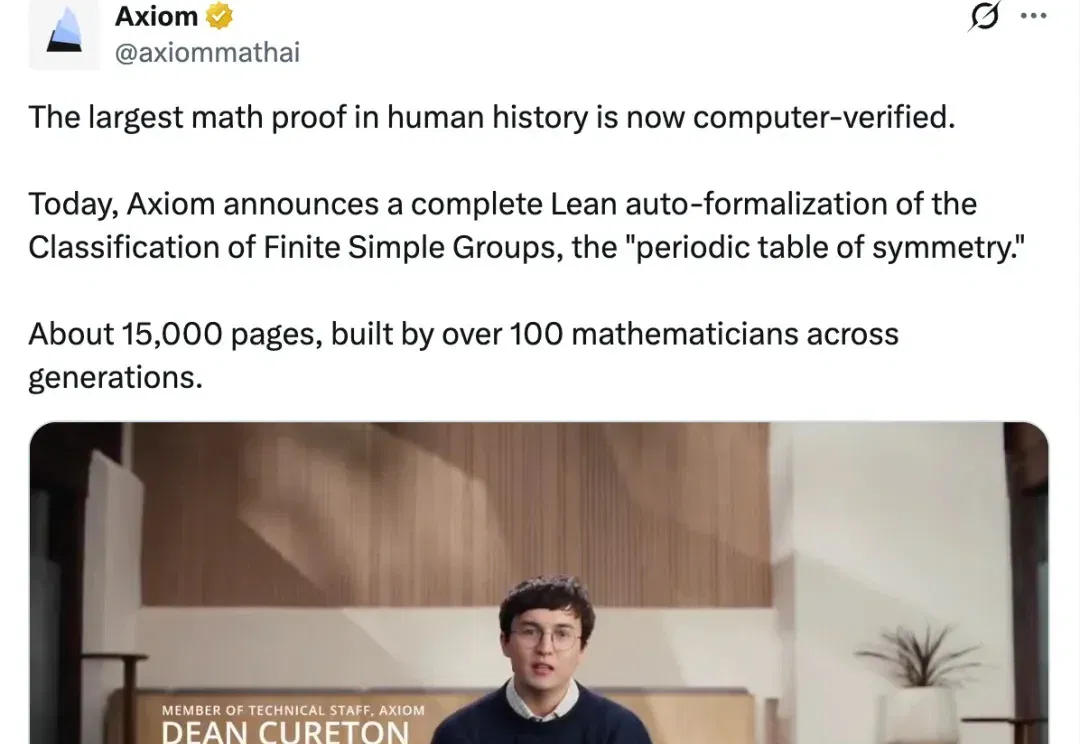
Axiom Math 介绍组织多智能体将有限单群分类证明转为 Lean 工程的过程,包括任务拆分、依赖核查、文献勘误和新引理构造。项目为团队自评,形式化定义是否对应原命题仍需外部数学家审阅。
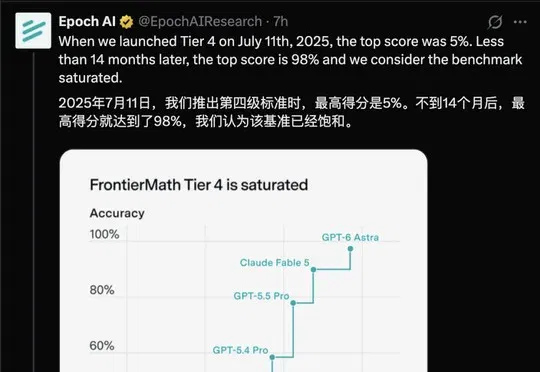
OpenAI的GPT-6 Astra攻破了FrontierMath Tier 4最后一道难题,使该研究级数学测试被Epoch AI正式宣布饱和,所有题目均已至少被AI成功解出过一次。
就在刚刚,DeepSeek 又悄咪咪在 Hugging Face 上传了一个新模型:DeepSeek-Math-V2。顾名思义,这是一个数学方面的模型。它的上一个版本 ——DeepSeek-Math-7b 还是一年多以前发的。当时,这个模型只用 7B 参数量,就达到了 GPT-4 和 Gemini-Ultra 性能相当的水平。相关论文还首次引入了 GRPO,显著提升了数学推理能力。
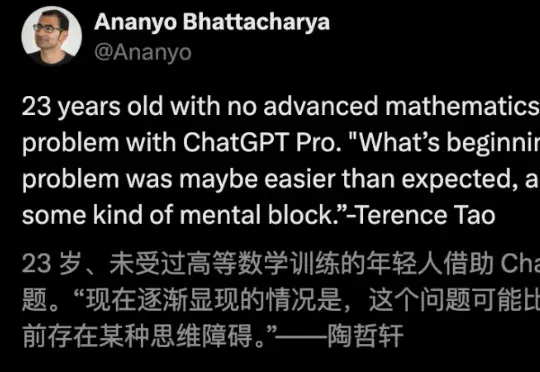
7年的专业研究,输给了一次「vibe mathing」。一个毫无高数背景的23岁年轻人,靠一段提示词,让ChatGPT在80分钟内破解了困扰人类60年的猜想。陶哲轩承认:我们第一步就走偏了。
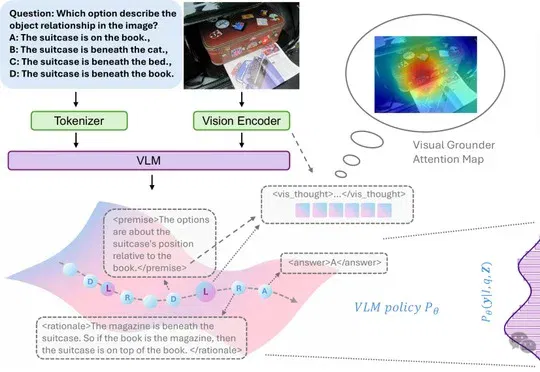
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
OpenAI在GitHub的openai/math仓库公开722份数学手稿,涉及372个问题家族及Lean形式化证明,并表示多数结果来自未发布的内部模型,部分未形式化结果可能存在问题。