Search

Results for “LongCat”

Total 29 articles

美团也开源了大模型,但我觉得他们的野心是通用生活Agent。

美团也开源了大模型,但我觉得他们的野心是通用生活Agent。 (opens in a new tab)

起猛了,美团这下真的开始明牌干AI了。 居然,发布并直接开源了560B参数的MoE模型LongCat-Flash-Chat。 好家伙,WAIMAI里有两个AI,这次成真的了,美团真发大模型了。 开源地址:https://github.com/meituan-longcat/LongCat-Flash-Chat 也有线上体验地址:https://longcat.ai 我自己去体验了一下,整体模型能力,中规中矩,但是快,是真的快,能把560B的模型,在推理的时候搞得这么快,是真的有点牛逼的。 我直接录了个屏给大家看一下。 这里我们可以直观对比一下LongCat和DeepSeek V3的输出速度,A
AI news
0
美团王兴,又开源一款大模型!

美团王兴,又开源一款大模型! (opens in a new tab)

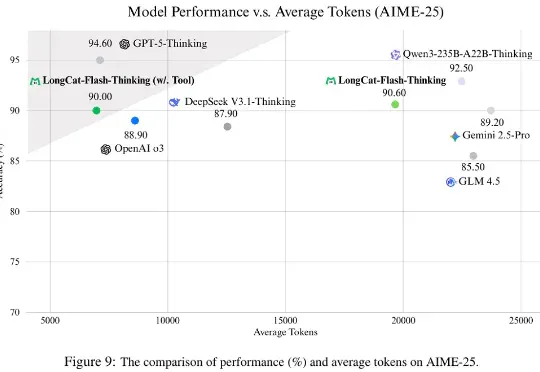
最近,美团在AI开源赛道上在猛踩加速。今天,在开源其首款大语言模型仅仅24天后,美团又开源了其首款自研推理模型LongCat-Flash-Thinking。与其基础模型LongCat-Flash类似,效率也是LongCat-Flash-Thinking的最大特点。美团在技术报告中透露,LongCat-Flash-Thinking在自研的DORA强化学习基础设施完成训练

AI guides
0
实测美团 LongCat:快到极致,但是别说追平 DeepSeek

实测美团 LongCat:快到极致,但是别说追平 DeepSeek (opens in a new tab)

用过才知道,「快」不是万能药。 如果你这几天刷社交媒体,应该已经注意到,美团的 LongCat-Flash-Chat 正在频频刷屏,标题大多是将其与 DeepSeek 作对比,称美团推出的第一款开源大模型已经追平了 DeepSeek-V3.1。 事实果真如此吗?AI 科技评论想要一探究竟。 首先可以确定的是,这款模型上是一款面向日常对话与轻量问答的中量级对话模型,560B总参数,稍小于 DeepSeek-V3.1 的 671B,但是两者都采用了 MoE 架构。前者强调延迟控制与高并发下的流畅体验,后者逻辑拆解与复杂问题的处理能力更强。 LongCat 这款模型最大的标签就是“快”,几乎零延迟的

AI reviews
0
R-HORIZON:长程推理时代来临,复旦NLP&美团LongCat重磅发布LRMs能力边界探测新范式

R-HORIZON:长程推理时代来临,复旦NLP&美团LongCat重磅发布LRMs能力边界探测新范式 (opens in a new tab)

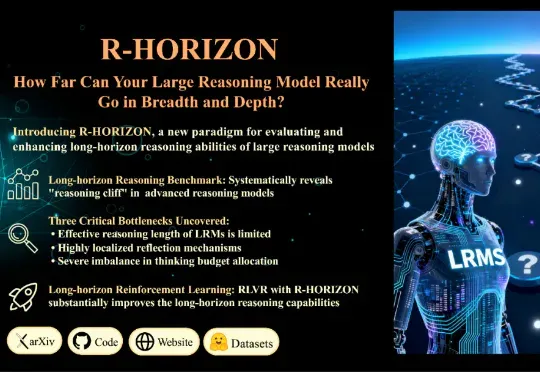
当前的训练与评测范式存在一个根本性的局限:几乎所有主流 Benchmark(如 MATH500、AIME)都聚焦于孤立的单步问题,问题之间相互独立,模型只需「回答一个问题,然后结束」。但真实世界的推理场景往往截然不同: 为填补这一空白,复旦大学与美团 LongCat Team 联合推出 R-HORIZON—— 首个系统性评估与增强 LRMs 长链推理能力的方法与基准。

AI guides
0
美团又上新模型,8个Thinker齐开工,能顶个诸葛亮?

美团又上新模型,8个Thinker齐开工,能顶个诸葛亮? (opens in a new tab)

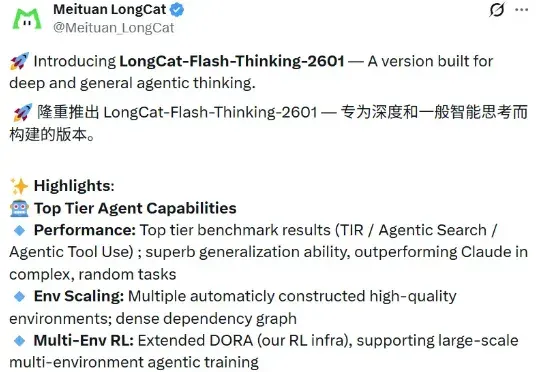
美团也重磅更新自家模型 ——LongCat-Flash-Thinking-2601。这是一款强大高效的大规模推理模型,拥有 5600 亿个参数,基于创新的 MoE 架构构建。该模型引入了强大的重思考模式(Heavy Thinking Mode),能够同时启动 8 路思考并最终总结出一个更全面、更可靠的结论。目前重思考模式已在 LongCat AI 平台正式上线,人人均可体验。

AI news
0
AI点外卖哪家强,美团LongCat团队做了个全面评测

AI点外卖哪家强,美团LongCat团队做了个全面评测 (opens in a new tab)

美团LongCat团队发布了当前高度贴近真实生活场景、面向复杂问题的大模型智能体评测基准——VitaBench(Versatile Interactive Tasks Benchmark)。VitaBench以外卖点餐、餐厅就餐、旅游出行三大高频生活场景为典型载体,构建了一个包含66个工具的交互式评测环境,并设计了跨场景综合任务。

AI guides
0