FG-CLIP 2: 为细粒度跨模态理解而生的下一代VLM,8大类29项任务双语性能全球第一 (opens in a new tab)
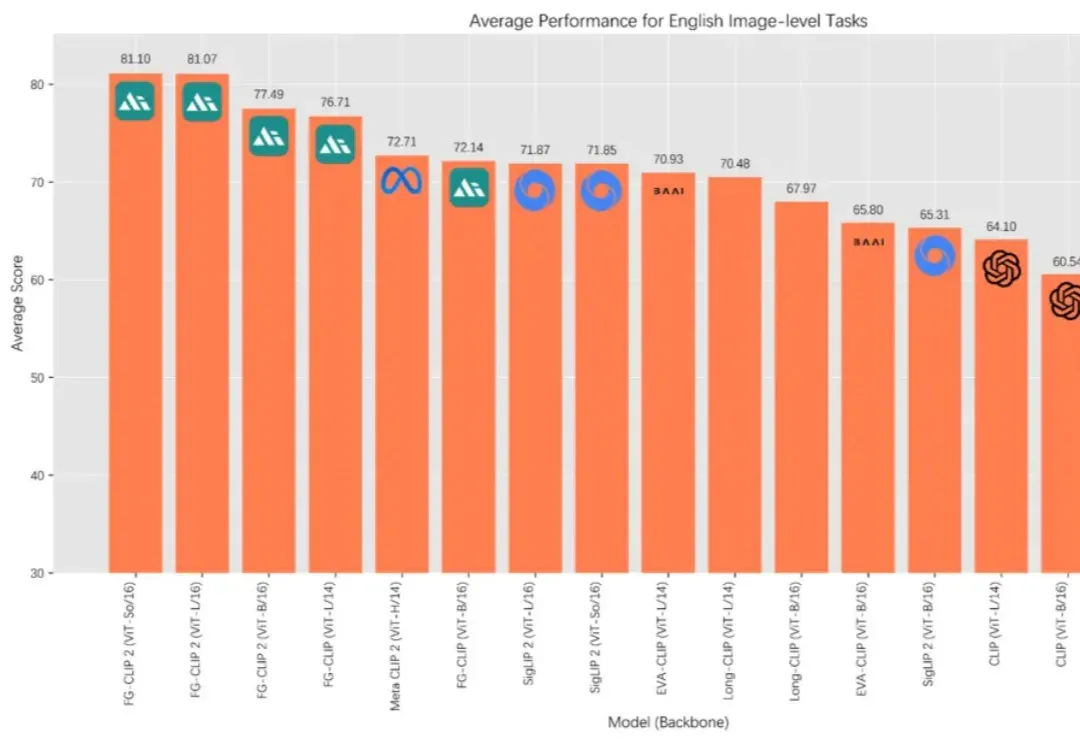
在 AI 多模态的发展历程中,OpenAI 的 CLIP 让机器第一次具备了“看懂”图像与文字的能力,为跨模态学习奠定了基础。如今,来自 360 人工智能研究院冷大炜团队的 FG-CLIP 2 正式发布并开源,在中英文双语任务上全面超越 MetaCLIP 2 与 SigLIP 2,并通过新的细粒度对齐范式,补足了第一代模型在细节理解上的不足。
Total 19 articles
在 AI 多模态的发展历程中,OpenAI 的 CLIP 让机器第一次具备了“看懂”图像与文字的能力,为跨模态学习奠定了基础。如今,来自 360 人工智能研究院冷大炜团队的 FG-CLIP 2 正式发布并开源,在中英文双语任务上全面超越 MetaCLIP 2 与 SigLIP 2,并通过新的细粒度对齐范式,补足了第一代模型在细节理解上的不足。
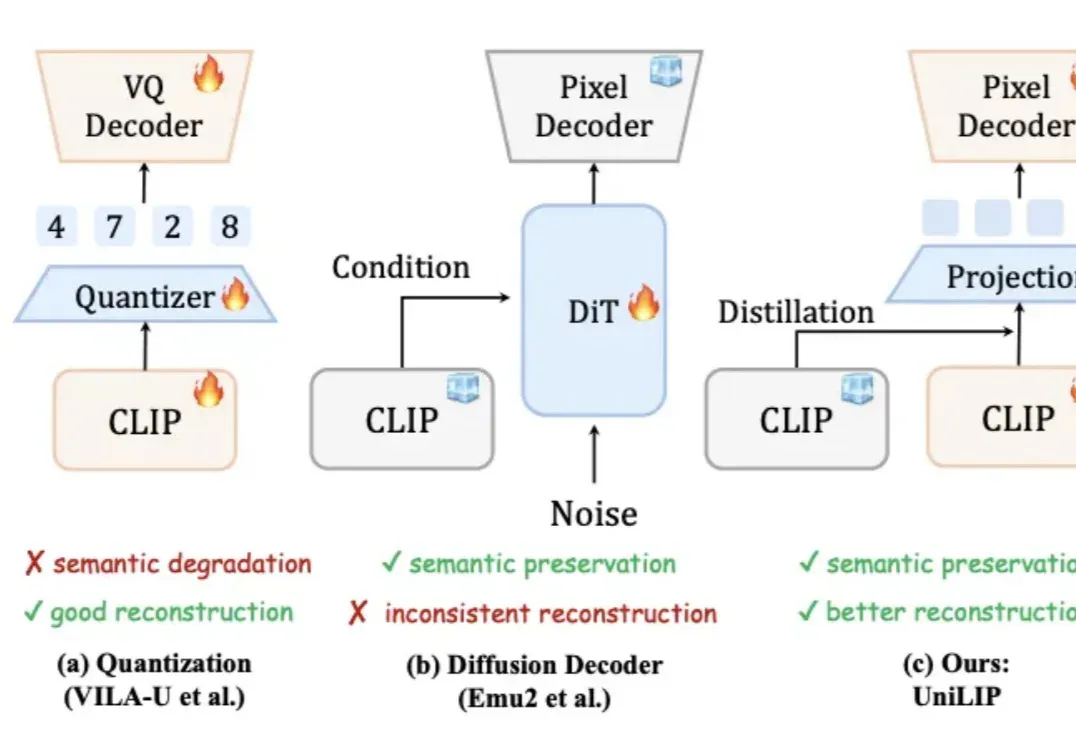
统一多模态模型要求视觉表征必须兼顾语义(理解)和细节(生成 / 编辑)。早期 VAE 因语义不足而理解受限。近期基于 CLIP 的统一编码器,面临理解与重建的权衡:直接量化 CLIP 特征会损害理解性能;而为冻结的 CLIP 训练解码器,又因特征细节缺失而无法精确重建。例如,RAE 使用冻结的 DINOv2 重建,PSNR 仅 19.23。
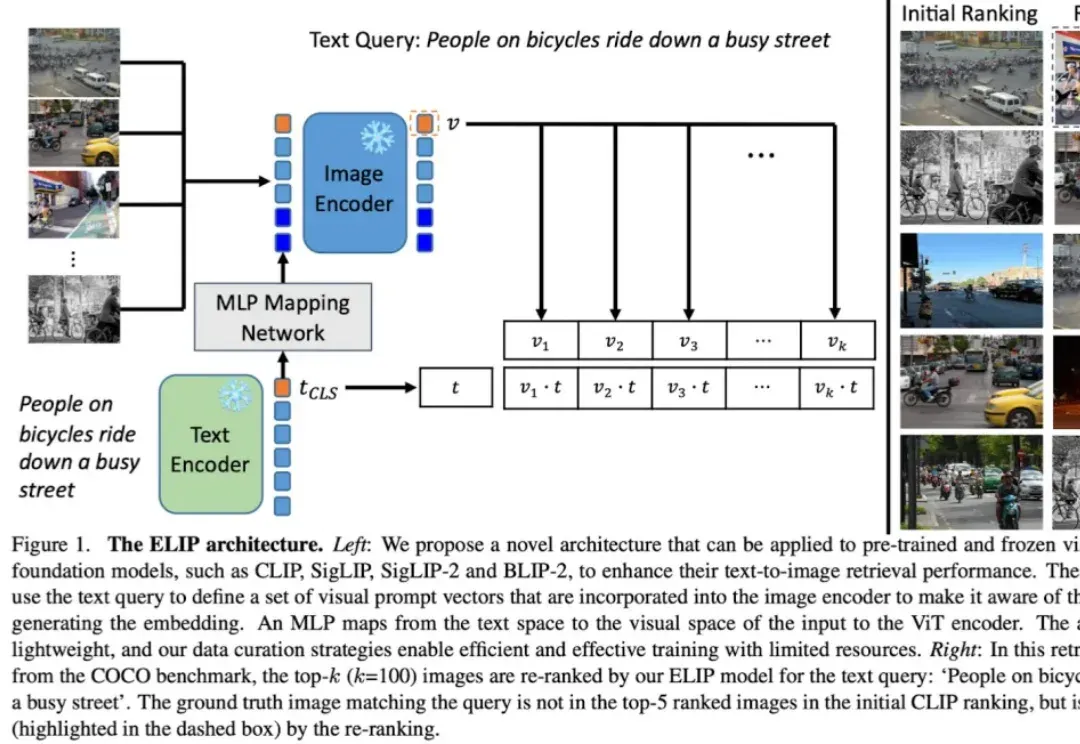
多模态图片检索是计算机视觉和多模态机器学习领域很重要的一个任务。现在大家做多模态图片检索一般会用 CLIP/SigLIP 这种视觉语言大模型,因为他们经过了大规模的预训练,所以 zero-shot 的能力比较强。
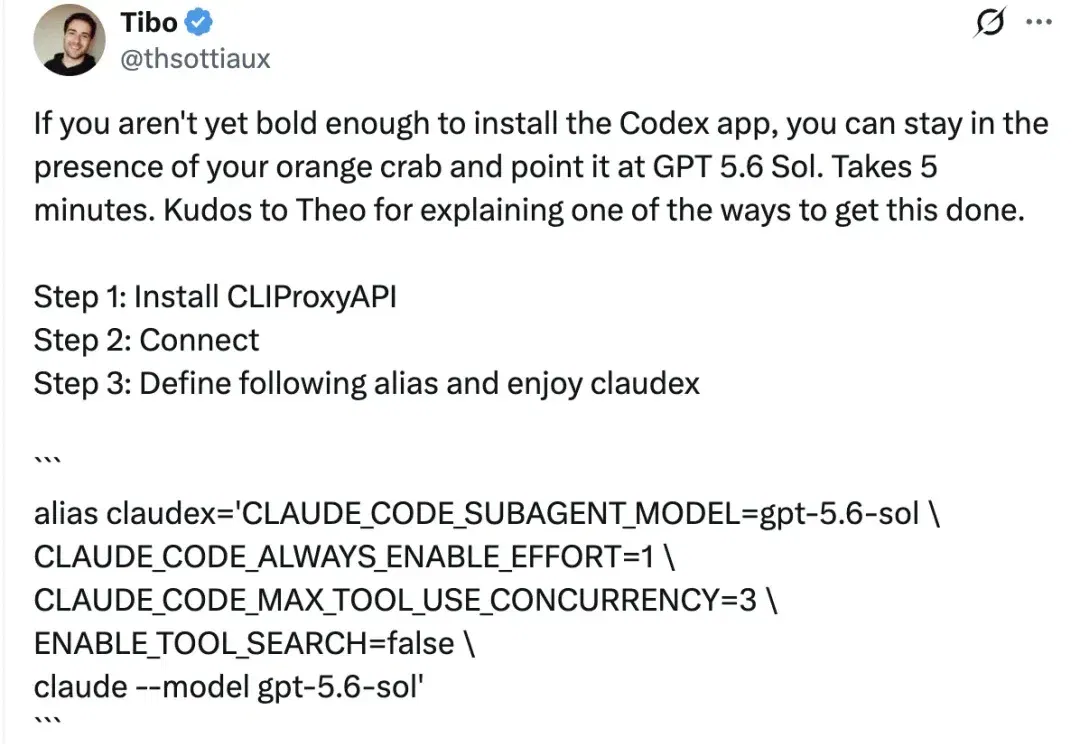
这事听着像钓鱼帖,但偏偏是真的。 7月12日,Codex团队负责人Tibo转发了一份教程,教用户如何通过CLIProxyAPI,把Codex订阅里的GPT-5.6 Sol接进Claude Code。 对,就是Anthropic家的Claude Code。 这里的“薅”,指把ChatGPT订阅里能用的模型,接到自己更顺手的客户端上。调用仍然走你自己的账号和OpenAI的服务端。 道理虽不复杂,画面依然非常抽象。 Tibo的原话大意是:如果你还没大胆到安装Codex应用,可以留在你的橙色螃蟹(cc),把它的内核变成GPT-5.6 Sol,只需5分钟。 步骤一共3步:装CLIProxyAPI,连接C
苹果在 Hugging Face上放大招了!这次直接甩出两条多模态主线:FastVLM主打「快」,字幕能做到秒回;MobileCLIP2主打「轻」,在 iPhone 上也能起飞。更妙的是,模型和Demo已经全开放,Safari网页就能体验。大模型,真·跑上手机了。
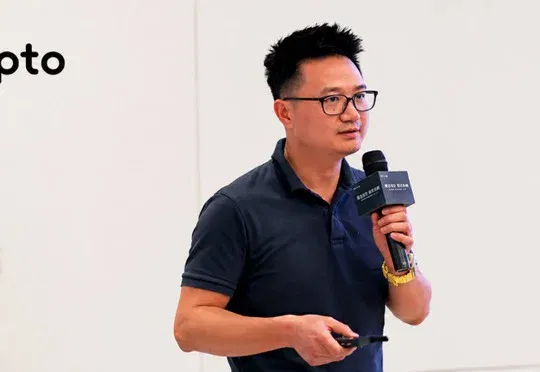
AI 文件搜索公司 Clipto 完成 1500 万美元融资,投后估值 2.5 亿美元,红杉中国、高瓴创投等参投,其创始人、CMU 博士 Henry Kang 带领团队利用 AI 为用户电脑中的视频、音频、图片和文档建立索引,公司年度经常性收入已达 1500 万美元。
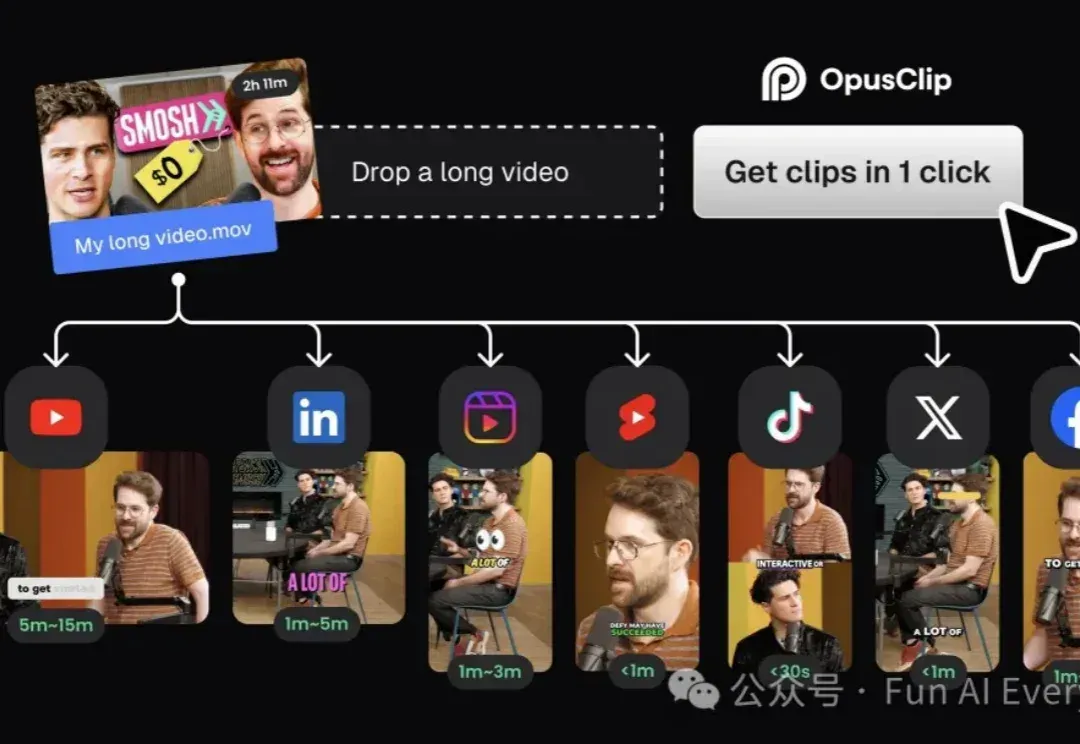
OpusClip 是一款把长视频、长内容自动剪成可发布的短视频片段的 AI 工具,服务内容创作者和企业内容团队。
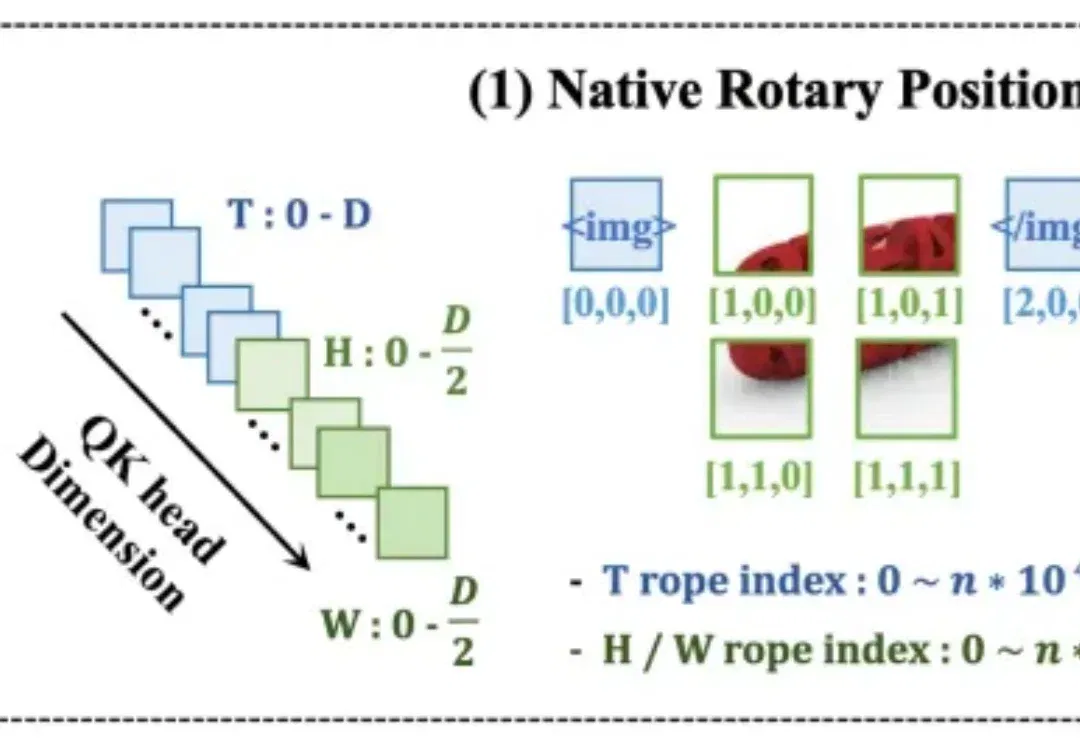
今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。
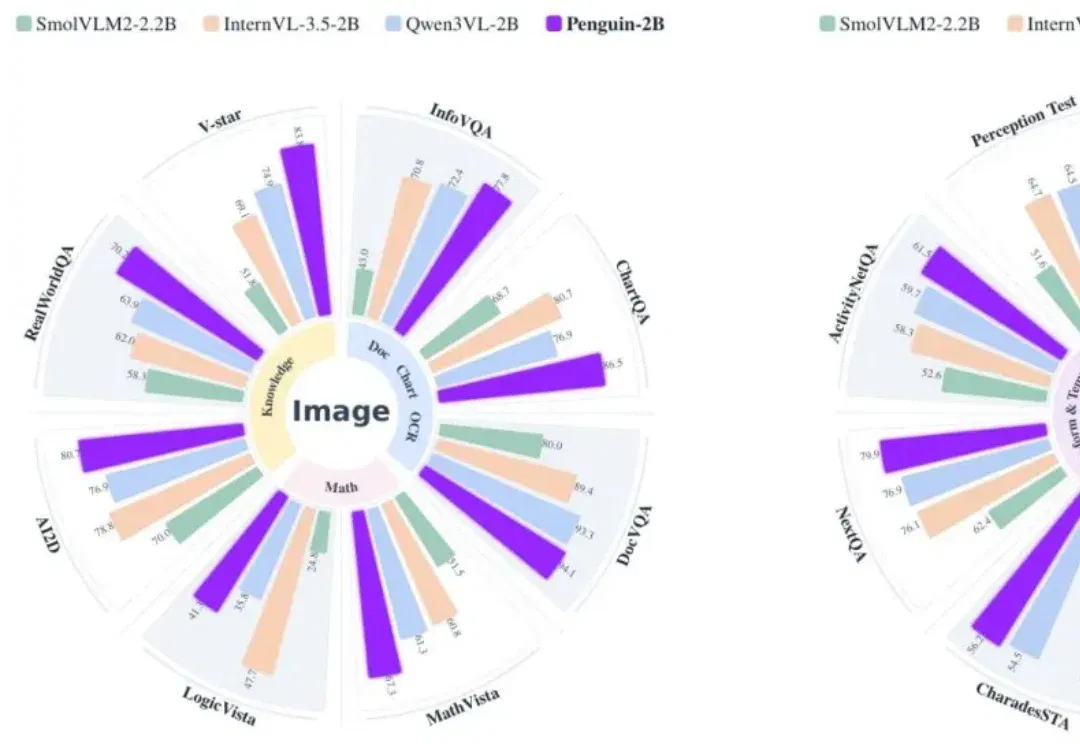
打破多模态视觉+语言拼接套路! 腾讯开源Penguin-VL,直接用纯文本LLM训视觉编码器。 这项研究跳出了先有传统视觉 backbone,再接语言模型的常规路径,直接从text-only LLM初始化vision encoder。 并在2B/8B紧凑参数规模下的文档理解、长视频时序定位等复杂任务中表现出极强竞争力。 从LLM出发的视觉编码器重构 如果把这两年的多模态模型拆开看,一个很有意思的现象是: 大家在语言模型上卷得很凶,但到了vision encoder这一层,路线却出奇一致。 很多VLM最后都会回到那套熟悉配方,先拿CLIP、SigLIP这类通过对比学习训出来的视觉模型做encod
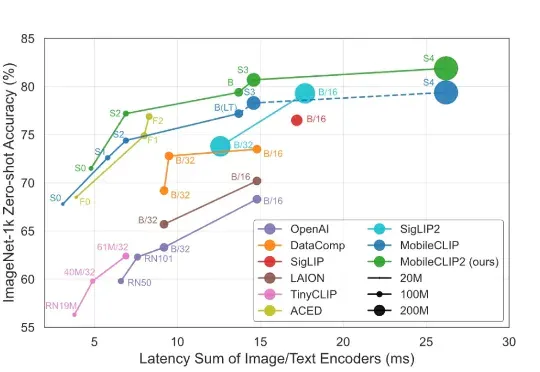
智东西9月1日消息,苹果又公布了大模型研发新进展! 8月28日,苹果在arXiv发布新论文,介绍新一代多模态基础模型MobileCLIP2及其背后的多模态强化训练机制,同天在GitHub、Hugging Face上开源了模型的预训练权重和数据生成代码。