Search

Results for “谢赛宁”

Total 27 articles

推特吵架吵出篇论文!谢赛宁团队新作iREPA只要3行代码

推特吵架吵出篇论文!谢赛宁团队新作iREPA只要3行代码 (opens in a new tab)

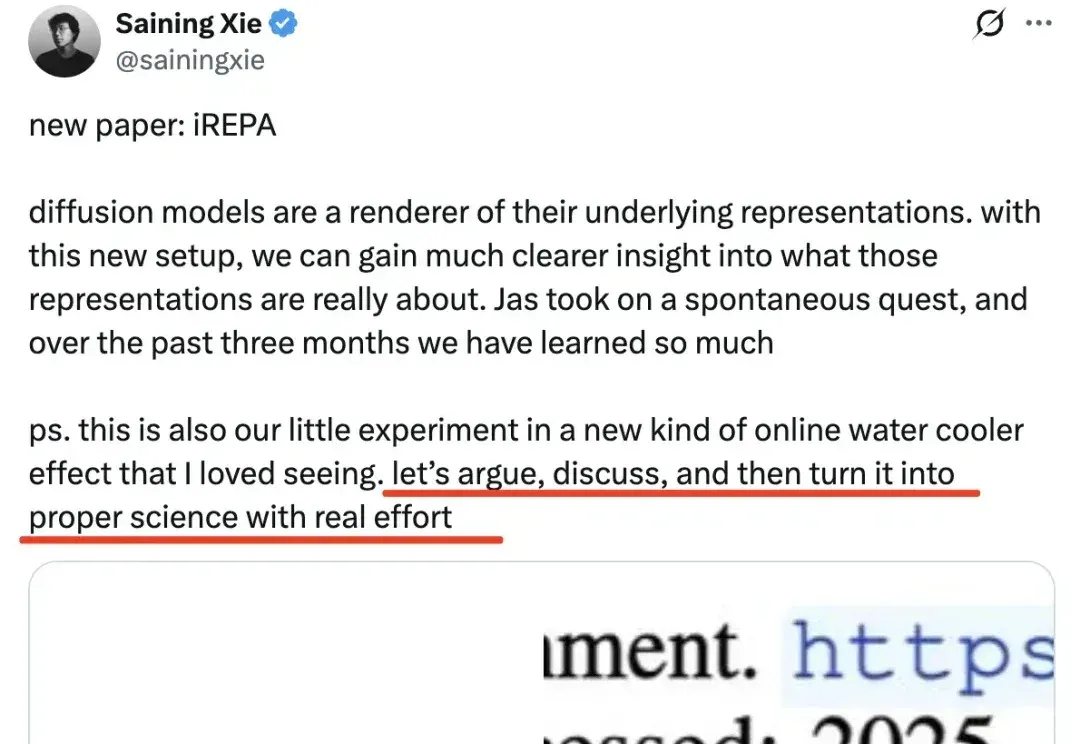
要说真学术,还得看推特。 刚刚,谢赛宁自曝团队新作iREPA其实来自4个多月前的,一次与网友的辩论。 这场短暂的线上辩论虽然以谢赛宁被网友说服告终,但在3个多月后,居然有了意料之外的后续—— 多个团队合作,沿着这一思路写出了一篇完整的论文,而且核心框架仅需3行代码。 致谢部分还感谢了当时参与讨论的网友。 一篇推特引发的学术论文 事情是这样的。 一位网友在8月份表示: 别再痴迷于ImageNet-1K的分类分数了!自监督学习(SSL)模型应该专门为稠密任务(如REPA、VLM等)进行训练,因为这些任务真正依赖的是patch tokens中的空间和局部信息,而不是[CLS]token所代表的全局分
AI guides
0
谢赛宁昔日实习生创业,接手复活Sora,进军好莱坞

谢赛宁昔日实习生创业,接手复活Sora,进军好莱坞 (opens in a new tab)

Sora,可能要回来了。 The Information报道称,OpenAI正在与一家新公司谈判,商讨让后者深度使用已经停用的Sora。 而参与这场谈判的人中,正有Sora前研究负责人、DiT(Diffusion Transformer)论文第一作者Bill Peebles。 (DiT为Sora背后的核心技术,Bill Peebles在FAIR实习期间与谢赛宁共同完成) 据悉,Bill Peebles此次携新公司,希望从OpenAI获得对Sora更深入的使用权限,从而进一步开发、定制面向电影制作人的软件和服务。 为此,Bill还拉来了两位重量级合作伙伴:一位是梦工厂动画联合创始人、前迪士尼影业

AI news
0
谢赛宁也玩MC?开源全新世界模型生成多人一致的游戏视角

谢赛宁也玩MC?开源全新世界模型生成多人一致的游戏视角 (opens in a new tab)

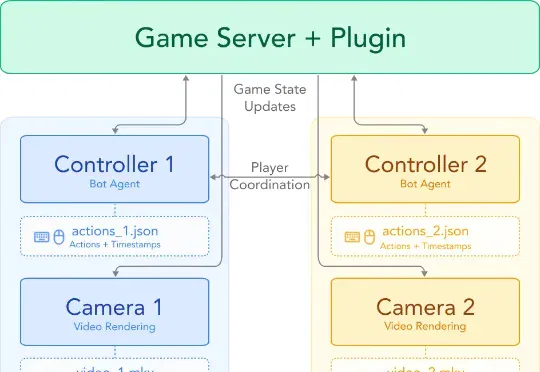
谢赛宁团队的最新视频世界模型 Solaris,首个多人视频世界模型,能够同时生成多个玩家之间保持一致的第一视角。研究团队发现,目前的视频世界模型仅能处理单人视角,这并不能反映现实世界的真实运作方式,希望能够能够实现多人同步观察一个统一世界。于是,研究团队把视角投向了电子游戏。

AI guides
0
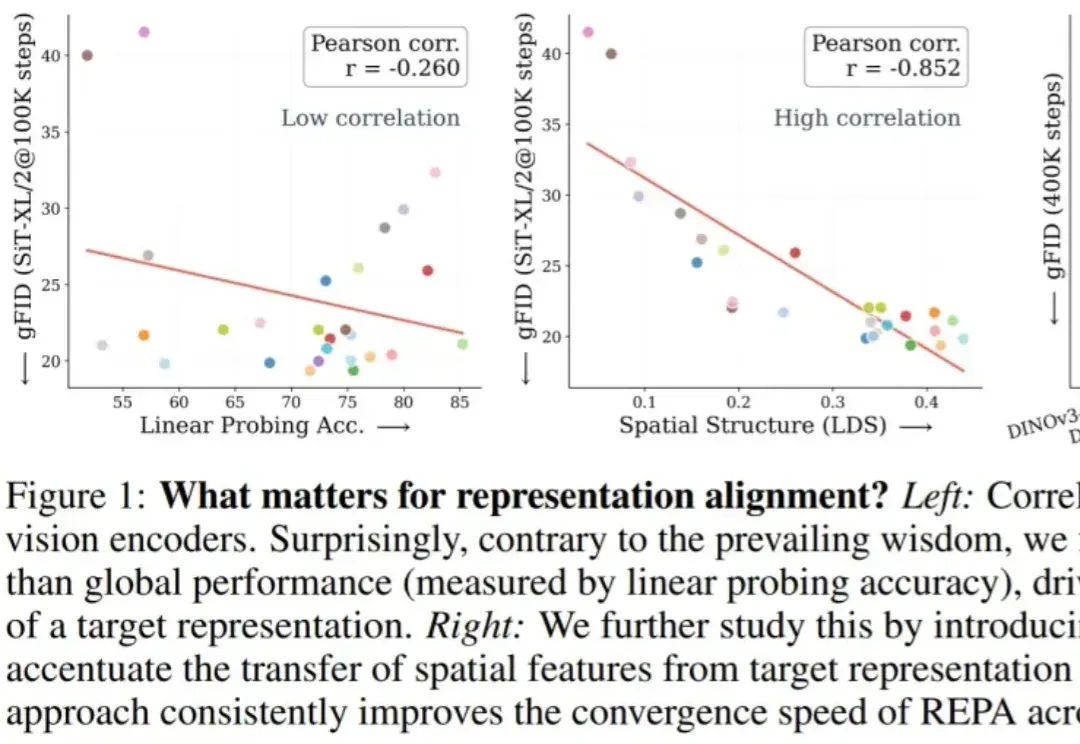
谢赛宁REPA得到大幅改进,只需不到4行代码

谢赛宁REPA得到大幅改进,只需不到4行代码 (opens in a new tab)

邹忌曾经有一个问题:吾与徐公孰美? 而对于 REPA,也有一个类似的问题:全局信息与空间结构,哪个对表征对齐更重要? 表征对齐(REPA)可通过将强大的预训练视觉编码器的表征蒸馏为中间扩散特征,来指导生成式训练。该方法于去年十月份问世,一直以来都备受关注,已成为加速扩散 Transformer(Diffusion Transformers)训练的一项有力技术。参阅报道《扩散模型训练方法一直错了!谢赛宁:Representation matters》。 但是,其还有一个很基本的问题悬而未决:对生成而言,目标表征的哪个方面更重要?是其「全局」语义信息(例如,以 ImageNet-1K 准确率衡量)

AI guides
0
谢赛宁李飞飞LeCun搞的寒武纪,究竟是个啥?

谢赛宁李飞飞LeCun搞的寒武纪,究竟是个啥? (opens in a new tab)

“寒武纪”这个名字在AI圈里火得发烫。 由谢赛宁牵头,李飞飞和Yann LeCun站台搞的“寒武纪”,大获好评。 此寒武纪究竟是什么? Cambrian-S(寒武纪-S),不造硅基芯片,而是专注于解决AI领域一个更核心的问题:让人工智能真正学会感知世界。 它的具体成果,是一款主打空间感知的多模态视频大模型,还兼顾了通用视频、图像理解能力,在短视频空间推理中拿下了SOTA。 更厉害的是,加了预测感知模块后,连超长视频的空间任务都能扛下来——要知道,这可是很多主流模型的软肋。 这个李飞飞和LeCun都关注的空间智能领域的新模型,到底有哪些突破? 超感知:让数字生命真正体验世界 先从它的发展历程说起

AI guides
0
谢赛宁新作:VAE退役,RAE当立

谢赛宁新作:VAE退役,RAE当立 (opens in a new tab)

谢赛宁团队最新研究给出了答案——VAE的时代结束,RAE将接力前行。其中表征自编码器RAE(Representation Autoencoders)是一种用于扩散Transformer(DiT)训练的新型自动编码器,其核心设计是用预训练的表征编码器(如DINO、SigLIP、MAE 等)与训练后的轻量级解码器配对,从而替代传统扩散模型中依赖的VAE(变分自动编码器)。

AI guides
0
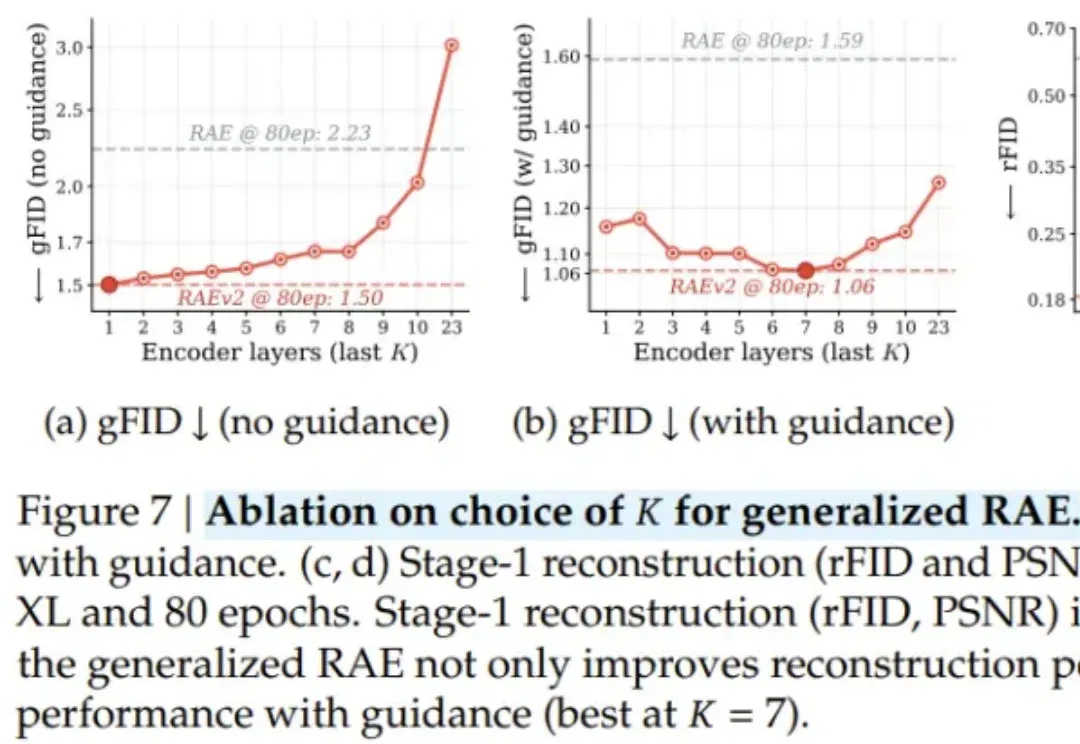
刚刚,谢赛宁团队放出第二代表征自编码器 RAEv2

刚刚,谢赛宁团队放出第二代表征自编码器 RAEv2 (opens in a new tab)

AI 图像生成通常遵循「能力越强、代价越高」的铁律;与此同时,学界却在悄悄质疑另一个更根本的浪费:传统 VAE 对图像语义几乎一无所知,而 DINOv2、SigLIP 等视觉编码器早已从数亿张图片中习得了丰富的视觉常识。图像生成模型,真的需要从零开始「发明」对图像的理解吗?

AI guides
0