Search

Results for “视频生成模型”

Total 76 articles

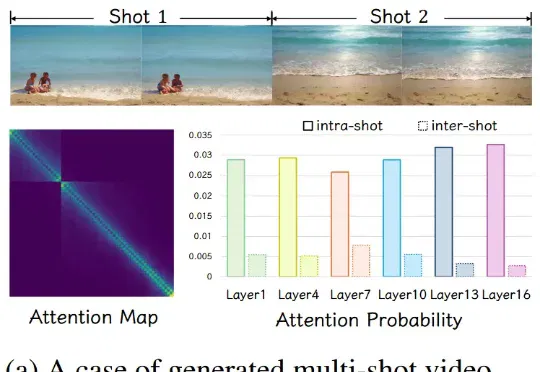
ICLR 2026 | CineTrans: 首个转场可控的多镜头视频生成模型,打破闭源技术壁垒

ICLR 2026 | CineTrans: 首个转场可控的多镜头视频生成模型,打破闭源技术壁垒 (opens in a new tab)

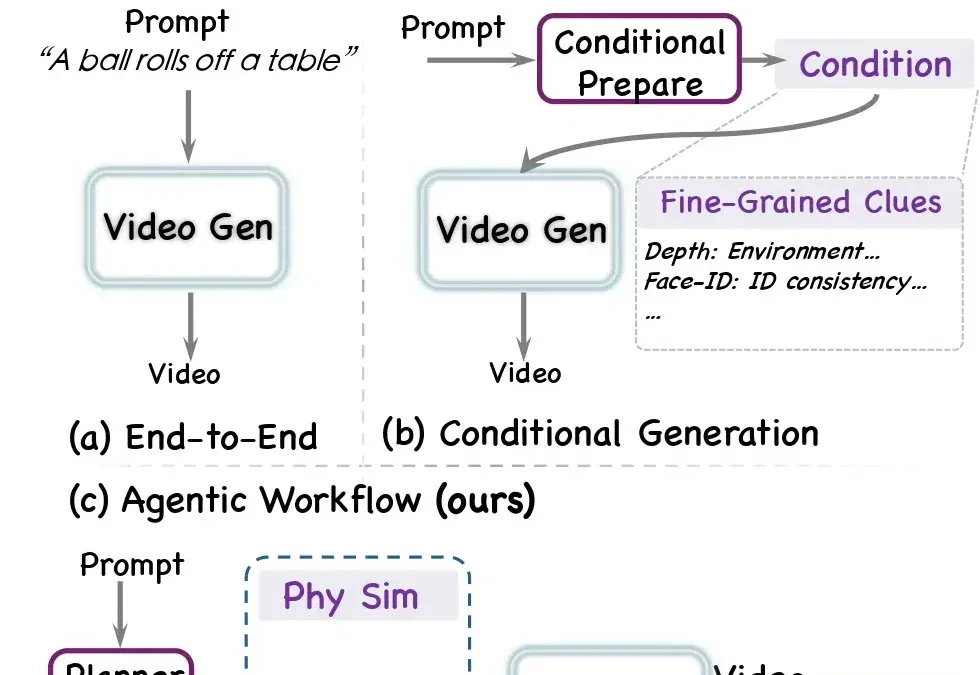
基于对注意力特性的观察,CineTrans 提出块对角掩码的通用机制,使视频生成模型能高效地自动化转场。为了进一步提升转场模型的效果和准确性,作者设计了详细的多镜头视频生产管线,并收集了一个高质量、多镜头数据集 Cine250K,大幅提升多镜头转场视频生成的效果。作为首个时间级可控的自动化转场模型,CineTrans 为这一领域的众多后续方法提供了关键技术。
AI guides
0
京东开源音视频生成框架JoyAI-Echo,5分钟叙事角色不崩,声音不乱,秒出片

京东开源音视频生成框架JoyAI-Echo,5分钟叙事角色不崩,声音不乱,秒出片 (opens in a new tab)

京东首次开源长音视频生成框架JoyAI-Echo。它直击长视频生成中的角色一致性、声音稳定性和生成速度三大核心难题,一举在多个核心指标上超越行业标杆模型。根据公开评测结果,JoyAI-Echo在跨镜头一致性、语音准确率、用户偏好等关键指标上均取得领先表现,与业内主流长视频生成模型相比优势明显,出道即跻身全球第一梯队。

AI news
0
全球功能最全的视频生成模型来了

全球功能最全的视频生成模型来了 (opens in a new tab)

坏了,阿里这波是冲着Sora 2去的! 刚刚,阿里发布了新一代通义万相2.6系列模型,一次性覆盖文生视频、图生视频、参考生视频,以及图像生成和文生图,是目前全球功能最全的视频生成模型。 在视频创作上,万相2.6不仅推出了Sora2目前还没有的多音频驱动生视频能力,还同步引入了音画同步、多镜头叙事等能力。 像下面这个超火的一刀切ASMR,就是通过文本+音频直接驱动出来的: 再看这个由文本+图像+音频驱动的小猫沉浸式吃播,咀嚼声和嘴部动作基本能卡在点上,吃得那叫一个香: 文生图这条线也同步补强了,万相2.6在艺术风格控制、真实感人像、中英文长文本生图以及历史文化IP语义理解等方面的创作能力也都有明

AI news
0
视频生成作为多模态推理新范式 | CVPR 2026

视频生成作为多模态推理新范式 | CVPR 2026 (opens in a new tab)

被CVPR 2026收录! 复旦邱锡鹏团队(OpenMOSS)首次提出Thinking with Video这一推理新范式: 借助视频生成模型,以视频帧为统一媒介进行多模态推理,打破视觉与文本的界限。 团队发现,Thinking with Text(基于文本的CoT推理)和Thinking with Images(在CoT中加上图像辅助推理)范式已大幅提升了LLMs和VLMs的推理能力。 但它们仍有局限:静态图像无法展现动态过程,文本与视觉模态的割裂阻碍了统一理解与生成。 而借助新范式Thinking with Video,视频生成模型在视觉任务上不仅总体媲美SOTA VLMs,而且竟也能解决

AI guides
0
全新视角看世界模型:从视频生成迈向通用世界模拟器

全新视角看世界模型:从视频生成迈向通用世界模拟器 (opens in a new tab)

近年来,视频生成(Video Generation)与世界模型(World Models)已跃升为人工智能领域最炙手可热的焦点。从 Sora 到可灵(Kling),视频生成模型在运动连续性、物体交互与部分物理先验上逐渐表现出更强的「世界一致性」,让人们开始认真讨论:能否把视频生成从「逼真短片」推进到可用于推理、规划与控制的「通用世界模拟器」。

AI guides
0
AI视频独角兽爱诗科技宣布完成整体C轮融资

AI视频独角兽爱诗科技宣布完成整体C轮融资 (opens in a new tab)

阿里、王慧文家办都投了。 智东西7月14日报道,今日,北京AI视频独角兽爱诗科技宣布完成整体C轮融资,本轮累计融资29.8亿元人民币。 其中,C+轮由阿里巴巴领投,Lollapalooza Capital(王慧文家办)、常春藤资本、惠远资本、钟鼎资本、韩国未来资产、OCBC生态旗下Lion X基金、蓝色光标、CloudAlpha、iGlobe Partners等十余家机构参投。 爱诗科技计划将本轮资金主要用于视频生成基础模型、实时世界模型研发,以及全球化产品增长和产业场景落地。 爱诗科技成立于2023年4月,专注于AI视频生成大模型及相关产品的研发应用,是国内首个发布DiT架构视频生成模型的初

AI news
0
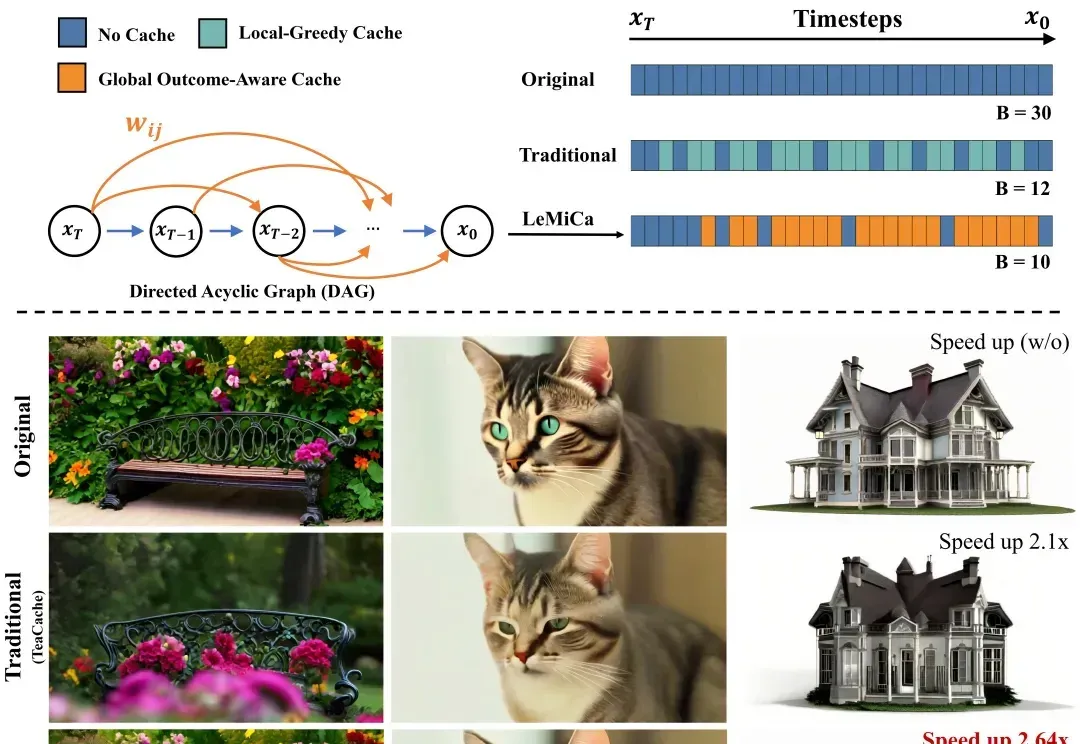
NeurIPS 2025 Spotlight | 中国联通以全局优化重塑扩散模型加速

NeurIPS 2025 Spotlight | 中国联通以全局优化重塑扩散模型加速 (opens in a new tab)

当前,视频生成模型性能正在快速提升,尤其是基于Transformer架构的DiT模型,在视频生成领域的表现已经逐渐接近真实拍摄效果。然而,这些扩散模型也面临一个共同的瓶颈:推理时间长、算力成本高、生成速度难以提升。随着视频生成长度持续增加、分辨率不断提高,这个瓶颈正在成为影响视频创作体验的主要障碍之一。

AI guides
0
昆仑万维开源的SkyReels-V3,把马斯克请来带货了

昆仑万维开源的SkyReels-V3,把马斯克请来带货了 (opens in a new tab)

AI 网红们在社交平台上混得风生水起。 他们手握品牌合作,还坐拥百万粉丝,但很多人至今不知这些都是 AI 生成的,依然像追真人明星一样互动、点赞、被种草。 视频来源:X 博主 @thetripathi58 这也难怪有博主直呼:虚拟网红时代已经到来。 现在,昆仑万维也来添了把火,直接把背后的技术开源了。 1 月 29 日,Skywork AI 团队宣布开源 SkyReels-V3 多模态视频生成模型系列。该系列涵盖参考图像转视频、视频延长和音频驱动虚拟形象三大核心能力,在单一建模架构中实现高保真多模态视频生成,达到业界领先水平。 比如,只需一张虚拟主播照片配上音频,就能生成口型精准、表情生动的主

AI news
0