Search

Results for “视频理解”

Total 28 articles

SALMONN 系列音视频理解大模型霸榜回归!推理增强、高帧率、无文本泄漏全线突破

SALMONN 系列音视频理解大模型霸榜回归!推理增强、高帧率、无文本泄漏全线突破 (opens in a new tab)

全新一代 video-SALMONN 2/2+、首个开源推理增强型音视频理解大模型 video-SALMONN-o1(ICML 2025)、首个高帧率视频理解大模型 F-16(ICML 2025),以及无文本泄漏基准测试 AVUT(EMNLP 2025) 正式发布。新阵容在视频理解能力与评测体系全线突破,全面巩固 SALMONN 家族在开源音视频理解大模型赛道的领先地位。
AI news
0
AAAI 2026 | 北航、东京大学填补AI「语义鸿沟」,过程感知视频理解如何找到「状态」锚点?

AAAI 2026 | 北航、东京大学填补AI「语义鸿沟」,过程感知视频理解如何找到「状态」锚点? (opens in a new tab)

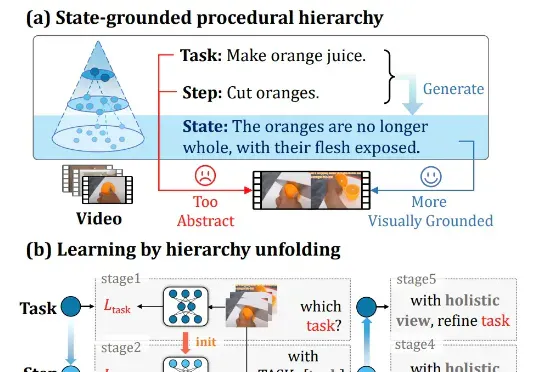
在具身智能与视频理解飞速发展的今天,如何让 AI 真正 “看懂” 复杂的操作步骤?北京航空航天大学陆峰教授团队联合东京大学,提出视频理解新框架。该工作引入了 “状态(State)” 作为视觉锚点,解决了抽象文本指令与具象视频之间的对齐难题,已被人工智能顶级会议 AAAI 2026 接收。

AI news
0
告别「偏科」,UniVid实现视频理解与生成一体化

告别「偏科」,UniVid实现视频理解与生成一体化 (opens in a new tab)

在视频生成与理解的赛道上,常常见到分头发力的模型:有的专注做视频生成,有的专注做视频理解(如问答、分类、检索等)。而最近,一个开源项目 UniVid,提出了一个「融合」方向:把理解 + 生成融为一体 —— 他们希望用一个统一的模型,兼顾「看懂视频」+「生成视频」的能力。

AI guides
0
轻量高效,即插即用:Video-RAG为长视频理解带来新范式

轻量高效,即插即用:Video-RAG为长视频理解带来新范式 (opens in a new tab)

尽管视觉语言模型(LVLMs)在图像与短视频理解中已取得显著进展,但在处理长时序、复杂语义的视频内容时仍面临巨大挑战 —— 上下文长度限制、跨模态对齐困难、计算成本高昂等问题制约着其实际应用。针对这一难题,厦门大学、罗切斯特大学与南京大学联合提出了一种轻量高效、无需微调的创新框架 ——Video-RAG。

AI guides
0
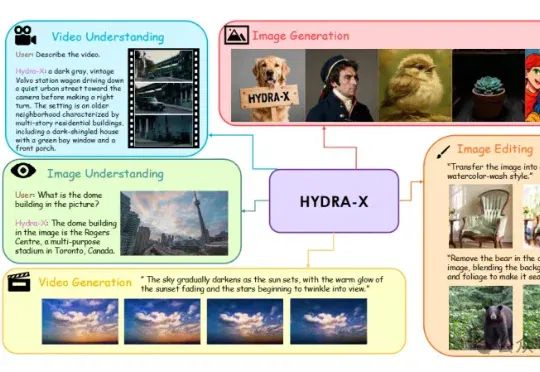
单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题

单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题 (opens in a new tab)

南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。

AI guides
0