Search

Results for “视频世界模型”

Total 20 articles

VerseCrafter:给视频世界模型装上4D方向盘,精准运镜控物

VerseCrafter:给视频世界模型装上4D方向盘,精准运镜控物 (opens in a new tab)

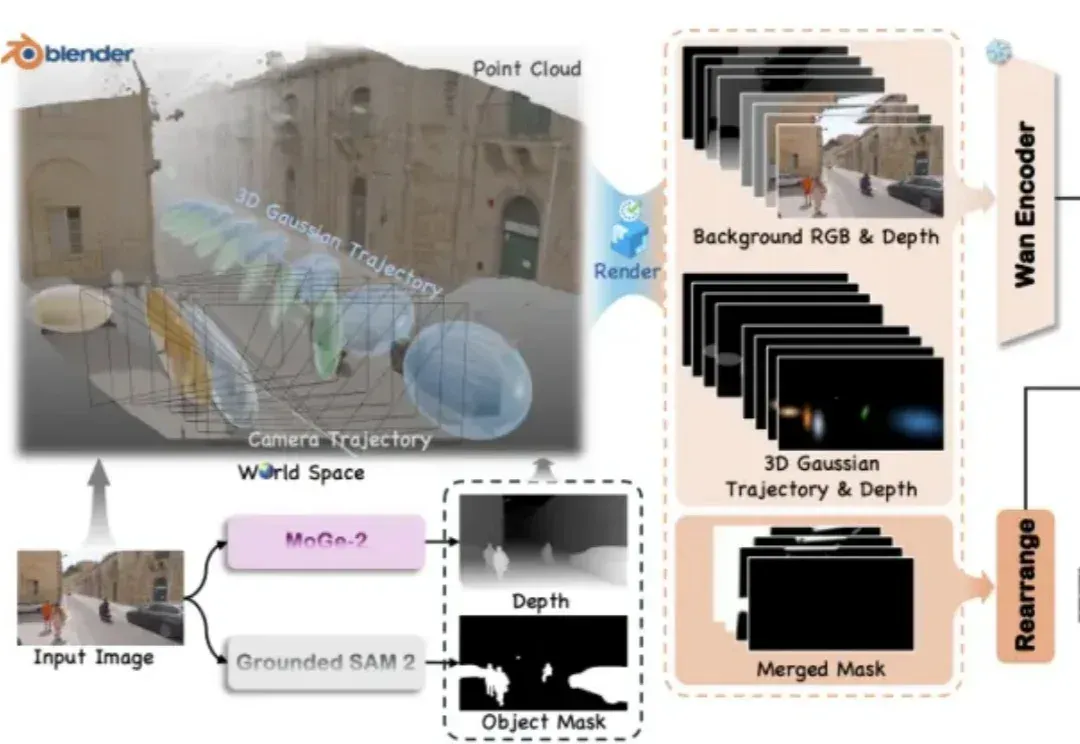
视频世界模型领域又迎来了新的突破! 复旦大学与腾讯 PCG ARC Lab 等机构的研究者们提出了 VerseCrafter,这是一个通过显式 4D 几何控制(4D Geometric Control)实现的动态逼真视频世界模型。它不仅能像「导演」一样精准控制运镜,还能同时指挥场景中多个物体的 3D 运动轨迹,为视频生成引入了物理世界维度。 自 Sora 问世以来,视频世界模型(Video World Models)成为了 AI 领域最热门的研究方向之一。我们希望 AI 不仅能生成视频,更能理解和模拟真实的物理世界。然而,现有的视频模型往往面临一个核心困境:视频是在 2D 平面上播放的,但真实
AI guides
0
谢赛宁也玩MC?开源全新世界模型生成多人一致的游戏视角

谢赛宁也玩MC?开源全新世界模型生成多人一致的游戏视角 (opens in a new tab)

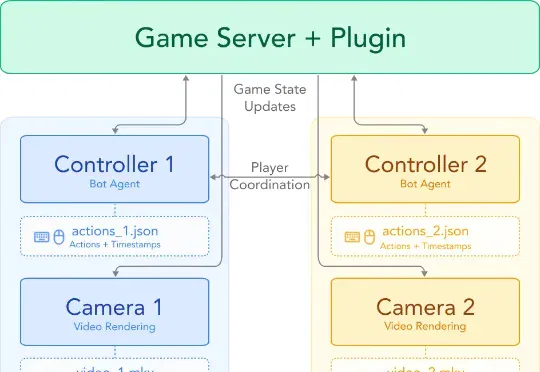
谢赛宁团队的最新视频世界模型 Solaris,首个多人视频世界模型,能够同时生成多个玩家之间保持一致的第一视角。研究团队发现,目前的视频世界模型仅能处理单人视角,这并不能反映现实世界的真实运作方式,希望能够能够实现多人同步观察一个统一世界。于是,研究团队把视角投向了电子游戏。

AI guides
0
视频世界模型推理最高提速2.59×!浙大新作无需重训,不改参数

视频世界模型推理最高提速2.59×!浙大新作无需重训,不改参数 (opens in a new tab)

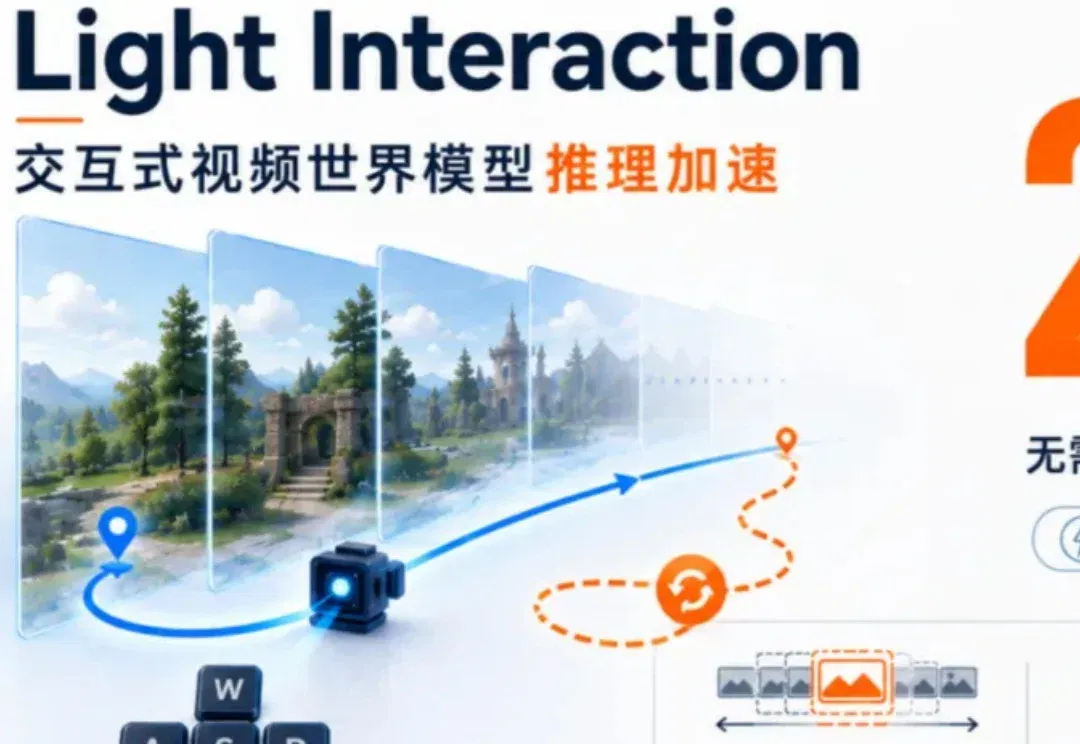
交互式视频世界模型正在从「一次性生成短片」走向「像游戏一样边操作边生成」。但长轨迹交互会迅速放大上下文、显存和多步去噪开销。Light Interaction不改模型参数、不重新训练,只在推理阶段把相机轨迹变成调度信号,动态选择历史上下文、在回访状态复用去噪输出,并用面向自回归生成的3D稀疏注意力降低计算。

AI guides
0
打破具身世界模型可执行性鸿沟 !港中深-跨维智能团队提出EVA框架,用强化学习让视频世界模型真正“动”起来

打破具身世界模型可执行性鸿沟 !港中深-跨维智能团队提出EVA框架,用强化学习让视频世界模型真正“动”起来 (opens in a new tab)

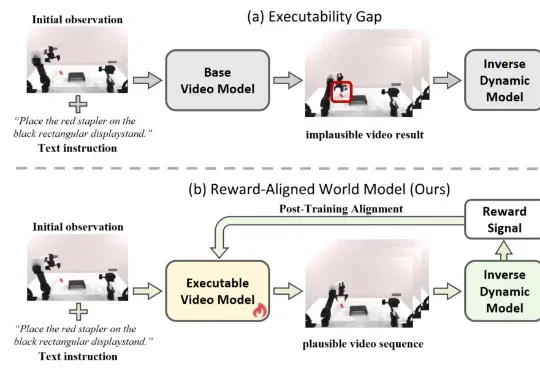
近期,利用视频生成模型为机器人构建 “世界模型”,已成为具身智能领域的热门技术路线。给定当前观测和自然语言指令,这类模型能够先 “想象” 出未来的视觉轨迹,再由逆动力学模型(IDM)将生成画面解码为机器人动作,从而形成 “先预测、后执行” 的解耦式规划范式。由于兼具较强的可解释性与开放场景泛化潜力,这一路线正在受到学术界和工业界的广泛关注。

AI guides
0
ICML 2026 | 计算所联合ETH研究者提出WorldCache,视频世界模型近似无损提速3.7 倍

ICML 2026 | 计算所联合ETH研究者提出WorldCache,视频世界模型近似无损提速3.7 倍 (opens in a new tab)

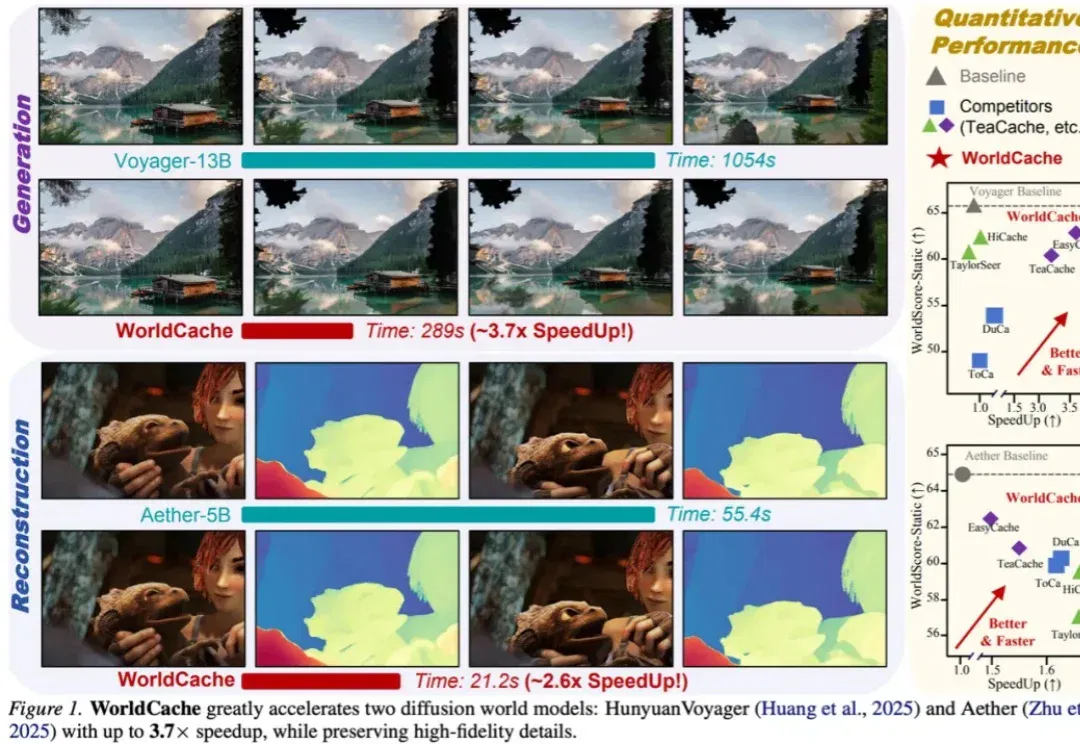
如果说扩散世界模型的瓶颈,是每一步去噪都要把同一个大 Transformer 再跑一遍,那么 WorldCache 的思路就是:不要再把所有 Token、所有时间步都当成同一件事。这篇工作把 “哪些内容适合缓存”和“哪些时刻必须重算” 拆开处理,在不重新训练模型、几乎不增加额外显存的前提下,把缓存真正做成了一套更贴合世界模型结构的推理策略。

AI guides
0