Search

Results for “机器人数据”

Total 12 articles

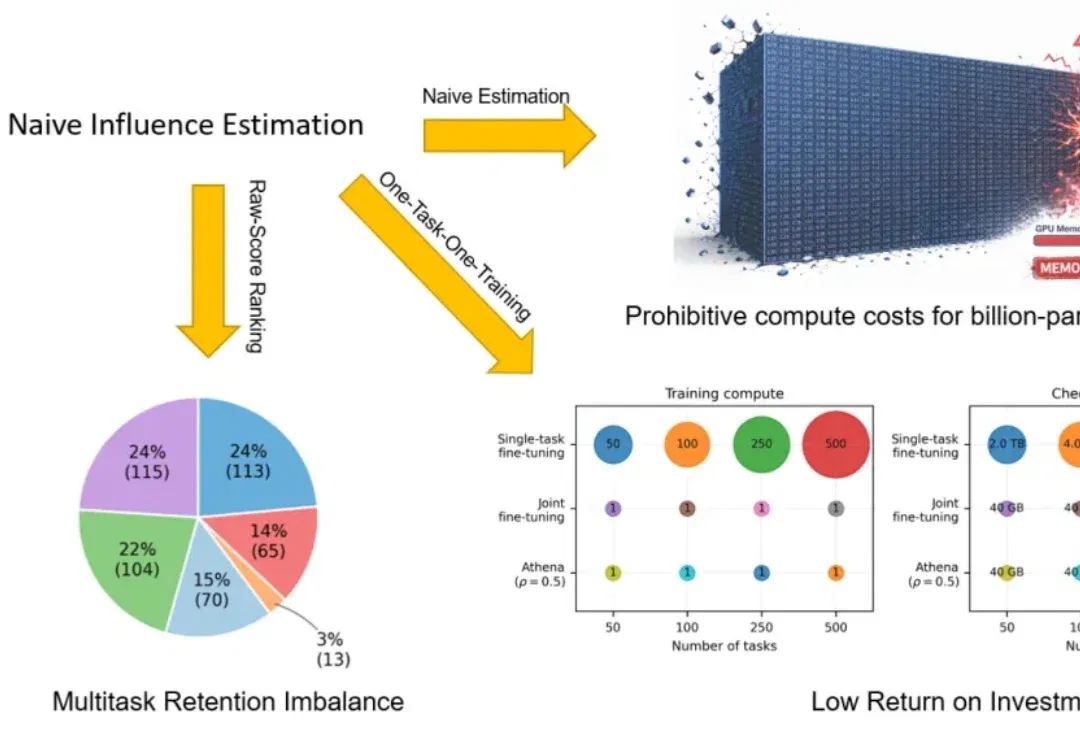
怎么量化机器人数据价值?ATHENA将影响函数扩展到十亿参数VLA,313×加速筛选高价值数据

怎么量化机器人数据价值?ATHENA将影响函数扩展到十亿参数VLA,313×加速筛选高价值数据 (opens in a new tab)

具身智能正在进入数据 scaling 时代。Vision-Language-Action(VLA)模型让机器人可以从大规模示教数据(demonstrations)中学习更通用的操作策略。但对机器人 VLA 训练来说,数据并不总是越多越好:低质量数据可能会拖累模型性能,而每一条 demonstration 都意味着昂贵的人力采集、机器人运行,以及云端存储和训练成本。
AI guides
0
首个物理AI数据基座平台“无垠”落户浙江,专治机器人数据荒,家庭工业商业场景全覆盖

首个物理AI数据基座平台“无垠”落户浙江,专治机器人数据荒,家庭工业商业场景全覆盖 (opens in a new tab)

2026,什么最火爆? 具身智能和世界模型,今年合计已吸金超300亿元,前者是物理AI落地的产品,后者是物理AI的“训练场”,它们共同组成了物理AI的一体两面。 然而,物理AI始终是融入真实世界的AI,尽管世界模型代表的仿真路线,以较低成本为物理AI供应了海量数据,但其中的Sim2Real鸿沟,又让行业长期头疼。如果转而依靠真实数据,成本又太高,很难上量。 在这种矛盾之下,行业开始转向虚实融合的方式,为物理AI供应大规模的数据。就在近日,这条路线上涌现出了业界首个数据基座平台。 具身智能的火,照亮数据的难 开年短短2个月,具身智能赛道融资超20起,平均3天不到就有一笔热钱涌入,行业累计融资金额

AI news
0
蚂蚁具身智能明牌了:做大脑,和宇树们错位竞争

蚂蚁具身智能明牌了:做大脑,和宇树们错位竞争 (opens in a new tab)

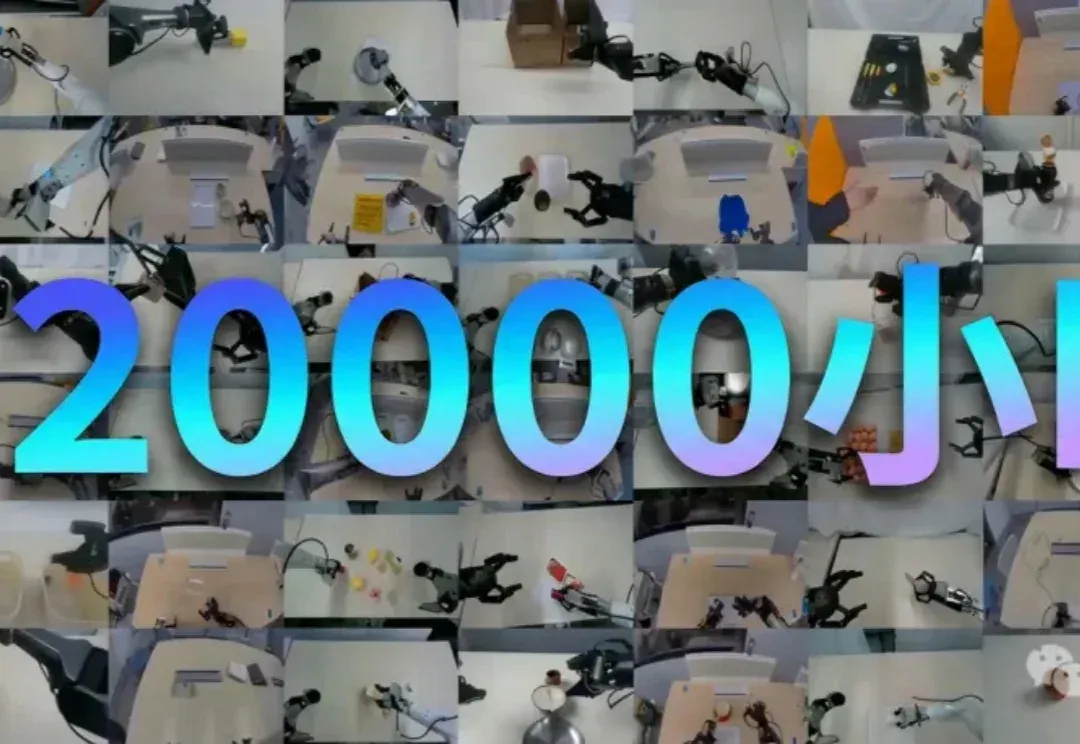
从3000小时到整整20000小时。 真实世界数据里的Scaling Law,直接喂出了个最强VLA(Vision-Language-Action)基座模型! 这就是蚂蚁灵波今天开源的具身智能基座模型——LingBot-VLA。 为什么说它是目前最强?先看数据。 从“20000小时”这个量上来看,LingBot-VLA已经解锁了迄今为止开源的最大规模真实机器人数据之一。 并且性能也是够打,在权威评测中也全面超越了此前公认最强Physical Intelligence的π0.5,以及英伟达GR00T N1.6等一众国际顶尖模型。 再看实际表现。 此前具身智能圈子一个很头疼的问题,就是一旦环境发生

AI guides
0