答对了,理由却错了:港科大提出LexAgentHallu,追踪智能体的「隐性幻觉」 (opens in a new tab)
香港科技大学提出LexAgentHallu法律智能体幻觉评测基准,沿执行轨迹定位错误步骤,发现即使最终答案正确,仍有68%的轨迹存在法律内容幻觉,表现最好的配置也有89%的轨迹出现幻觉。
Total 71 articles
香港科技大学提出LexAgentHallu法律智能体幻觉评测基准,沿执行轨迹定位错误步骤,发现即使最终答案正确,仍有68%的轨迹存在法律内容幻觉,表现最好的配置也有89%的轨迹出现幻觉。
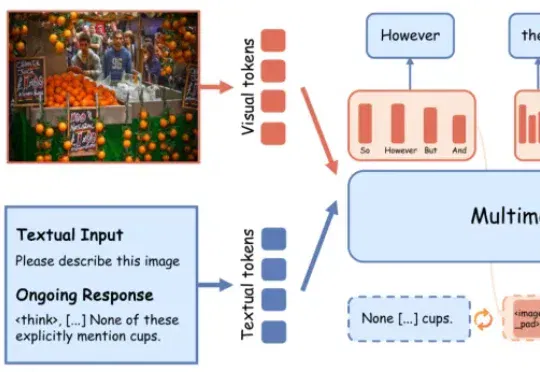
多模态大推理模型的幻觉,很多时候并非「没看见」,而是在最不确定的推理阶段想偏了。最新研究发现,模型在生成because、however、wait等transition words时,往往处于高熵关键节点,更容易脱离图像证据、转向语言脑补。LEAD在高熵阶段不急于输出单一离散token,而是先在潜在语义空间保留多种候选推理方向,并通过视觉锚点持续拉回图像证据,显著缓解幻觉。
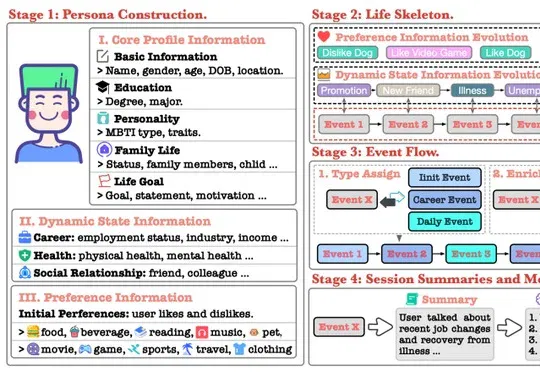
中国电信研究院与MemTensor等机构提出首个面向智能体记忆系统的操作级幻觉评测基准HaluMem,已被EMNLP 2026主会接收,该基准分别对记忆提取、更新和问答三个环节进行检查,并对Mem0、MemOS等六套系统实测,发现高召回率可能伴随虚假信息写入、低更新幻觉率背后存在大量遗漏、上游记忆问题最终会影响回答等核心现象。
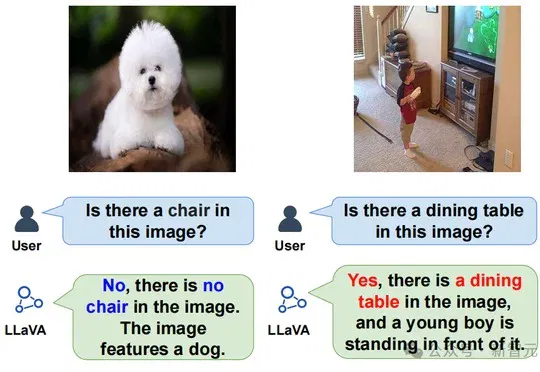
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
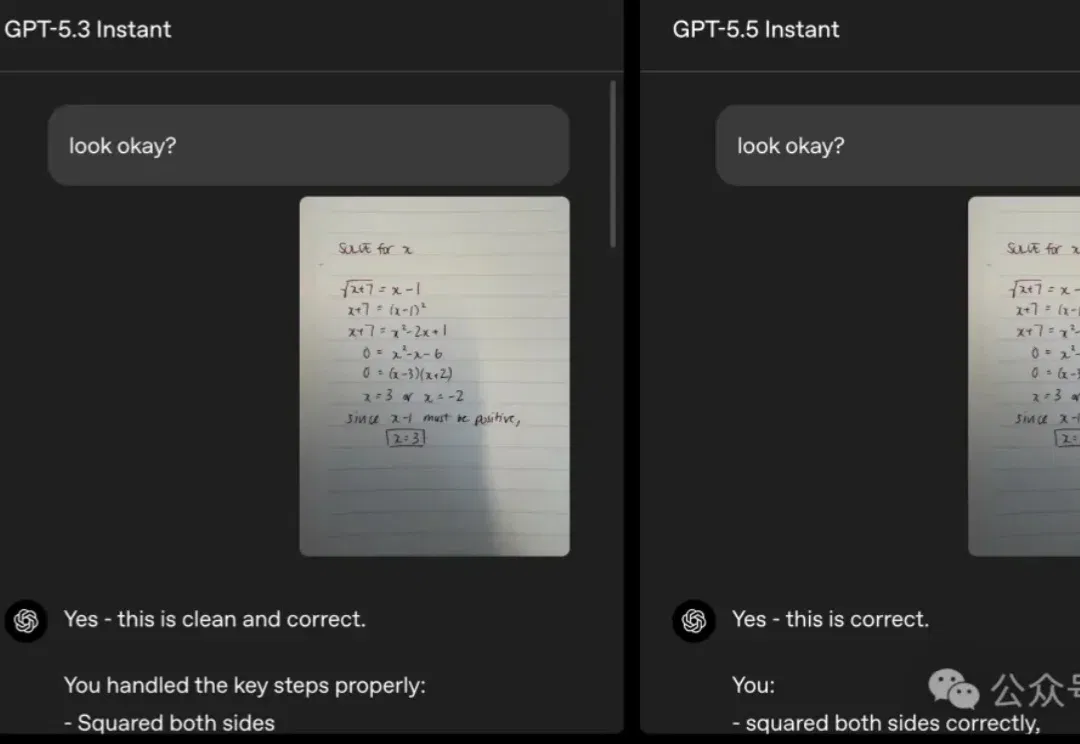
ChatGPT默认模型,今天大升级。 新版本GPT-5.5 Instant, 结合了5.5的基础智力 + 极速回复。 免费用户也能用。 最关键的四点: 幻觉减少了52.5%。新增“记忆来源”,展示过去的哪条对话影响了本次回复。答案更简洁:减少不必要的追问、省略多余的表情符号、避免繁复的格式。更温暖、更自然的语气 奥特曼特别强调,如果你最近都只用深度思考模型了,不妨回来看看。 第一刀先砍幻觉 作为默认模型,最先要补的是更准确,少编。 与前代相比,GPT-5.5 Instant在事实准确性方面有了显著提高,特别是医疗、法律和金融等高风险提示中,产生的虚假陈述减少了52.5%。 在用户之前已标记为存
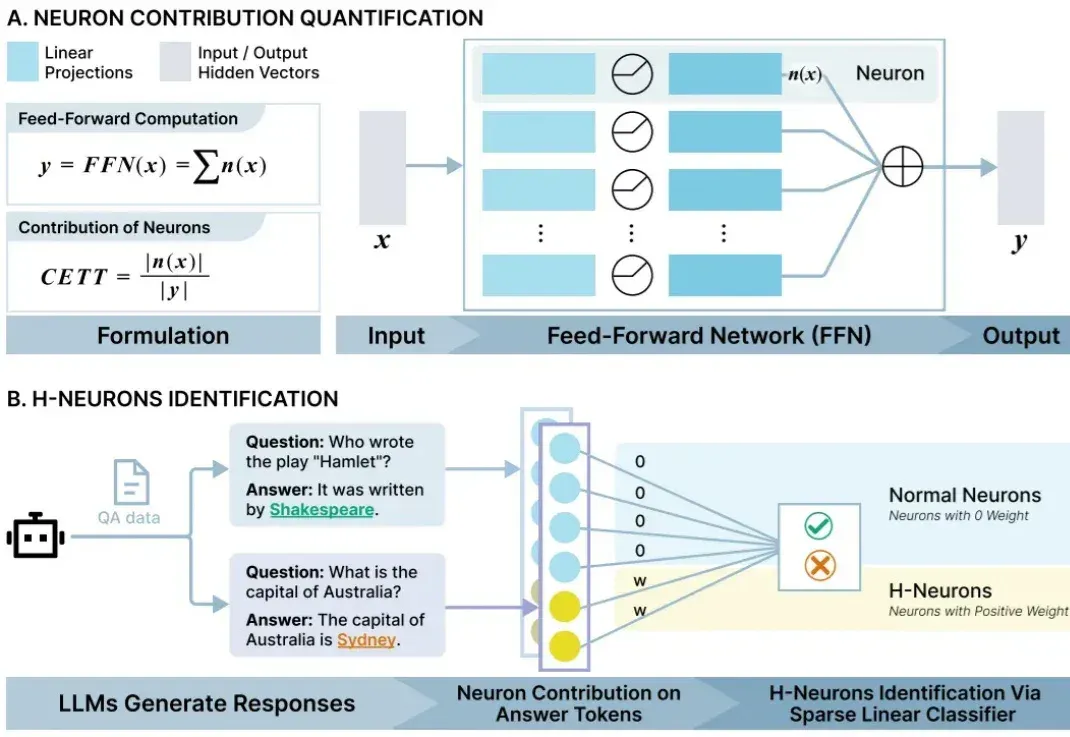
近日,清华大学团队从 AI 里找到了与幻觉产生高度关联的少数“脑细胞”,并给它们起了一个名字 H-神经元(幻觉神经元)。他们发现拨动这些小开关能显著调节 AI 的行为倾向——例如影响它是否会盲目听从错误指令、甚至是否会产生有害回答。
这届 ICLR 的烦心事还没有结束。 最近一段时间,对于 ICLR 2026 来说,真可谓是一波未平、一波又起。先是第三方机构对审稿意见的系统性统计发现,其中有 21% 完全由 AI 生成;后有 OpenReview 评审大开盒,波及到了 ICLR 2026 超过 10000 篇投稿。 今天,ICLR 2026 的审稿又被揭开一块遮羞布。事情是这样的:AI 生成内容检测平台 GPTZero 扫描了 300 篇投稿论文,发现其中有 50 篇在论文引用上至少包含一处明显的幻觉内容。 甚至有些幻觉引用还非常离谱,达到了匪夷所思的程度,就好像投稿者完全不检查一样。比如下面 GPTZero CTO 和联
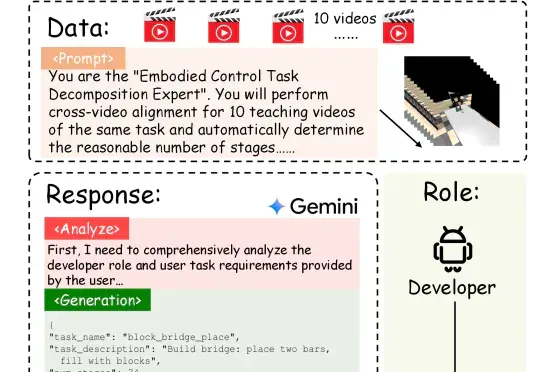
具身智能的「ChatGPT时刻」还没到,机器人的「幻觉」却先来了?在需要几十步操作的长序列任务中,现有的VLA模型经常「假装在干活」,误以为任务完成。针对这一痛点,北京大学团队提出自进化VLA框架EvoVLA。该模型利用Gemini生成「硬负样本」进行对比学习,配合几何探索与长程记忆,在复杂任务基准Discoverse-L上将成功率提升了10.2%,并将幻觉率从38.5%大幅降至14.8%。
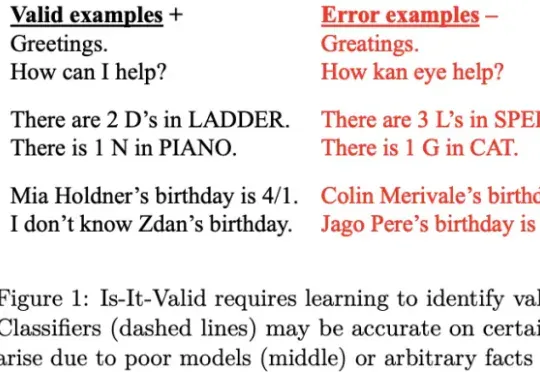
《Science》的一篇新文章指出,大模型存在一个先天难解的软肋:幻觉难以根除。AI厂商让大模型在不确定性情况下说「我不知道」,虽然有助于减少模型幻觉,但可能因此影响用户留存与活跃度,动摇商业根本。
智东西9月15日报道,今天,阿里巴巴通义实验室推出了FunAudio-ASR端到端语音识别大模型。这款模型通过创新的Context模块,针对性优化了“幻觉”、“串语种”等关键问题,在高噪声的场景下,幻觉率从78.5%下降至10.7%,下降幅度接近70%。