刚刚,DeepSeek-V4多模态模型开源 (opens in a new tab)
DeepSeek-V4-Flash-Vision-Exp多模态模型正式开源,该模型为DeepSeek-V4系列首个实验性多模态模型,基于DeepSeek-V4-Flash架构集成视觉模块,在真实世界软件工程测试DeepSWE中以59.3%反超Opus-4.8登顶,并在零样本视觉推理测试ZeroBench中击败Opus-4.8。
Total 66 articles
DeepSeek-V4-Flash-Vision-Exp多模态模型正式开源,该模型为DeepSeek-V4系列首个实验性多模态模型,基于DeepSeek-V4-Flash架构集成视觉模块,在真实世界软件工程测试DeepSWE中以59.3%反超Opus-4.8登顶,并在零样本视觉推理测试ZeroBench中击败Opus-4.8。
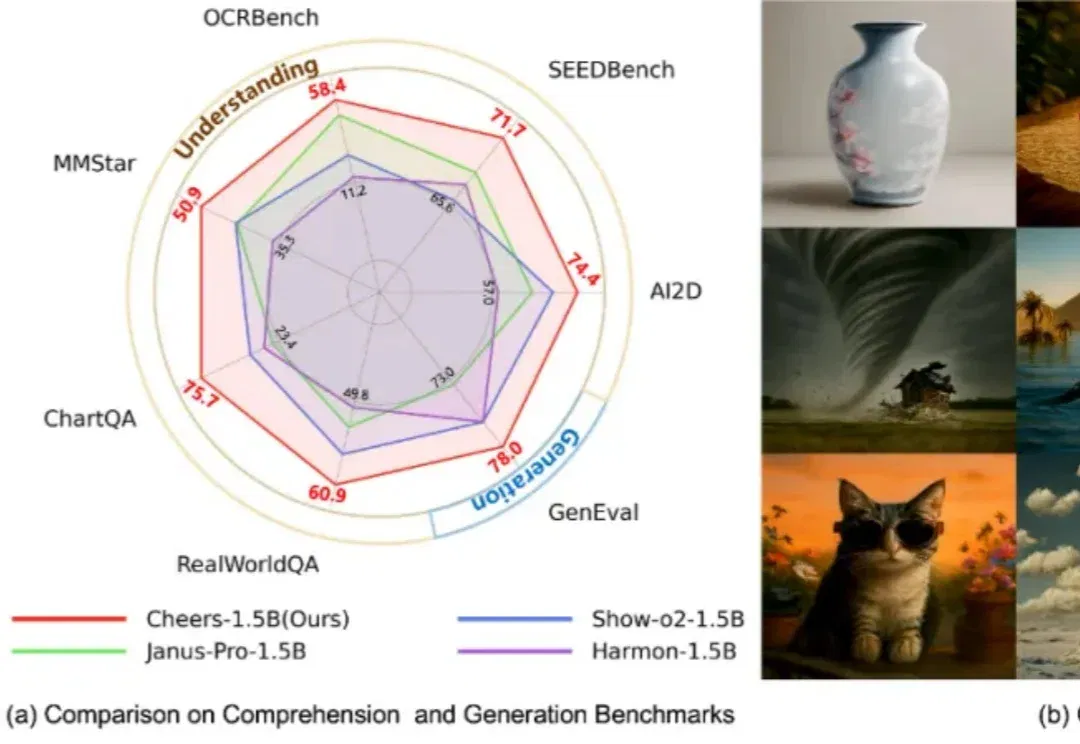
过去几年,多模态模型在理解任务上快速演进,图像问答、OCR、视觉推理、跨模态对话等能力不断提升;与此同时,图像生成模型也在视觉质量、指令遵循和细节表达上持续突破。下一步一个自然的问题是:能否用同一个模型,同时做好理解与生成?这正是统一多模态模型(Unified Multimodal Models, UMMs)正在回答的问题。
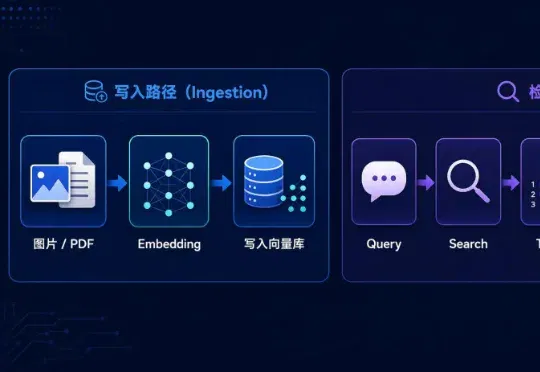
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
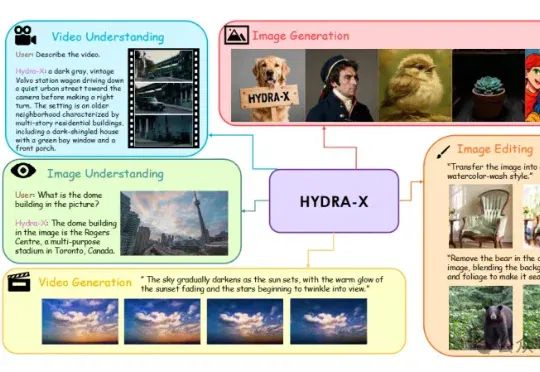
南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。
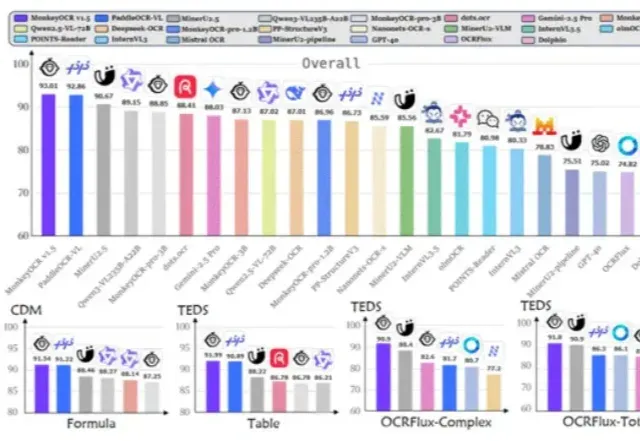
是金山派来的猴子,复杂文档解析有救了! 2025年6月以来,多模态文档解析领域迎来新一轮研究热潮,该方向逐渐成为多模态理解及大模型数据来源的重要前沿课题。 在数字化办公与AI技术深度融合的今天,文档智能解析技术已成为信息抽取、检索增强生成和自动化文档分析的核心基石。然而,现实世界中的文档往往布局复杂、表格嵌套、内含图片公式,甚至跨页分布,这让许多现有的OCR(光学字符识别系统,Optical Character Recognition)系统感到棘手。 MonkeyOCR v1.5是一个全新的统一视觉-语言文档解析框架。它在全能多模态文档解析基准OmniDocBench v1.5,OCRFlux
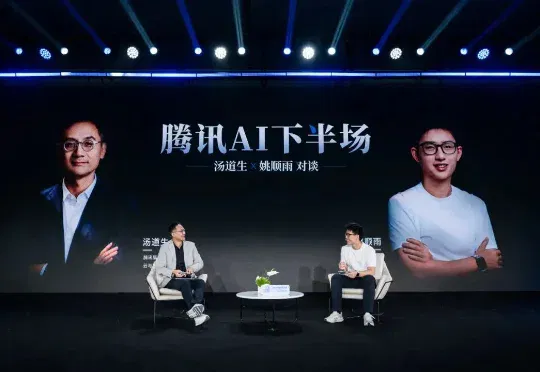
近日,腾讯宣布混元多模态模型部门与大语言模型部门合并,成立基础模型部,统一由腾讯首席AI科学家姚顺雨管理,以进一步提升模型研发和协同效率,探索全模态模型的智能上限。
DeepSeek 终于「开眼」了。就在刚刚,DeepSeek 推出了一款面向 Agent 时代的多模态模型:deepseek-v4-flash-vision-exp。目前,该模型已经上线 DeepSeek API 平台上,用户可以通过设置 model='deepseek-v4-flash-vision-exp' 访问该模型。
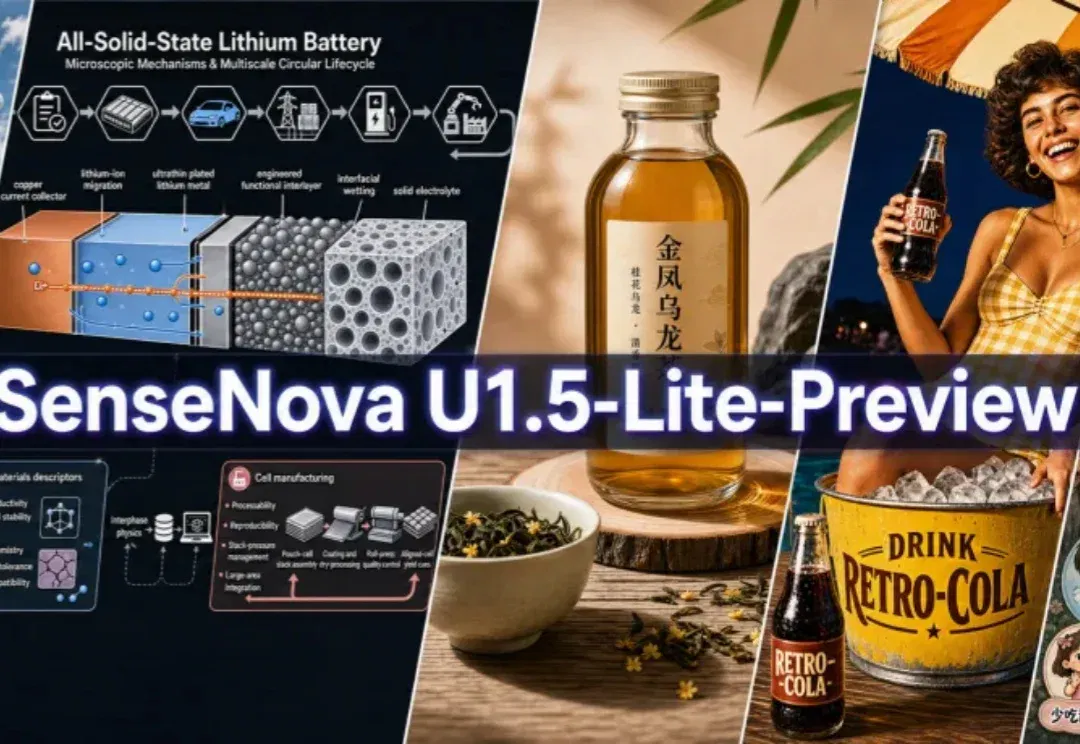
正式版将在近期推出并开源。 一张只有简单线条、栏目框架和流程箭头的手绘草图,交给AI后,能否直接变成一张符合商业出版标准的“深海潜水装备流程”高精海报? 下面这个案例中,模型不仅识别出了草图中的氧气瓶、面镜、潜水电脑表等装备,还保留了“装备总览、功能详解、下潜前检查、安全下潜流程、下潜后检查”五部分结构,并为不同栏目补充图片、图标和说明文字,将原本粗略的构想变成了一张深蓝科技风的完整设计图。 ▲模型根据草图生成彩绘海报 从草图到彩绘海报,AI需要读懂内容和结构,按要求补全细节、统一风格,还要保留不能改动的部分。 完成这项任务的,是商汤最新开源的轻量级原生统一多模态模型SenseNova U1.
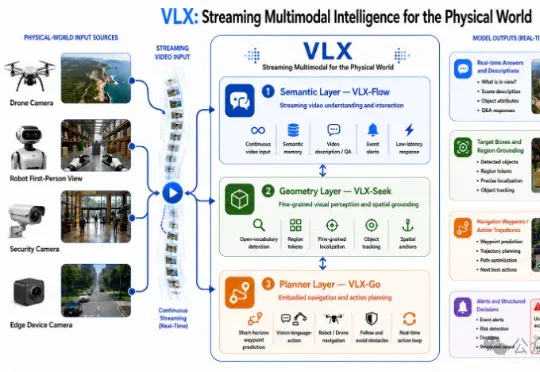
刚刚,Om AI发布全球首个面向物理世界的端侧流式多模态模型系列——VLX。VLX主打真实世界的端侧与具身场景,总共三款模型,三天连发:这三款模型连起来,不仅构成了多模态模型持续感知、精准定位、行动决策的能力闭环。
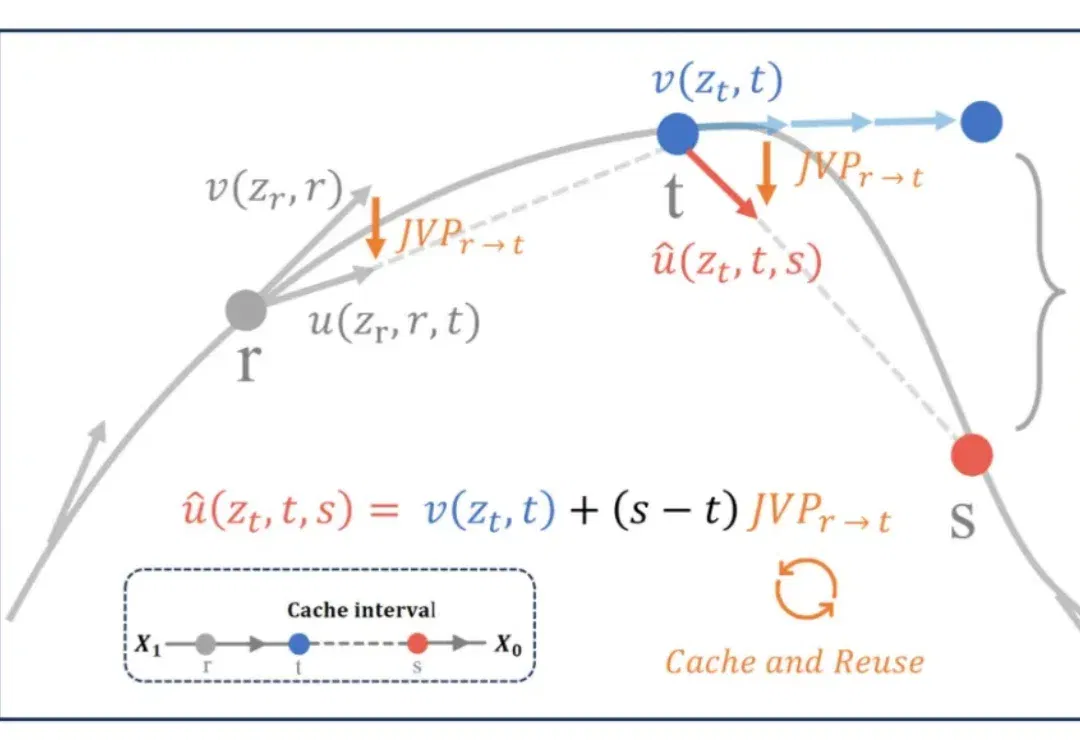
FLUX 、Qwen-Image 等多模态生成模型的推理速度一直是工业级多模态模型落地的痛点。传统的特征缓存(Feature Caching)方案在追求高倍率加速时,常因瞬时速度的剧烈波动导致轨迹漂移。