图像生成模型调优新思路:让解码器“提前适应”生成器的潜变量 (opens in a new tab)
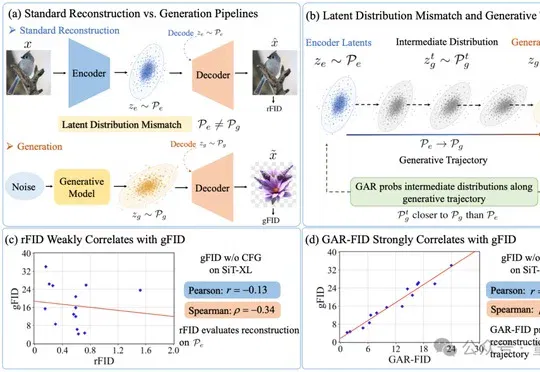
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
Total 21 articles
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
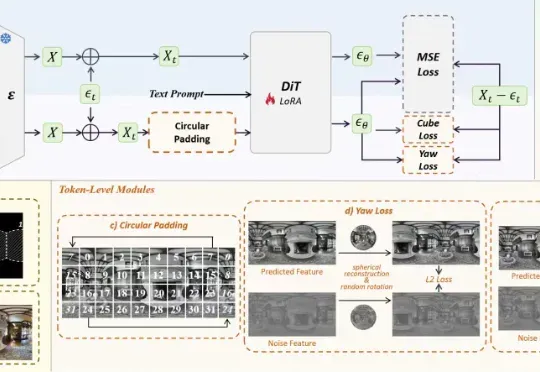
空间智能领域的全景数据稀缺问题,有解了。影石研究院团队,推出了基于DiT架构的全景图像生成模型DiT360。通过全新的全景图像生成框架,DiT360能够实现高质量的全景生成。
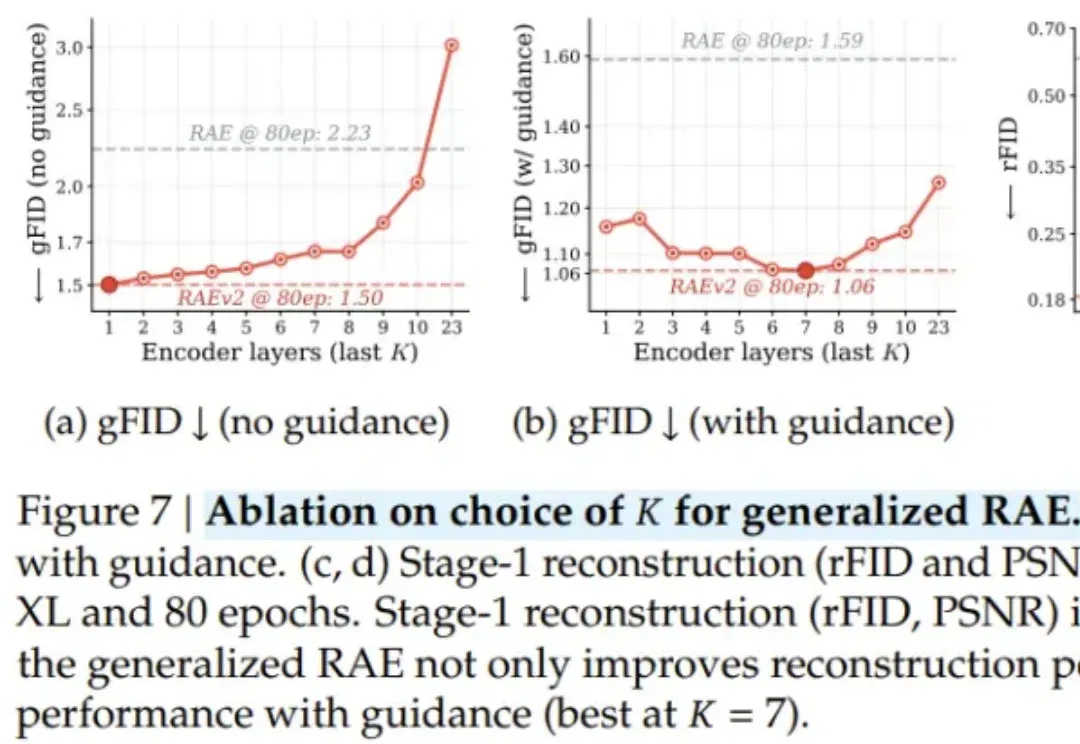
AI 图像生成通常遵循「能力越强、代价越高」的铁律;与此同时,学界却在悄悄质疑另一个更根本的浪费:传统 VAE 对图像语义几乎一无所知,而 DINOv2、SigLIP 等视觉编码器早已从数亿张图片中习得了丰富的视觉常识。图像生成模型,真的需要从零开始「发明」对图像的理解吗?
Meta超级智能实验室(MSL)扔出了首个图像生成模型Muse Image,代号「芒果」(Mango)。这是我们迄今为止最先进的图像生成模型。与Muse Image一同亮相的,还有视频模型Muse Video,目前仍是预览版。
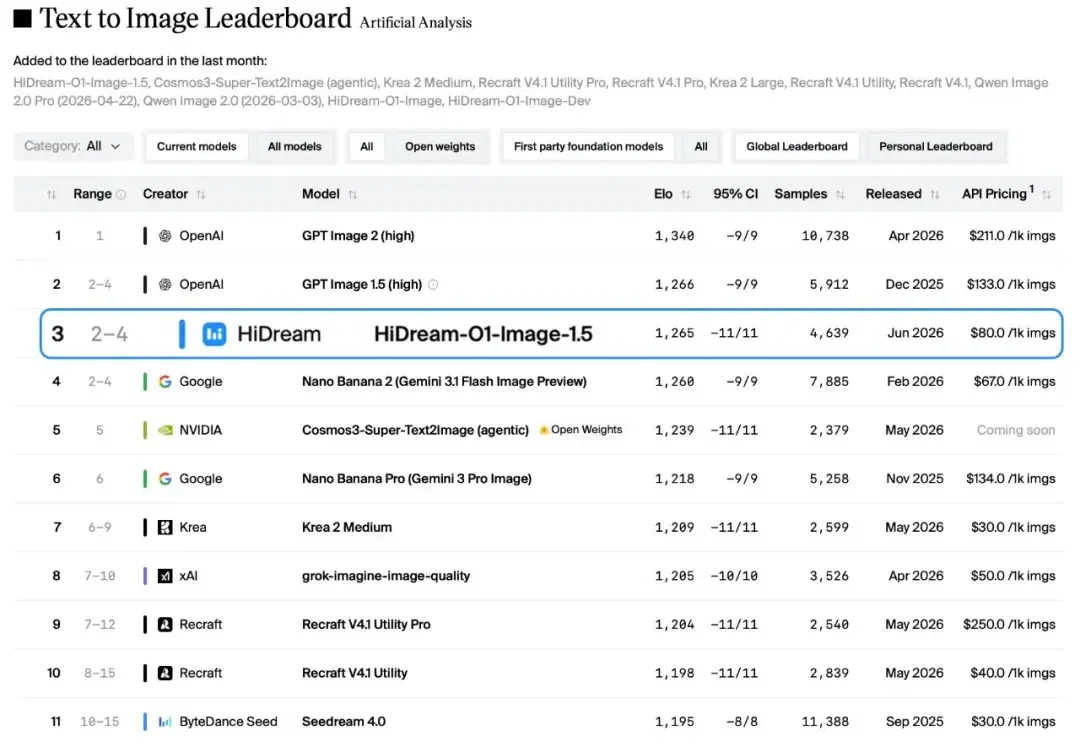
文生图的"慢思考",到底有没有用? “8B 开源版是一扇窗,真正的风景还在 200B+ 参数的 Pro 版本之后。” 智象未来 HiDream-O1-Image 开源版(8B)发布之后,我在测评最后留下了这样一句判断。前者以 Peanut 匿名登上 AA 榜、拿下文生图开源模型全球第一的事迹犹在眼前,今天 1.5 闭源版本又和公众见面了。 珠玉在前,HiDream-O1-Image-1.5 可以说是备受瞩目,而智象未来的官方口径很大程度上回应了这种期待:“连续登顶不仅印证了智象未来在图像生成大模型上的硬核实力,更标志着公司已稳居全球视觉生成大模型的第一梯队”。 看过 1.5 版本在 Artif
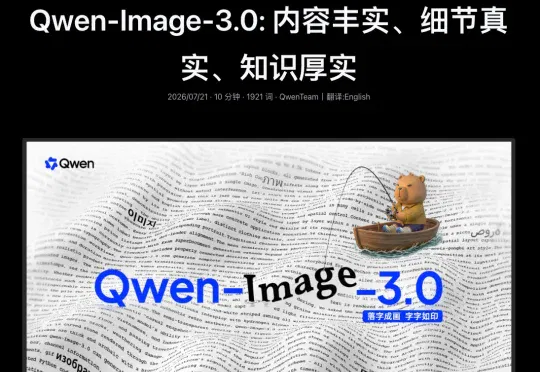
今天,阿里通义团队发布了他们第三代图像生成模型:Qwen-Image-3.0 。官方博客用了一个字来概括这一代的核心进步,「实」。不是好看,不是炫技,是「实」。内容丰实、细节真实、知识厚实。
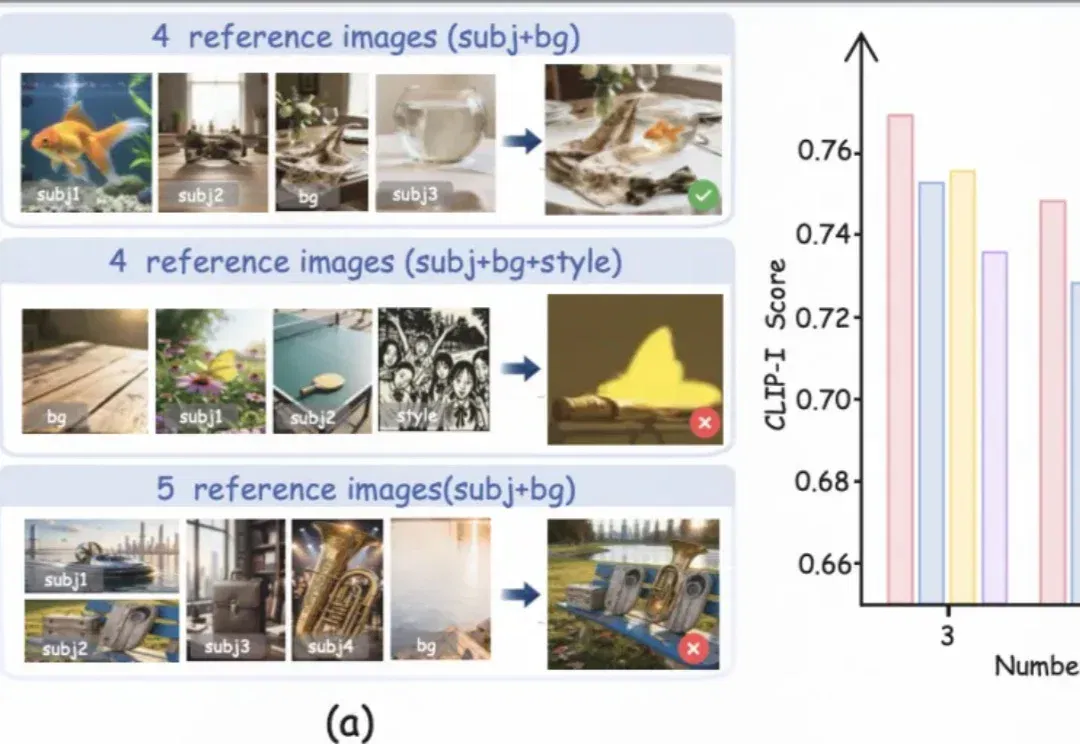
给图像生成模型一张人物参考图,它大概率能抓住身份特征。
今日,美团正式发布并开源图像生成模型LongCat-Image,这是一款在图像编辑能力上达到开源SOTA水准的6B参数模型,重点瞄准文生图与单图编辑两大核心场景。在实际体验中,它在连续改图、风格变化和材质细节上表现较好,但在复杂排版场景下,中文文字渲染仍存在不稳定的情况。
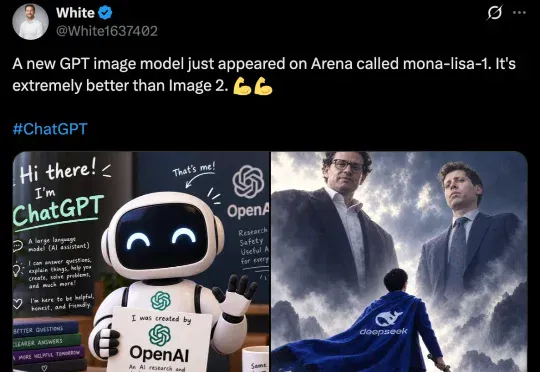
这两天,Arena 平台上突然出现一款神秘的图像生成模型,代号「mona-lisa-1」。有人让该模型「生成一张你的创造者的图片」,模型点名 OpenAI 和奥特曼。且有网友用 OpenAI 验证工具检测生成图片后,确认图片中带有 OpenAI 的 SynthID 水印。
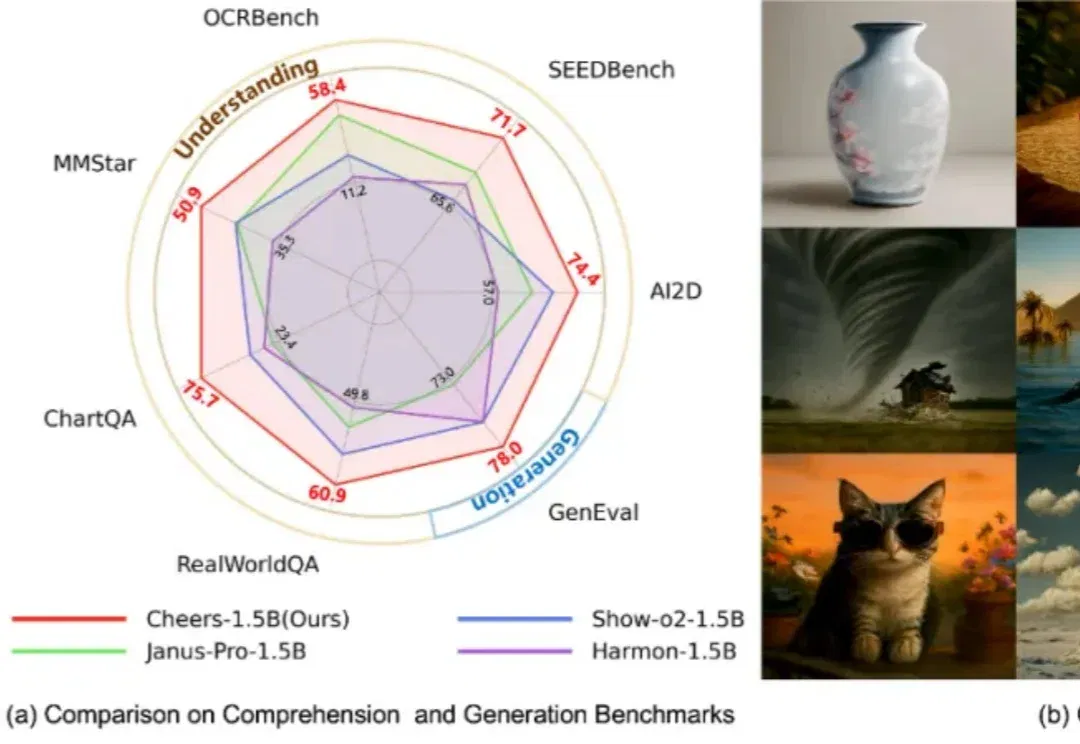
过去几年,多模态模型在理解任务上快速演进,图像问答、OCR、视觉推理、跨模态对话等能力不断提升;与此同时,图像生成模型也在视觉质量、指令遵循和细节表达上持续突破。下一步一个自然的问题是:能否用同一个模型,同时做好理解与生成?这正是统一多模态模型(Unified Multimodal Models, UMMs)正在回答的问题。