TML开放Inkling 2 Mini权重,以循环Transformer支持本地智能体
Thinking Machines Lab开放Inkling 2 Mini权重。模型为26B级多模态MoE,支持文本、图像输入及100万token上下文;中间12层循环三次,增加内部推理计算。官方展示了48GB MacBook Pro上的离线演示,并提示多轮对话、复杂约束与高难推理仍有短板。
编辑更新(2026-11-22):开头“这项声明仍待独立核验”反映的是报道时的早期状态,现已过时。Lean与Mathlib社区于2026年11月21日发布联合声明,确认Levent Alpöge提交的黎曼猜想数学命题及Lean形式化证明正确;MIT核验页面列出编译、命题比对和独立检查器等结果及后续检查进展。后文关于Inkling 2 Mini的发布、演示和能力限制仍按原报道阅读。Lean/Mathlib联合声明(在新窗口打开);MIT核验记录(在新窗口打开)
昨晚,黎曼猜想的一份 AI 证明声明,把大模型的推理能力再次推到聚光灯下。Anthropic 数学家 Levent Alpöge 宣称,自己与 Claude 合作找到了证明,并公布了形式化材料。虽然这项声明仍待独立核验,但已经让人们重新追问:AI 究竟能完成多复杂的工作?
而刚刚,Thinking Machines Lab(TML)发布并开放了Inkling 2 Mini的权重。
这是一个总参数 26B 的多模态模型,采用循环 Transformer(looped transformer)架构,支持文本和图像输入,最大上下文窗口为 100 万 token。权重已按 Apache 2.0 许可发布,开发者可以下载部署,也能通过 Tinker 进行推理和微调。
- 模型卡与权重:https://huggingface.co/thinkingmachines/Inkling-2-Mini
- 官方博客:https://thinkingmachines.ai/news/inkling-2-mini/
官方宣称能在笔记本上运行,并且能胜任智能体工作。看起来,它要展示的是个人电脑上的模型能做到哪一步。
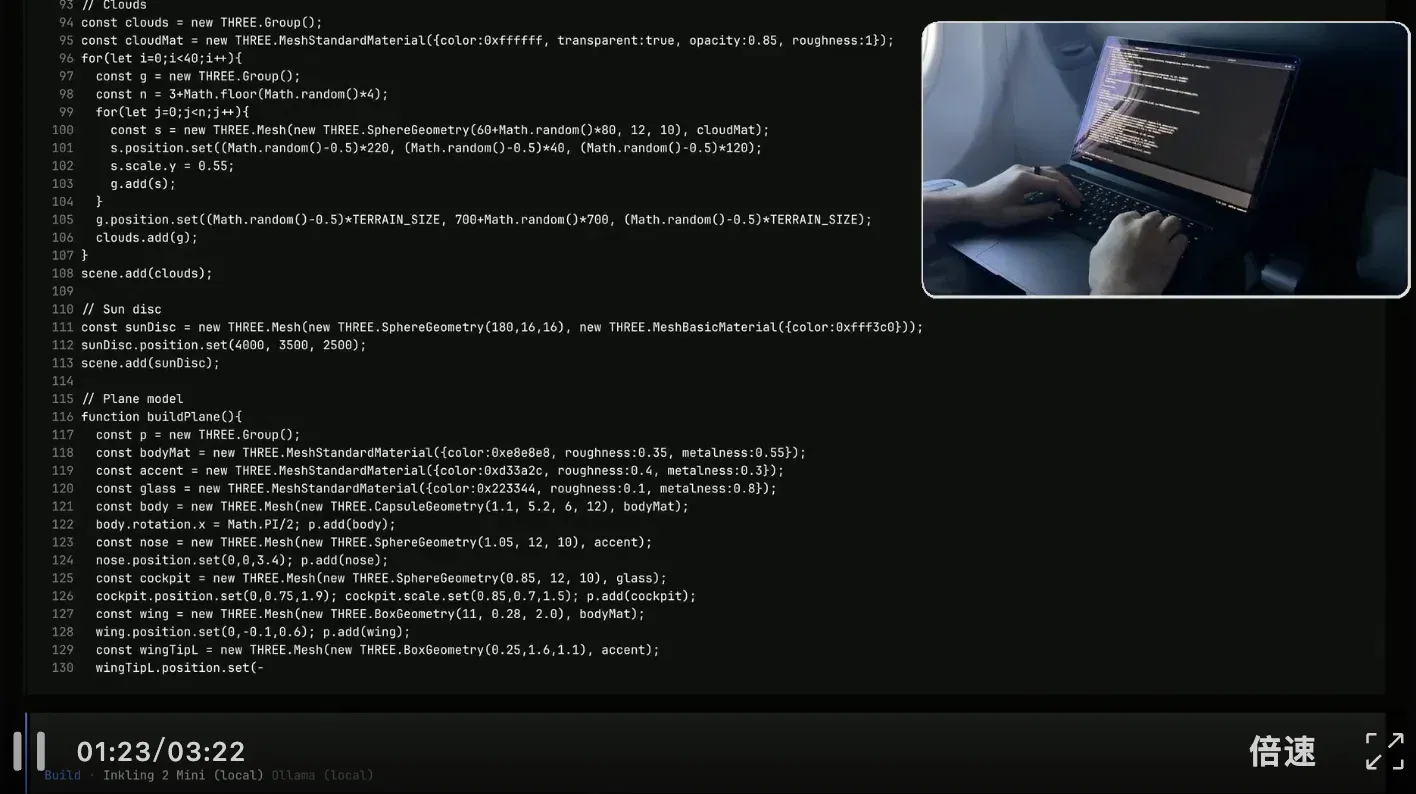
在 TML 公布的演示中,研究人员带着一台 MacBook Pro 登上飞机,断开网络,让 Inkling 2 Mini 在几分钟内写出了一个可玩的飞行模拟器。演示使用的是配备 48GB 内存的 M5 Pro 机型,推理在本地完成。
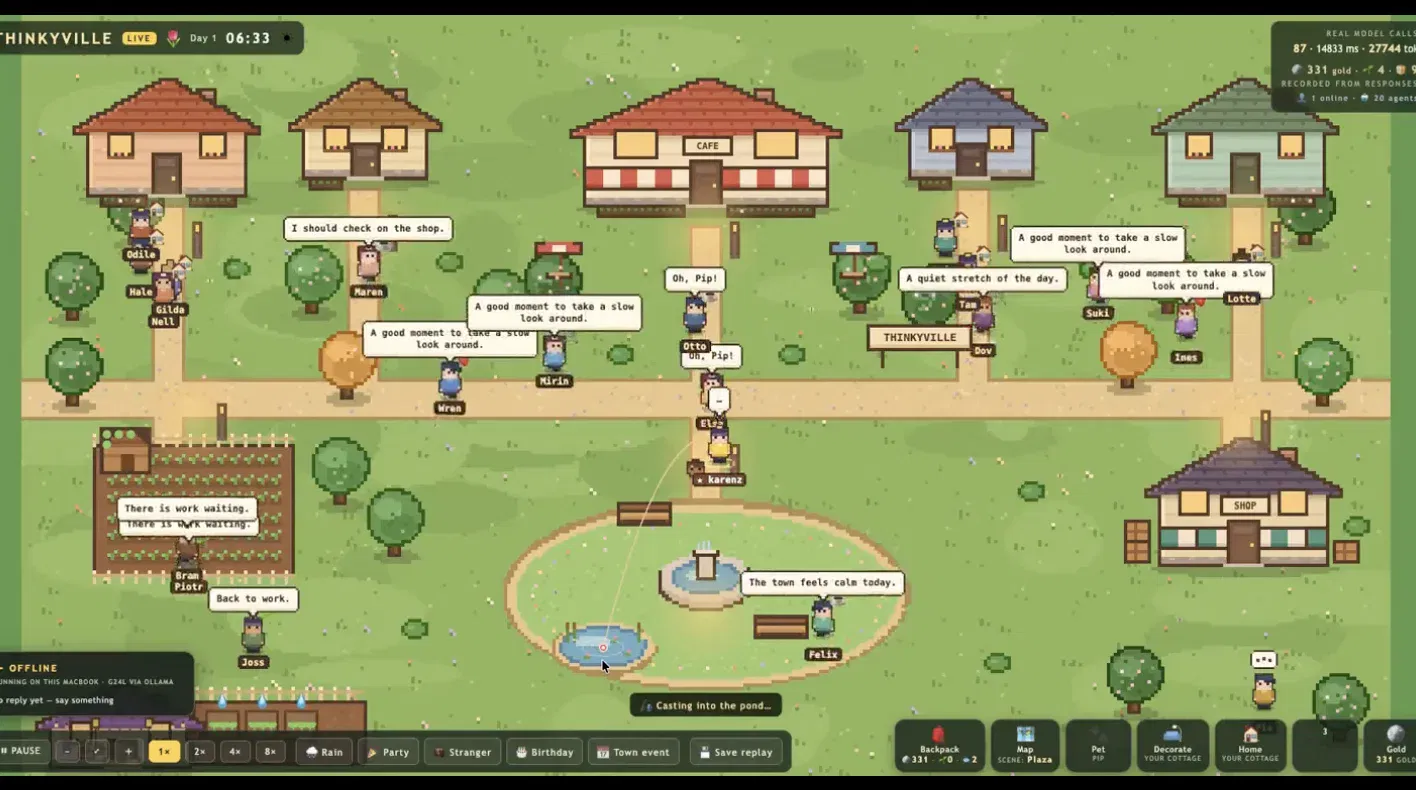
他们还构建了一个由 Inkling 2 Mini 搭建的微型像素小镇 Thinkyville。其中,同一模型在一台离线 MacBook 上驱动全部 20 位村民。他们规划一天的生活、闲聊八卦、举办烘焙比赛,还会回复你留在他们门上的便条。
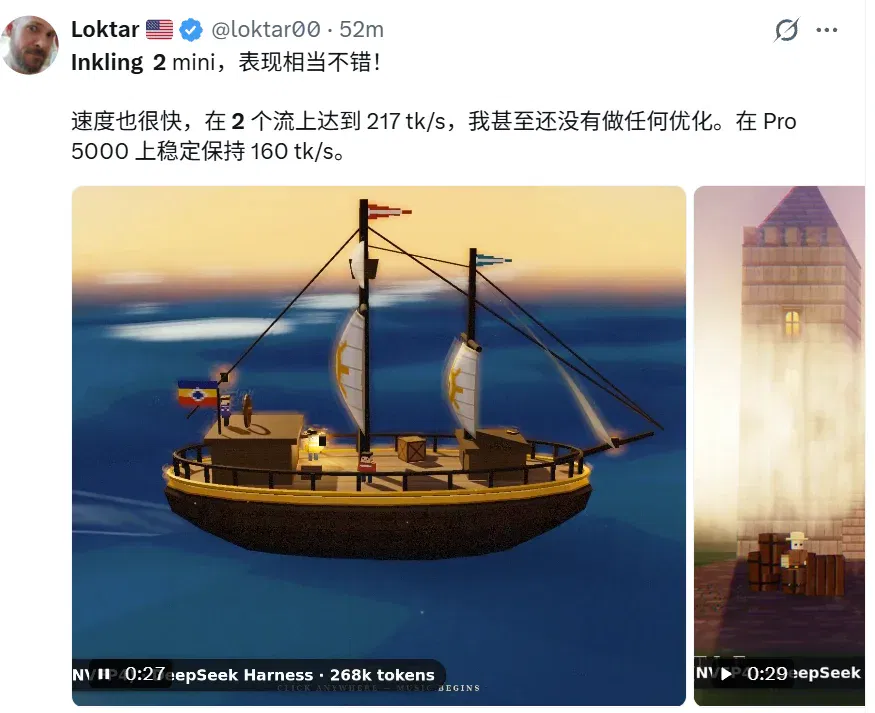
模型发布后,社区反映非常热烈。有人将其接入了 DeepSeek Harness,跑出了飞快的速度。
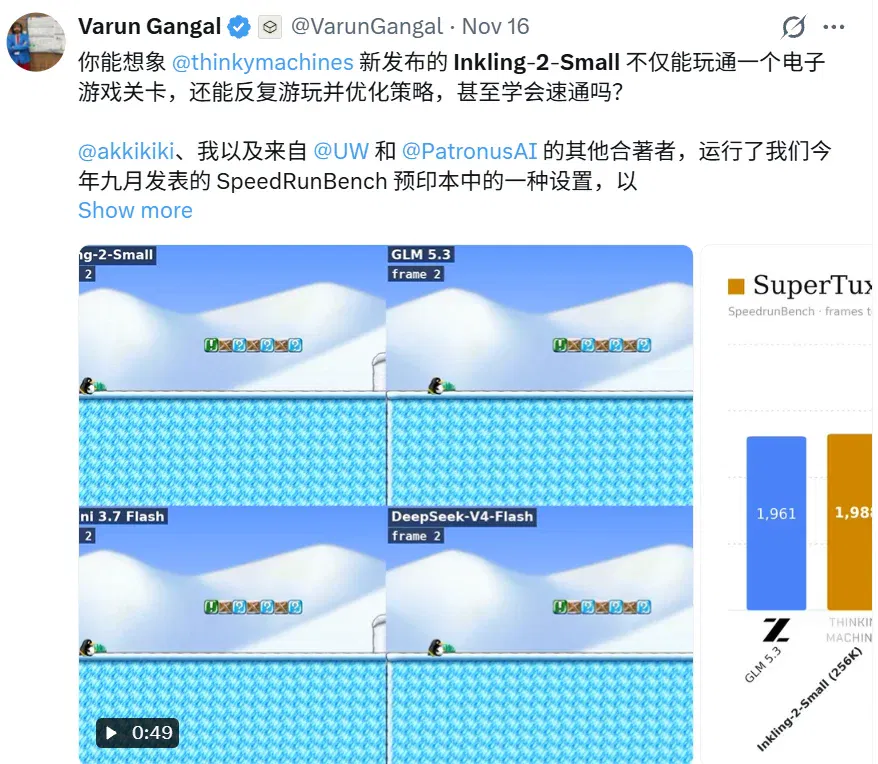
还有人让它玩通了一个电子游戏,并且发现它还能反复游玩并优化策略,并学会速通。
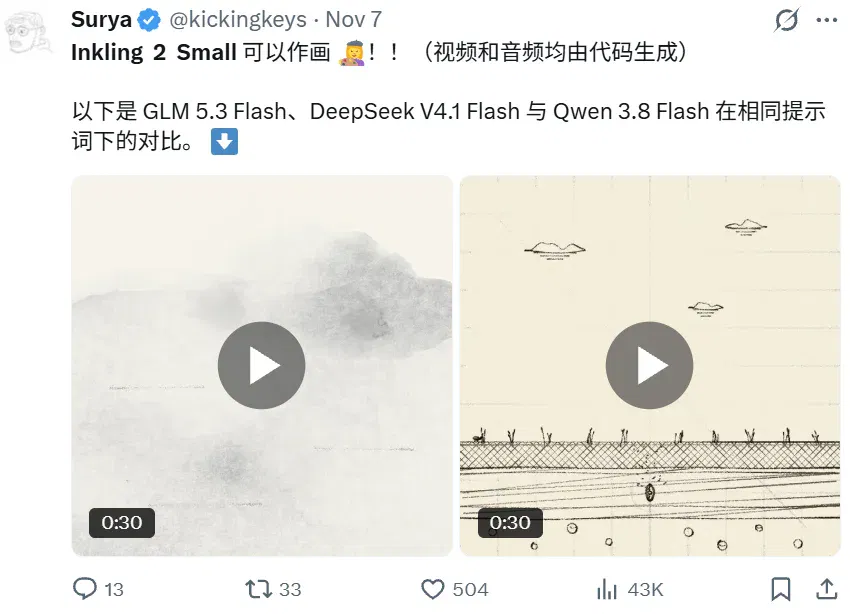
生成动画 MV 也没有问题:
让同一组权重,多算几轮
Inkling 2 Mini 的技术看点,在于它采用了循环 Transformer架构。
普通 Transformer 在生成每个 token 时,会让信息依次经过一组固定的网络层。Inkling 2 Mini 则把中间一段网络重复利用:全模型共 24 层,最前和最后的 6 层各运行一次,中间 12 层运行三次。后续轮次还会读取上一轮传来的信息。
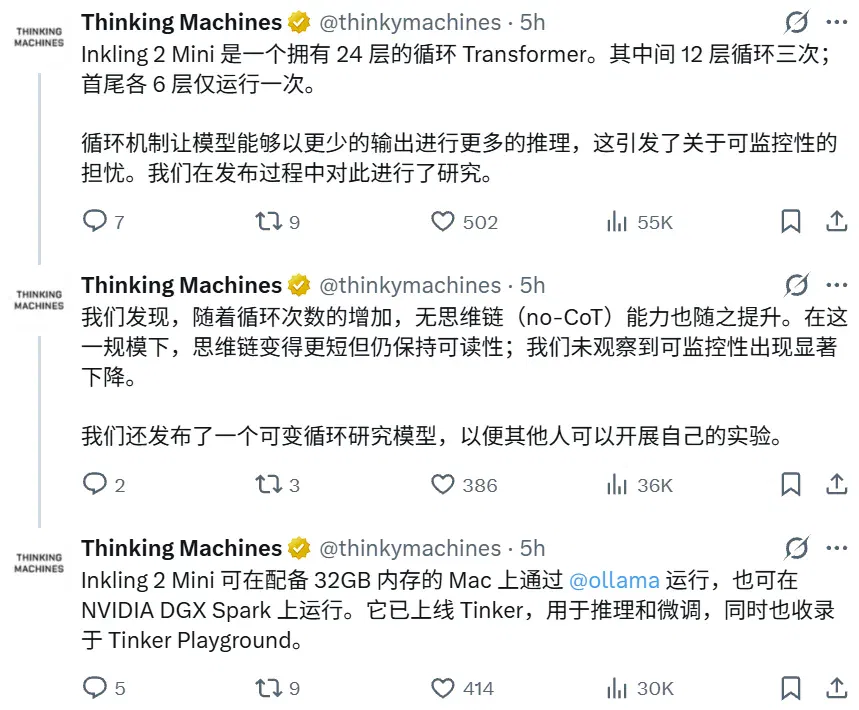
因此,模型只需存储 24 层权重,就能为每个 token 完成 48 次层计算。增加的内部计算,为需要连续推导的任务提供了更多处理空间,同时控制了权重体积。
它还采用了混合专家(MoE)架构,每个 token 只调用部分专家参与计算。模型的激活参数约为 3.4B;将循环中的重复计算计入后,有效参数激活量约为 5.4B。
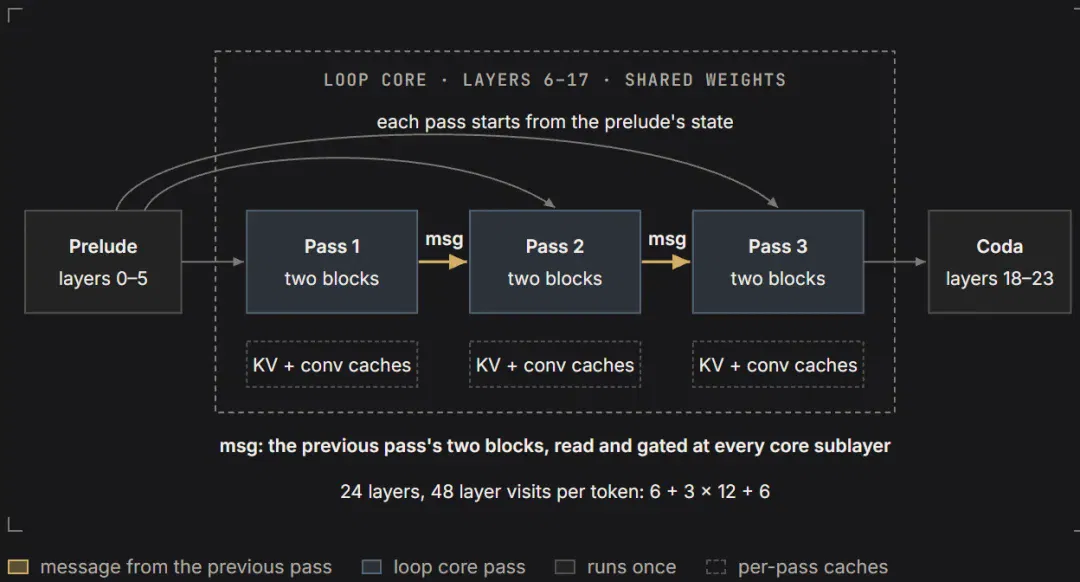
https://vllm-project.github.io/2026/11/20/inkling2-mini.html
编程表现
从 TML 公布的评测看,Inkling 2 Mini 的长处集中在智能体编程、搜索和工具使用上。
在 DeepSWE v1.1 上,它的任务解决率为48.2%,对比的 Qwen3.8-27B 为 42.2%;在 SWE-bench Verified 上,两者分别为79.2%和 77.8%。
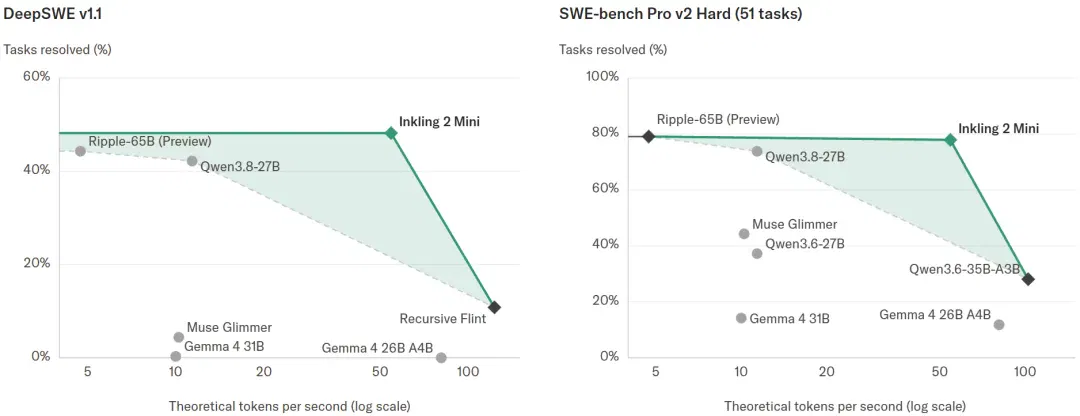
要把这样的模型放进笔记本,权重的存储方式也很关键。Inkling 2 Mini 的专家层主要使用 NVFP4 低精度格式,最后 4 层采用 MXFP8。它在训练中就使用了相应精度,并以同样的精度部署,减少了交付时再次转换精度的环节。
发布的检查点约为 20GB。官方支持在至少配备 32GB 内存的 Apple 芯片设备上运行,其他 GPU 平台建议至少提供 32GB 显存;本地推理已有 Ollama、vLLM、SGLang 等工具支持。
更短的思维链
循环计算还有一层值得关注的含义:模型可以在输出文字之前,完成更多内部处理。于是,研究者需要继续检验,写出来的思维链能在多大程度上帮助人们理解和监督模型。
为此,TML 同步开放了TML-d24-varloop-research。与固定循环三次的 Inkling 2 Mini 不同,这个研究版本允许在推理时调整循环次数,方便研究者在同一组权重上比较增加计算的影响。官方明确将它定位为研究模型,实际产品应用仍推荐使用 Inkling 2 Mini。
链接:https://thinkingmachines.ai/model-card/tml-d24-varloop-research/
Inkling 2 Mini 也有明确的能力边界。按照 TML 的说明,它在多轮对话和多重约束指令上仍有短板,复杂推理表现与更大模型存在差距;增加循环次数,也不会直接扩大权重中储存的事实知识。
这次发布值得关注的地方,是在有限的权重体积里增加推理计算,并把模型交给开发者在自己的设备上运行。对于希望搭建本地编程助手或长期运行智能体的人,Inkling 2 Mini 算是一个值得一试的新选择。
更多细节请访问官方博客与仓库。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Thinking Machines发布Inkling 2 Mini:27B级循环MoE模型开放权重 (opens in a new tab)
Thinking Machines Lab发布Inkling 2 Mini开放权重,以循环中间层增强推理。模型为27B级MoE,独立激活参数3.4B,计入循环的每token权重激活量为5.4B,总内存占用约20GB。团队报告其在指定长期智能体基准中表现领先,多轮对话与复杂约束任务仍有局限。
Thinking Machines 发布 Inkling 2 Small,披露部分训练轨迹采自 Kimi K3 (opens in a new tab)
Inkling 2 Small 为 594B 参数的混合专家模型,每次推理激活 17B。技术博客说明后期训练使用 Kimi K3 和自有模型的部分轨迹,开放权重仍在计划中。
不打榜的美国开源新王Inkling:975B原生多模态、仅用 1/3 Token 追平英伟达 (opens in a new tab)
时至今日,全球大模型格局已成定数,还有必要耗费巨资从零开始训练一个新模型吗?
刚刚,PyTorch之父光速入职TML!离职Meta刚过一天,投身500亿估值独角兽 (opens in a new tab)
刚刚,才离开 Meta 不久的 Soumith Chintala 发布了一条推文,盛赞 Thinking Machines Lab(以下简称 TML)的人很了不起(incredible)。与此同时,这位 PyTorch 之父也更新了自己的个人介绍,正式官宣加入 TML,并表示正在这家估值已达 500 亿美元的创业公司「创造新东西(Building new things)」 。
老黄30亿美元押注穆拉蒂!估值冲到400亿,钱转一圈又买英伟达的卡 (opens in a new tab)
这回,老黄把AI基建的触手,伸进了模型层。