SAG2 用关键词检索构建本地知识库,SAG Wiki 提供桌面端
SAG2 在建库阶段使用 BM25 索引,检索时用 JEV 判断候选证据。文章比较团队报告的建库耗时,并用公众号文章、研报和代码展示 SAG Wiki 的多跳检索。
编辑更正(2026年11月10日)SAG2 的建库耗时为项目所报的测试结果。建库可以在本地完成,检索和问答所用模型及数据传输范围取决于配置。
大家好,我是一直在跟知识库打交道的袋鼠帝。
在 AI 圈,每天都有新东西冒出来,但已经好久没有一个东西,能让我看完浑身起鸡皮疙瘩了。
最近开源的SAG2,真就做到了。它用关键词索引组织本地文件,建库阶段无需生成嵌入向量。
https://github.com/Zleap-AI/SAG-Wiki
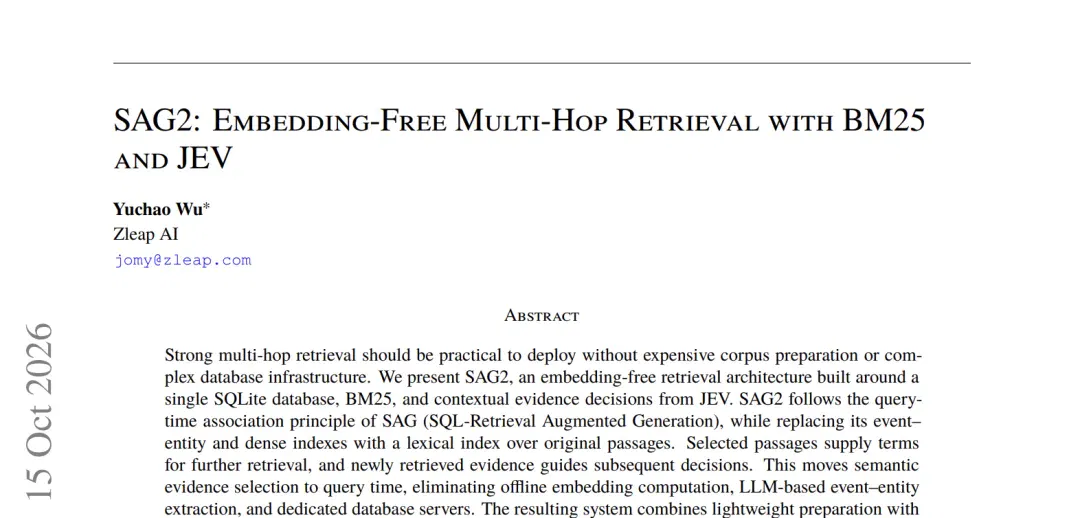
当然SAG2是理论,而已经实现的可用的工具是SAG Wiki(待会儿会讲到)
这么🐂🍺的开源项目,我必须得提一下作者:广州智跃深空(Zleap),SAG到SAG2都是完全由他们自研,非常厉害的一个团队。
老粉应该记得,6 月我写过一篇SAG第一版的文章。
那会儿 SAG 刚开源,我被它用 SQL 现场串多跳线索的思路吸引了,还建议大家可以把它当 MCP 接进 FastGPT。
但用过的朋友也知道,一代在落地时依然要调大模型逐段提取事项和实体,建库耗时还是比较长,很多人觉得在工程上还是有点折腾。
结果才过了 4 个多月,他们自己把这些全砍了。
现在SAG2建库不调大模型,不做 Embedding,不要向量数据库,也不要 GPU。对同样规模的 11,656 段文本,项目分别报告了 4.57 小时与 2.36 秒的建库耗时,差距也受测试条件影响。
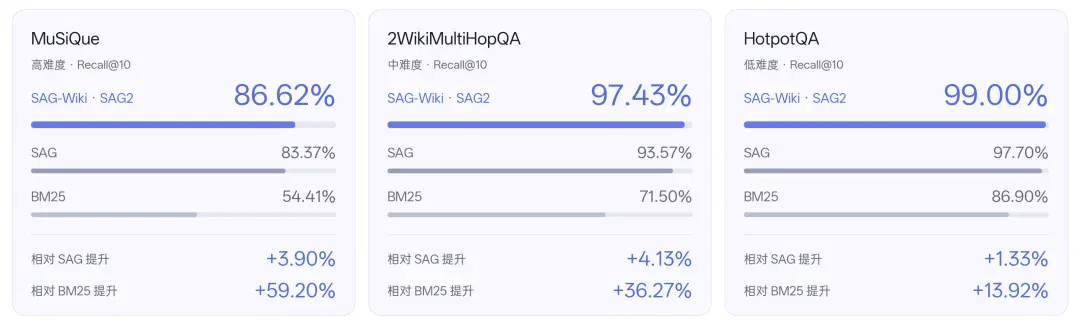
效果呢?还变得更好了。三个多跳检索测试集,8 项指标全部第一。
卧槽。。
知识库一直有个不可能三角,又轻、又便宜、又准,以前最多只能满足两个。这下SAG2直接给它打破了!
我为什么这么兴奋~
可能是因为,我从24年初裸辞 All in AI 开始,就一直在跟知识库打交道。也写过很多关于知识库的文章。
24 年初,我裸辞后的第一桶金,就是帮一个老板部署 FastGPT、搭知识库、调优效果。后来又陆陆续续接了不少类似的单子。
搭一个知识库其实不难,难的是后面的维护和调优。
分块也是个问题,张三负责 A 项目和 500 万预算被切成两段,线索就断了。score 调低了噪音多,调高了又容易漏东西,经常是按下葫芦浮起瓢。我有个好朋友的公司,组了六个人的团队,花了整整半年,才把回复准确率调到一个相对满意的状态。
更烦的是维护。文件一改,就得重新上传、重新切块、重新向量化一遍。
预处理、调优、维护,这几个坑我基本都踩过。所以看到 SAG2 的思路,我是真滴有点激动。
先带大家简单捋一下知识库这几年是怎么走过来的吧,不然很难说清 SAG2 到底新在哪、好在哪。
RAG这个词其实 2020 年就有了,出自 Facebook(现在的 Meta)的一篇论文。
真正火起来是 23 年 ChatGPT 之后:
大模型不知道你公司的事,那就先把资料切成小块、转成向量存起来,提问时找最像的几块丢给它。FastGPT、Dify 这类平台,把这套流程做成了UI界面点点点的操作。
再往后,大家发现光靠向量不够,全文检索+向量检索+重排序的混合检索就成了标配。到今天,它依然是最成熟的工业方案,日常的单文档问答完全够用。
它的短板是多跳。还是上次那个例子:
文档1:A公司全资收购了B公司。
文档2:张三被任命为A公司的CTO。
文档3:张三离职,加入了盘古大模型项目。
问:收购了B公司的企业,其CTO后来加入了哪个项目?
文档3里,收购、B公司、CTO 一个词都没有,线索到这就断了。
于是有了知识图谱:
24 年微软开源了 GraphRAG,后来又有 LightRAG、HippoRAG 2 这些。入库前,先让大模型把人名、公司、事件之间的关系全抽出来,画成一张大图。多跳确实强了,代价就是贵和重:索引阶段要大量调用大模型,新文件进来,关系可能还得重算。
今年 4 月,卡帕西分享了 LLM Wiki 的思路:
让大模型把原始资料读一遍,编译成一套 wiki 页面,再对 wiki 做问答,产出的结果再回填进去。我写仓颉.Skill 的时候还专门借鉴过它。这套方式对个人知识整理很友好,页面读起来也舒服。但资料一多,大模型逐篇读、逐篇写的时间和 Token 就上去了,原文一改,对应的页面还是得重写。
还有 Google 的NotebookLM。年初那篇工具推荐里我还推荐过它,资料往里一扔就能问答、出摘要、生成播客,啃大部头简直是神器。不过资料得传到云端,每个笔记本能放的来源有上限,想让本地 Agent 直接调用也不太方便。
你会发现一个规律:每往前走一步,基本都是在入库时多花一点钱、多调一点模型,换检索的准确度。
SAG 一代也是类似的,只是比 GraphRAG 更轻了:
不画全局大图,只提炼事项和实体,查询的时候再用 SQL 串起来。
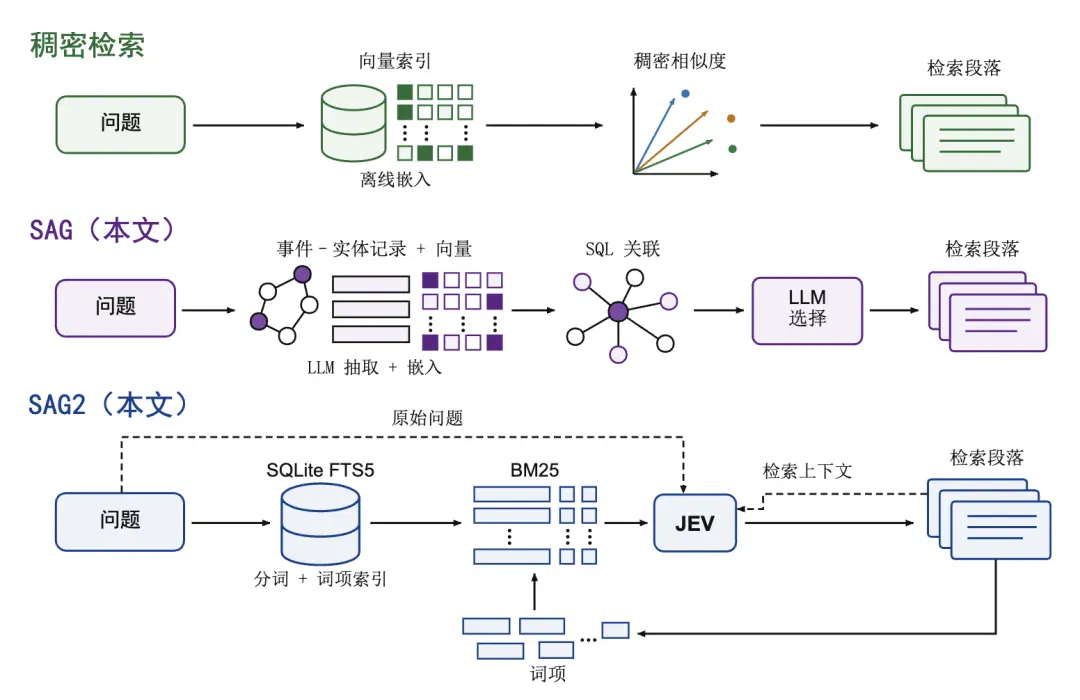
但 SAG2 干的事情,是把这条路反过来走。
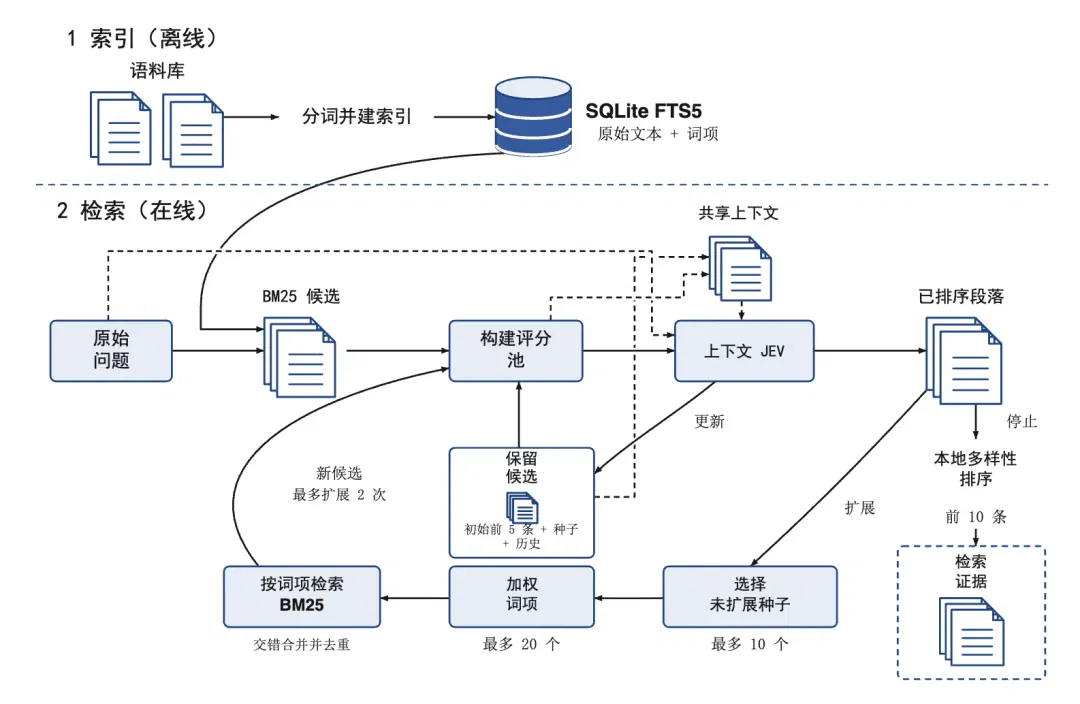
建库阶段,SAG2 啥模型都不调,直接对原文建关键词索引,用 BM25 打分。
BM25 可能很多人没听过,但它其实是个老古董了,90 年代就有,你用过的 Elasticsearch(开发者应该很熟悉了),默认打分用的就是它。
同样是 11,656 个段落,原 SAG 论文报告的建库时间是4.57 小时,消耗2,826 万 tokens。
这次,他们在一台 M4 Pro、64 GB 内存的 Mac 上,从空数据库连续重建三次,中间值只有2.36 秒。而且没有token消耗~
按两次报告的记录,建库耗时相差约 7,000 倍,数值仅对应所述测试。
一个刷新 SOTA 的新方案,底座是一个三十年前的老算法。难道这就是返璞归真?🤔
那语义理解从哪来?靠 JEV。
JEV 是前 OpenAI 研究员 Diogo Almeida 9 月份发布的模型,它不能写文章,也不能陪你聊天,你给它问题和候选内容,它只回你一个判断和打分,但又快又便宜。
所以 SAG2 的分工是这样的:
BM25 先粗筛出候选,JEV 判断哪些是有用的证据;算法再从有用的段落里挑出关键词,接着往下搜;JEV 结合已经找到的证据,再判断新找到的内容。
还是张三那个例子,SAG2 会这么走:
第一轮,拿收购、B公司去搜,命中文档1,JEV 判断有用。 从文档1里挑出关键词 A公司,接着搜,命中文档2,得知 CTO 是张三。 再拿张三去搜,命中文档3:盘古大模型项目。
SAG 一代串线索靠的是事项和实体,得提前用大模型抽像出来。
SAG2 换成了关键词和段落,一个关键词连着好几个段落,一个段落里也有好几个关键词,这些联系直接来自原文,根本不用提前处理。
打个比方,以前是图书馆开张前,先请人把每本书都读一遍、写好卡片;现在是你来问的时候,管理员拿着目录飞快地翻,旁边站着一位老师傅,每递过来一本,他扫一眼就告诉你:这本有用,那本没用。但这种基于计算机的速度是贼快的。
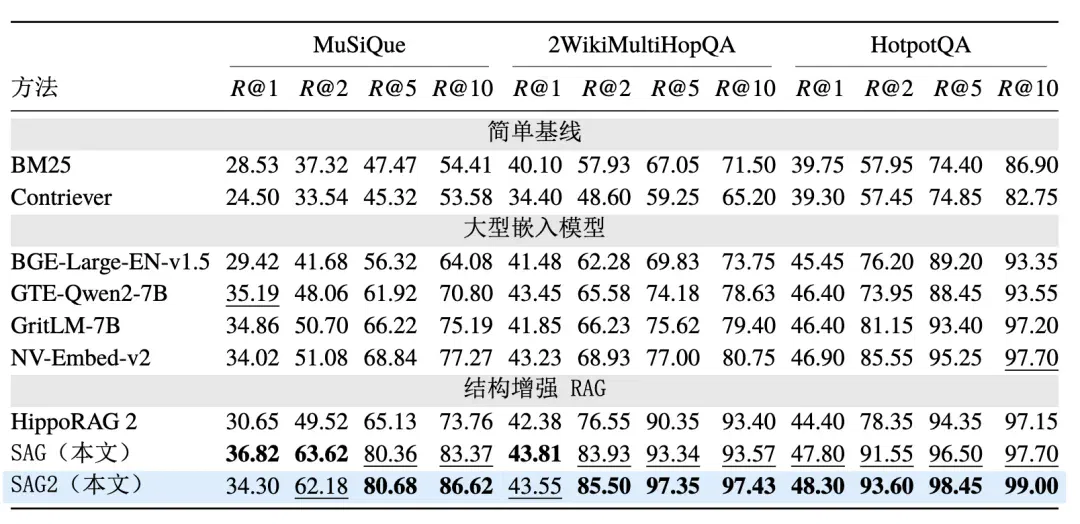
我上次写 SAG 时,最难的 MuSiQue 上 Recall@5 是 80.04%,这次是 80.68%,比 HippoRAG 2 高了 15.55 个百分点。我本来以为砍掉预处理效果得退一点,结果没退反进。
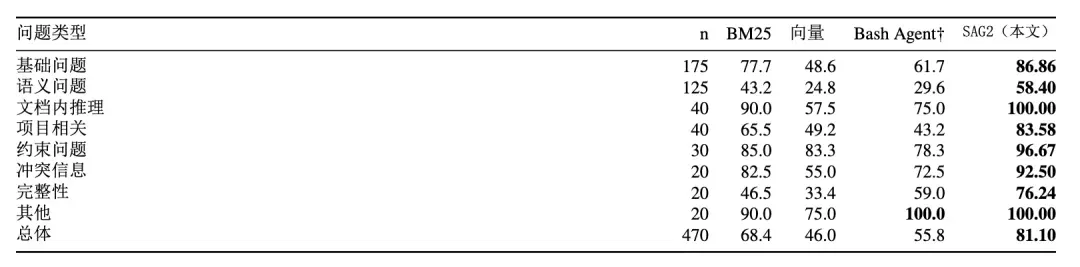
更让我佩服的是 EnterpriseRAG-Bench,51 万份模拟企业邮件、工单、会议记录的文档。一项规模研究里,LightRAG、MS-GraphRAG、HippoRAG 2 这些图谱方案都没跑完全量。SAG2 全部跑完,建库 8 分 32 秒,文档 Recall@10 达到 81.10%。
另外,基于 SAG2,他们还开源了桌面端 SAG Wiki(这就非常方便了):
Windows 版约 13 MB,macOS 约 18 MB。非常轻量~
添加一个本地文件夹就是知识库,文件不用动,改了自动增量更新。问答模型我配的是 DeepSeek V4.1 Flash。
https://github.com/Zleap-AI/SAG-Wiki
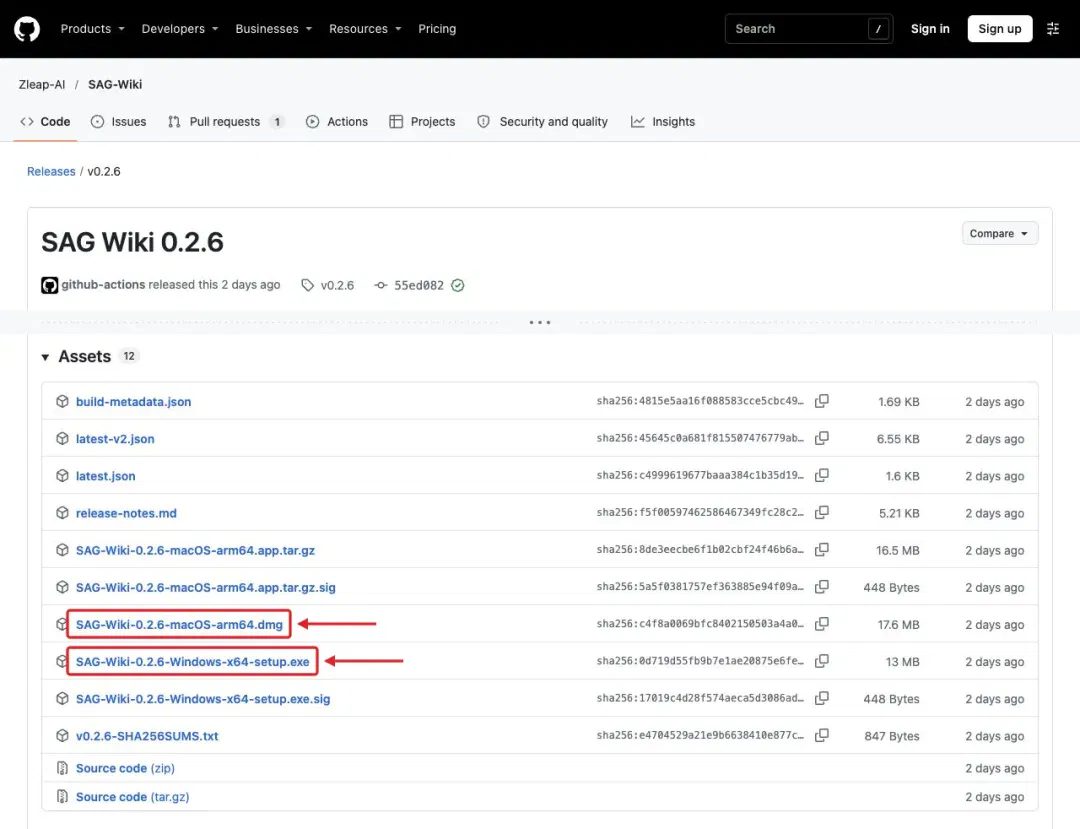
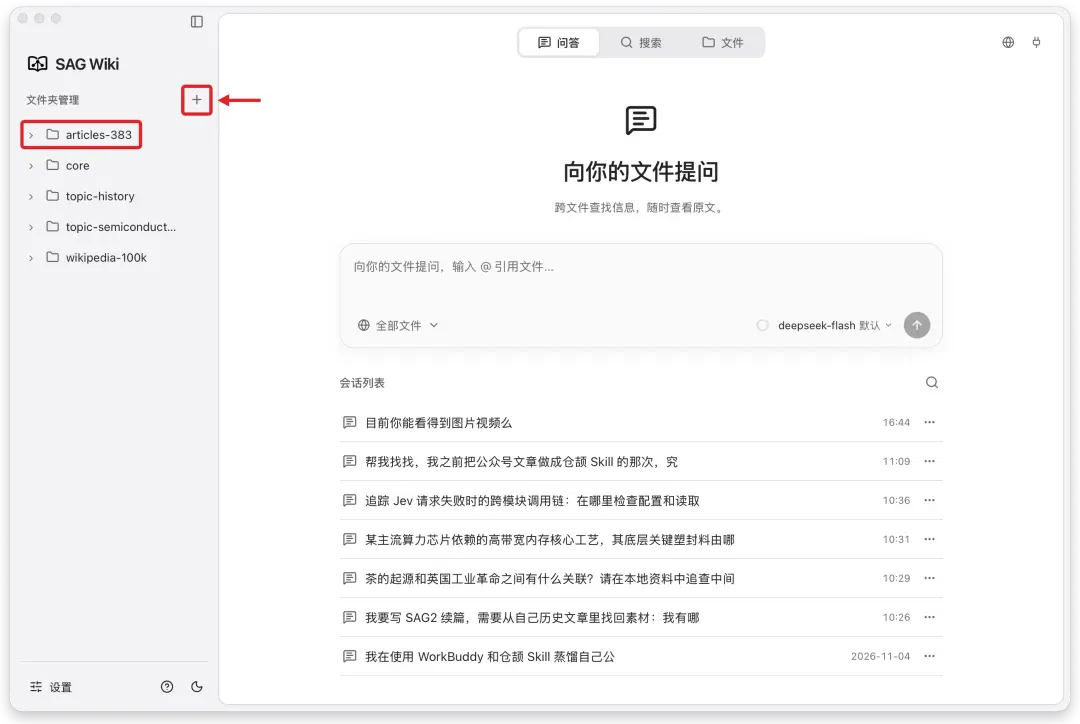
配置只需两步:在设置里配好两个模型,问答模型负责生成回答,可按需自选(譬如便宜大碗的 DeepSeek );决策模型负责找线索,官方论文用的是 TypeSafe 的 Jev 模型,这是官方固定的决策模型,配置时填入对应的 Jev Key 即可,有需要也可以改成别的决策模型。
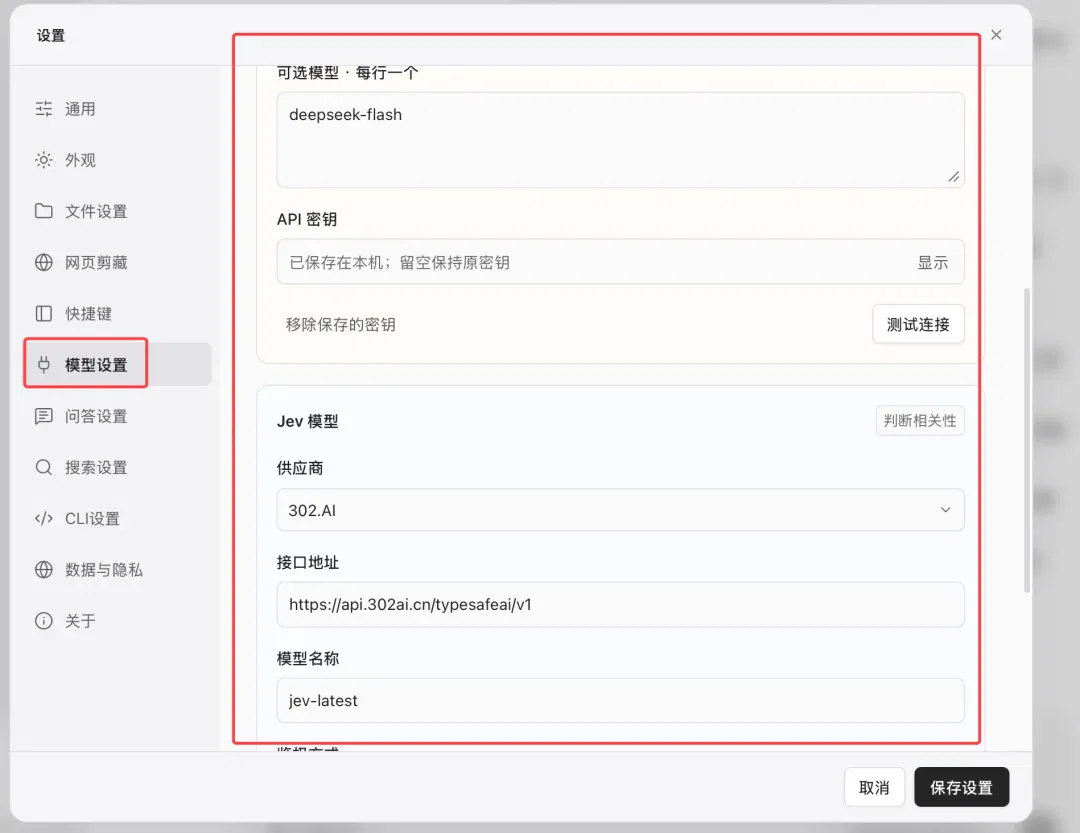
配置好后,就可以回到首页添加文件夹(知识库)了
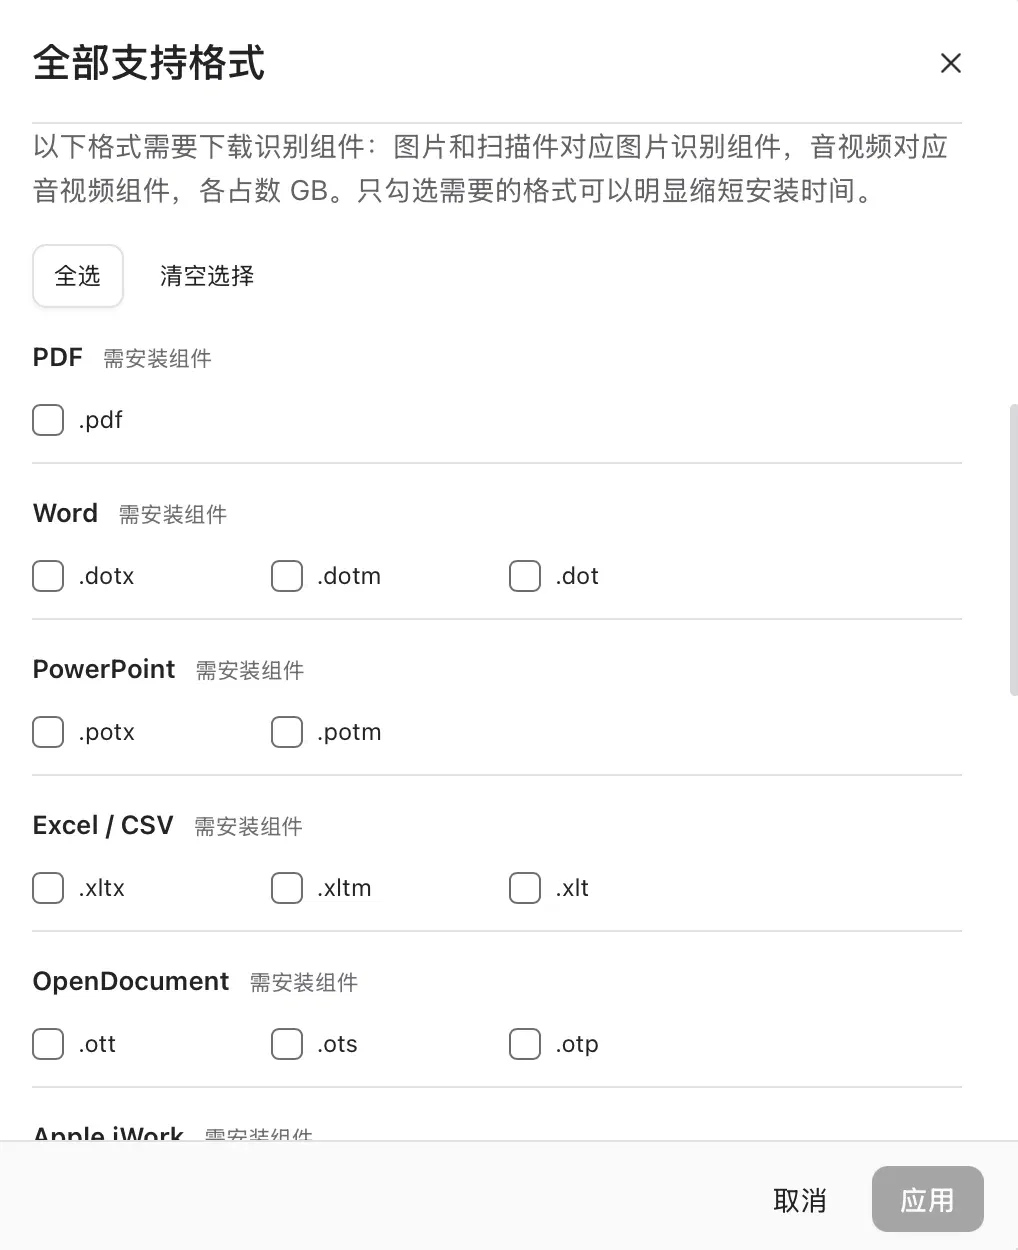
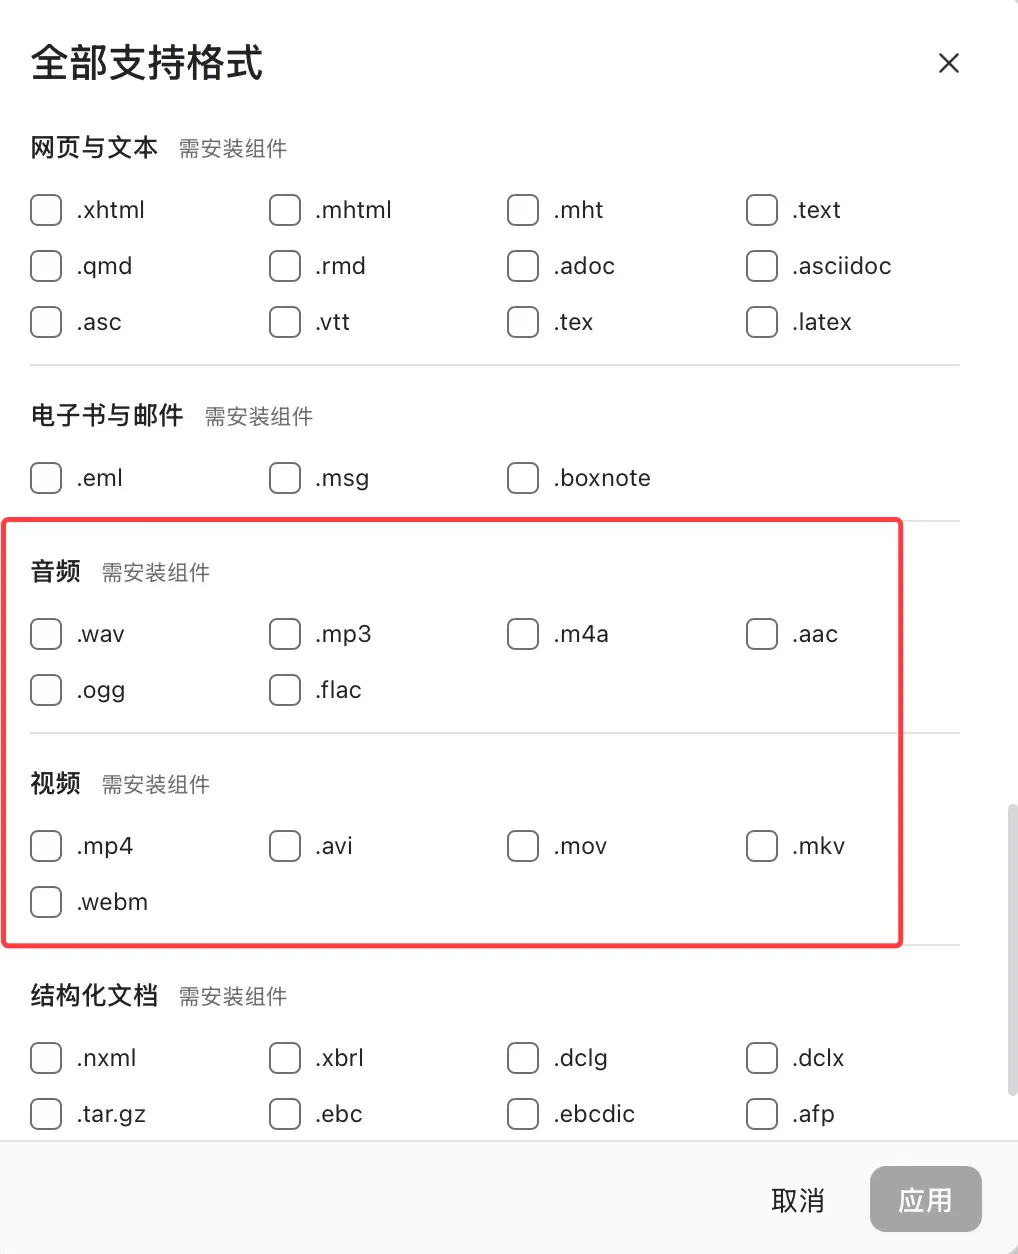
然后,即便你电脑上有无数种格式的文件,SAG Wiki都能索引,并识别到,甚至能识别音频、视频。
位置在:设置->文件设置->其他格式
一、检索我自己的文章
我把放着 383 篇历史公众号文章的文件夹扔进去实测:
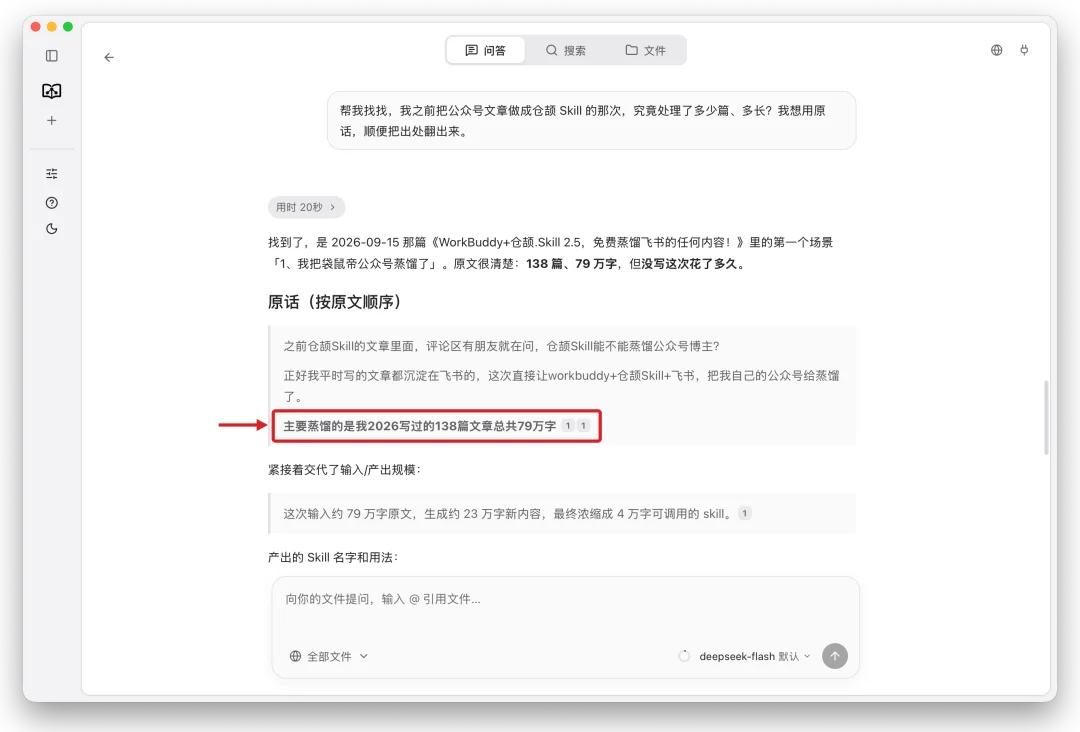
先问了一下「之前蒸馏公众号文章时,到底处理了多少篇、多少字?」
它搜了两次,翻出了对应的文章,直接给出准确数字:138 篇、79 万字!
说实话,我蒸馏的文章写了好多篇了。它居然能一次搞定,没有找错,确实有东西。
我又追问:
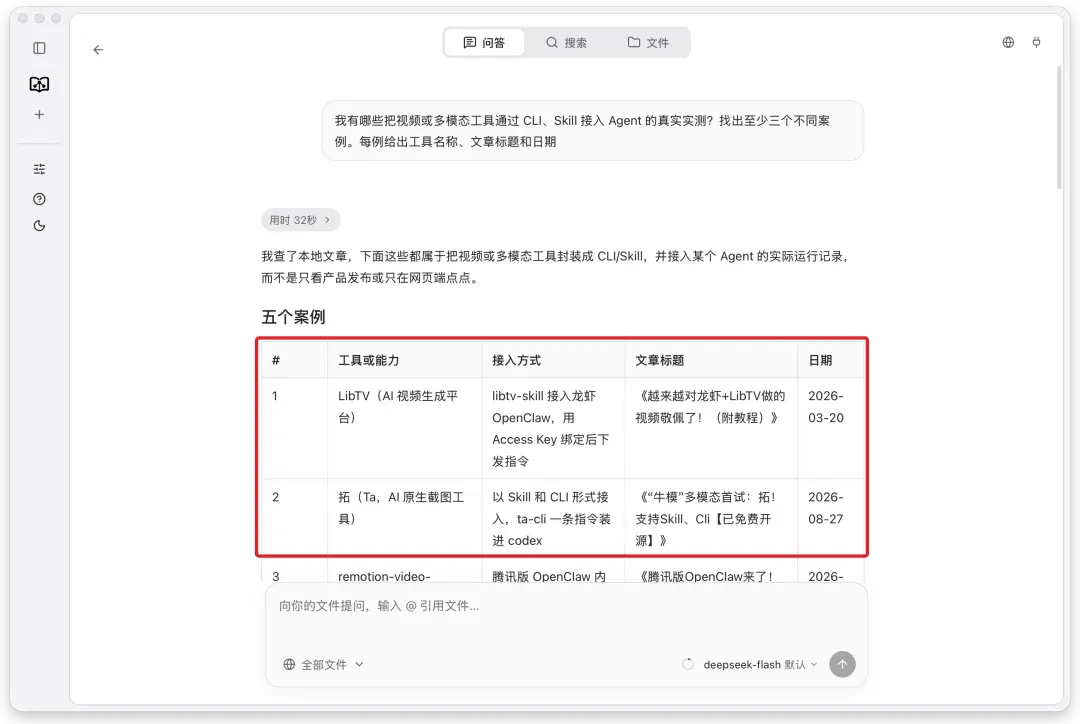
之前有哪些把视频或多模态工具通过 CLI、Skill 接进 Agent 的实测?
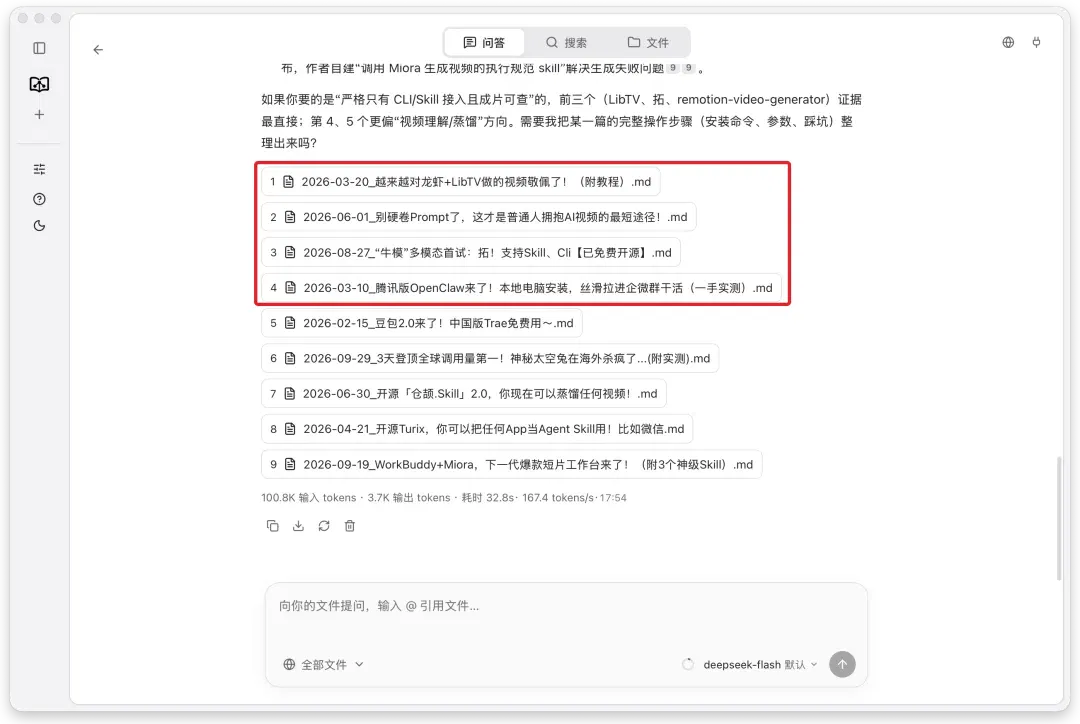
它直接把整个历史文章翻了个遍,从不同文章里挑出了 LibTV、拓、Remotion 等案例,把工具、接法、标题和日期整整齐齐排成了一张表,点引用就能直达原文。
这多跳检索,也完全不在话下,而且我检查了一下,真滴准。
2、借六度分隔玩个脑洞,李白和爱因斯坦怎么联系起来?
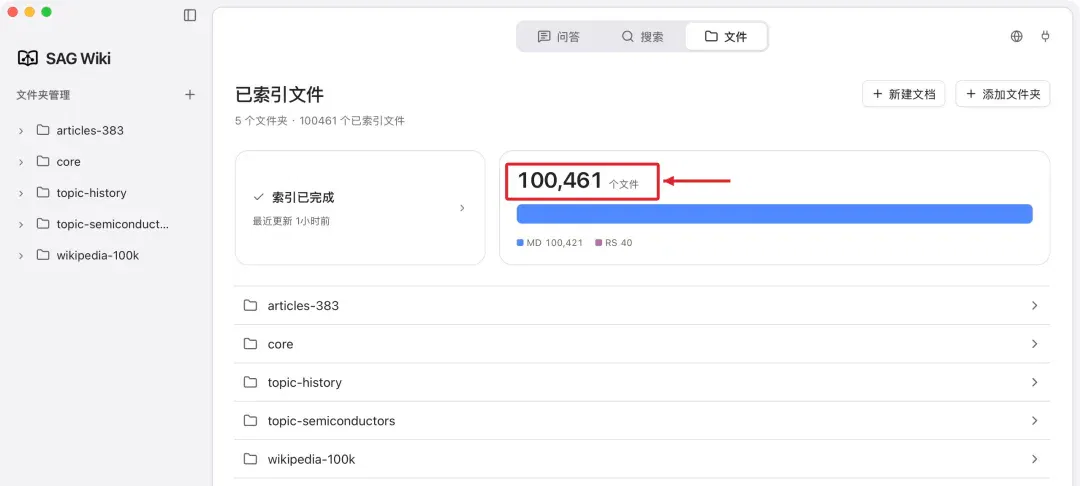
然后我在 SAG Wiki 里塞进了整整10 万篇维基词条,算上其他几个目录,整台电脑一共索引了 100,461 个文件,建库我不记得具体多久了,我只记得我上个厕所回来的时间就搞定了。
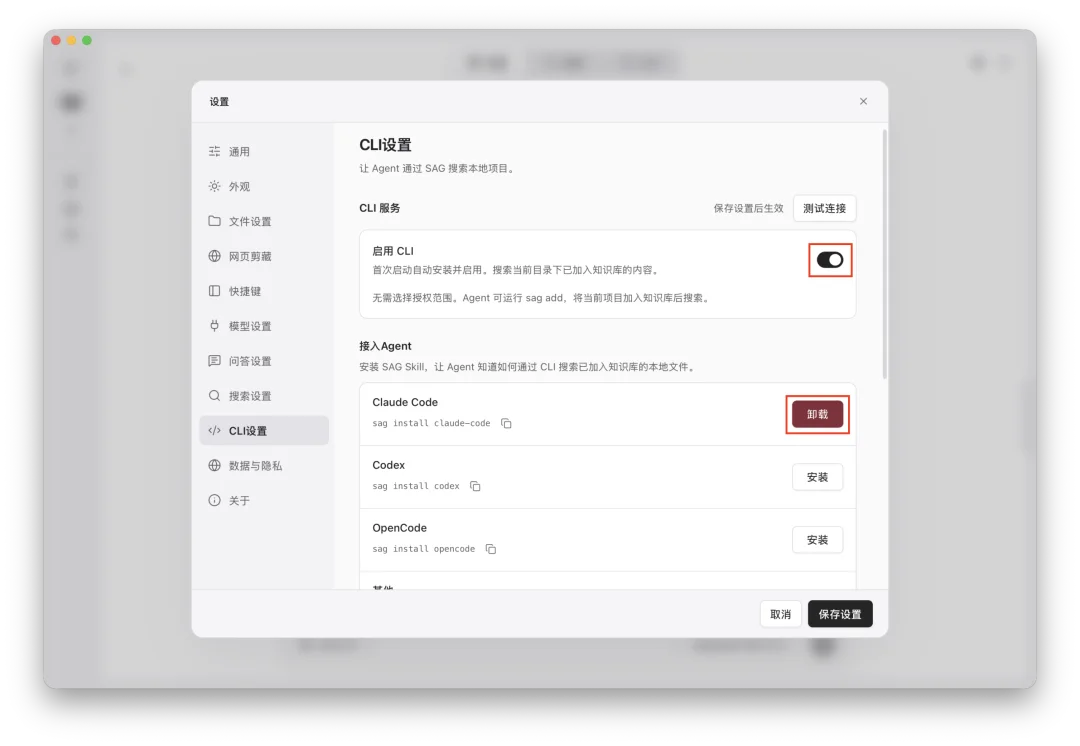
接下来这几题我们换到终端,在 Claude Code 里跑。
然后我们来做个对比:
「Claude Code + DeepSeek」 VS 「Claude Code + DeepSeek + SAG2」
两边都用 DeepSeek V4.1 Flash 查这份十万词条库,一边是接入了SAG2,一边是原生的模型。
如果只给「李白」和「爱因斯坦」两个八竿子打不着的名字,看能不能顺着线索在几步之内连起来?要求只有一条:每一步都必须有确凿出处,绝对不能瞎编。
PS:终端的图不太好截,截出来也很难看。我就让AI根据真实结果画图展示了。
最终两组给出的答案完全不同:
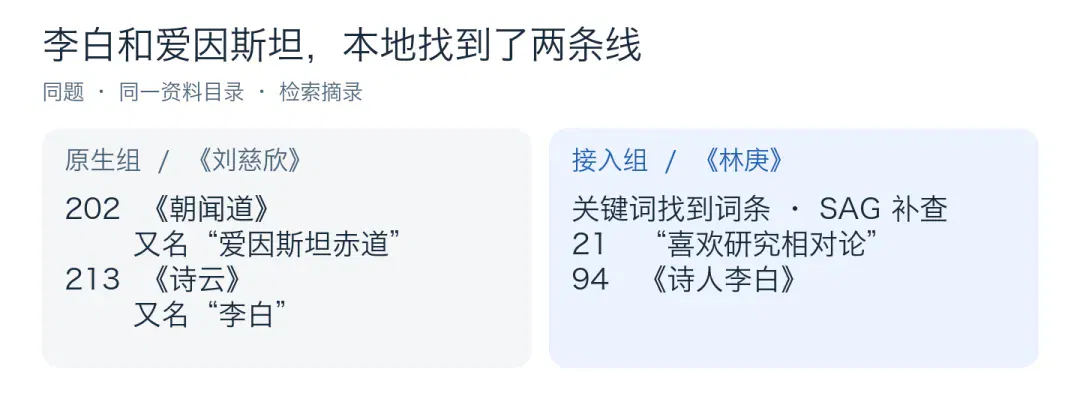
原生组翻出了刘慈欣的作品表——《朝闻道》(又名爱因斯坦赤道)和《诗云》(又名李白),在科幻作家的作品集里同框了;
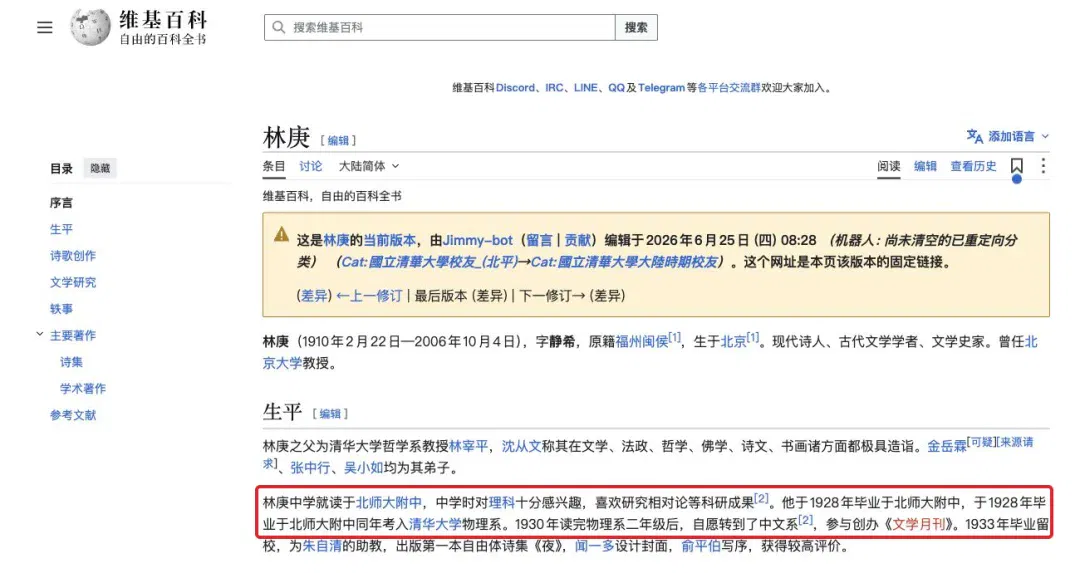
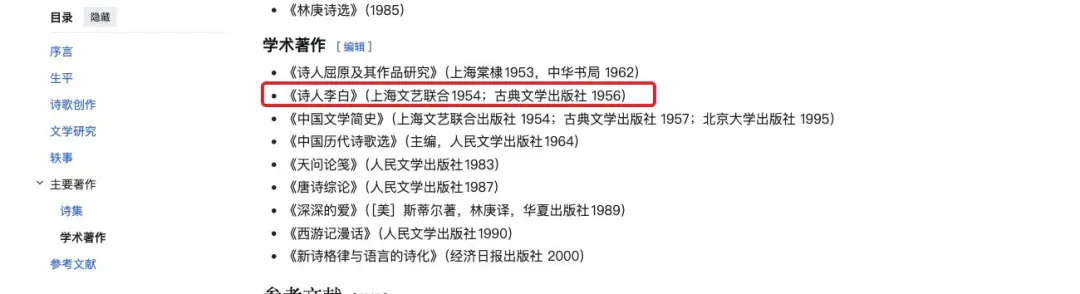
而接了 SAG2 的这边,先用关键词定位到学者林庚先生,再顺着 SAG 追查他的生平著作:他年轻时在清华物理系痴迷爱因斯坦相对论,后来成了写出《诗人李白》的文学巨擘!从相对论连到林庚,再连回李白,两头全有原文可查。
3、从几十万字研报,查芯片产业链。
测完脑洞,再来个更硬核的场景:啃几十万字的大部头专业研报。
平时研究算力硬件、折腾本地模型,经常免不了去翻半导体研报。但大家看英文研报深有体会:动辄一两百页全英文,全是专业缩写和各种黑话,想从里面挖一个关键细节简直头大。。
比如大家都知道英伟达 H100 芯片用的是 SK 海力士的 HBM3 显存,走的是 MR-MUF 封装工艺。但我如果想深挖到底:谁给 SK 海力士独家供应核心的底层填充胶水(Underfill)?
这种隐秘的供应链事实,往往既不在官方通稿里,科技新闻也不会细说,可能深深埋在深度研报的某个角落。我正好有 26 份半导体深度研报,刚好拿来做测试一下。
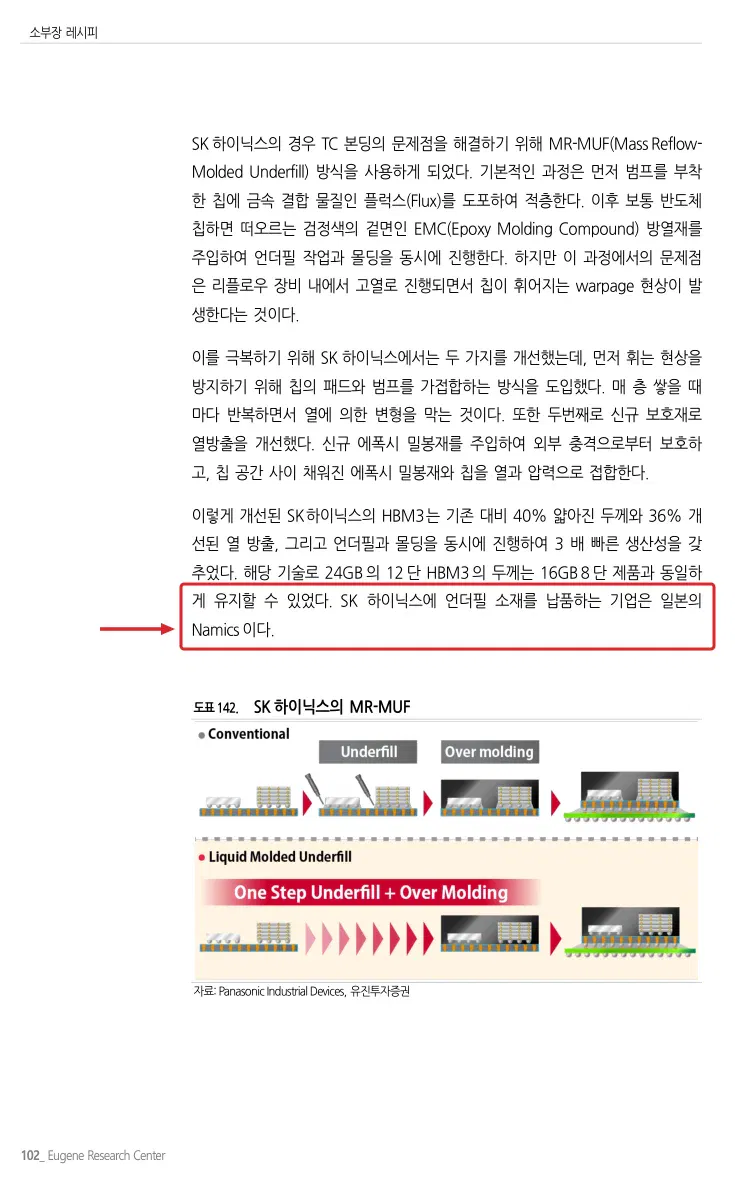
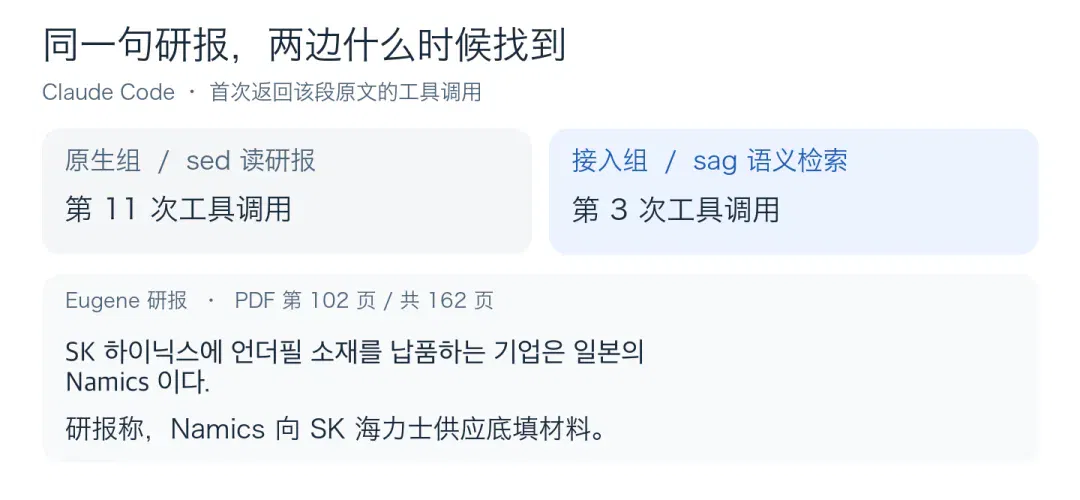
结果差距很大: 接了 SAG2 的这边仅调用了 3 次工具就找到了核心段落,一击命中 Namics 的供货原句;
而原生查找组在各个文档里像无头苍蝇一样乱翻,直到第 11 次工具调用才勉强蒙对!
4、代码排错,能不能直接定位?
最后给两组 Claude Code 都提供了 SAG Wiki v0.2.6 的同一份源码,查底层 Jev 遇到网络错误时的重试逻辑。
原生组抓出一堆文件,逐个打开看; 接了 SAG2 之后,提问直接扔过去,它直接带回了文件、行号和关键代码:明确命中 HTTP 499 状态码重试时不增加失败计数!
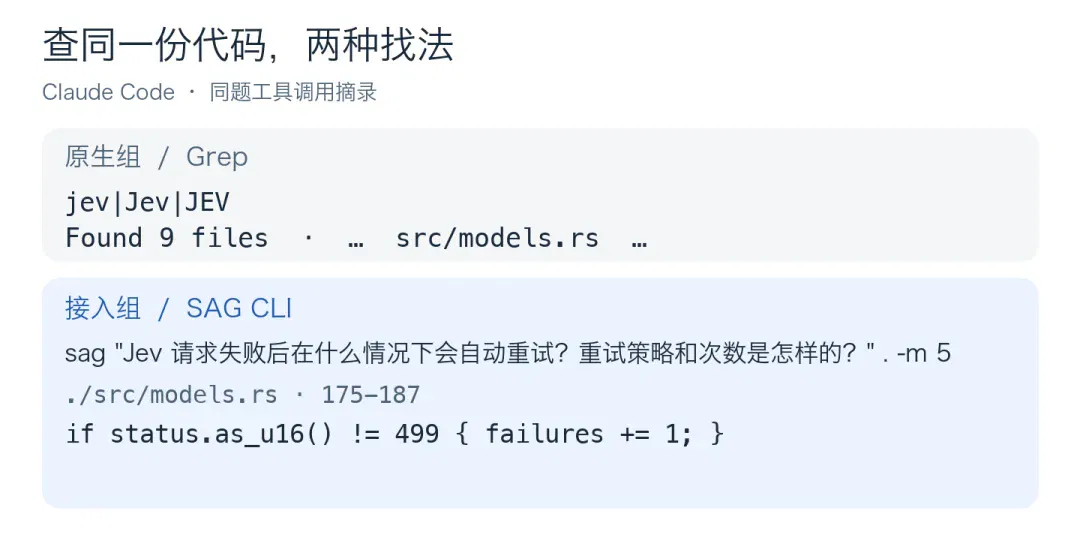
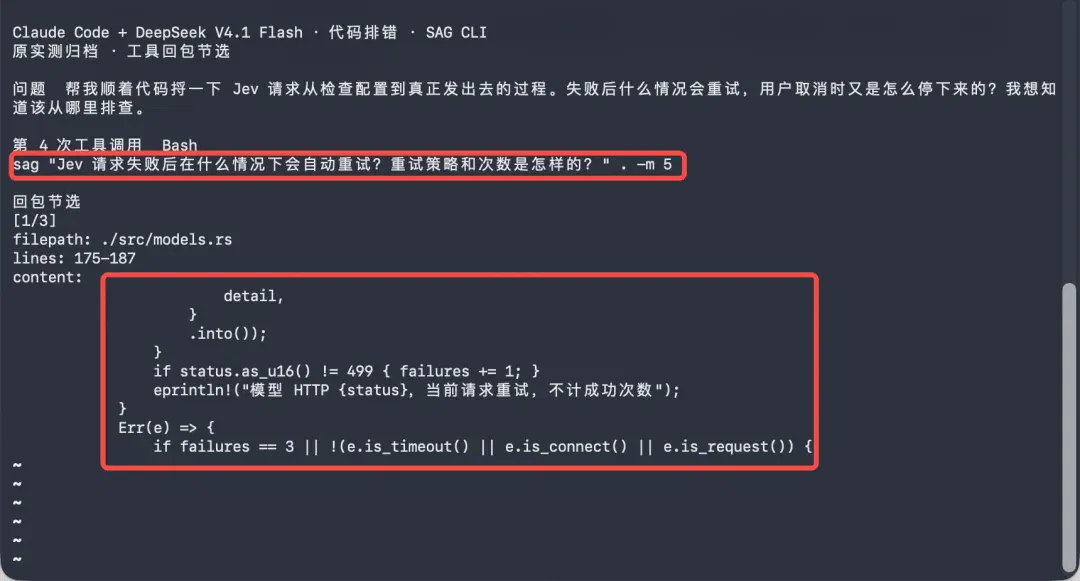
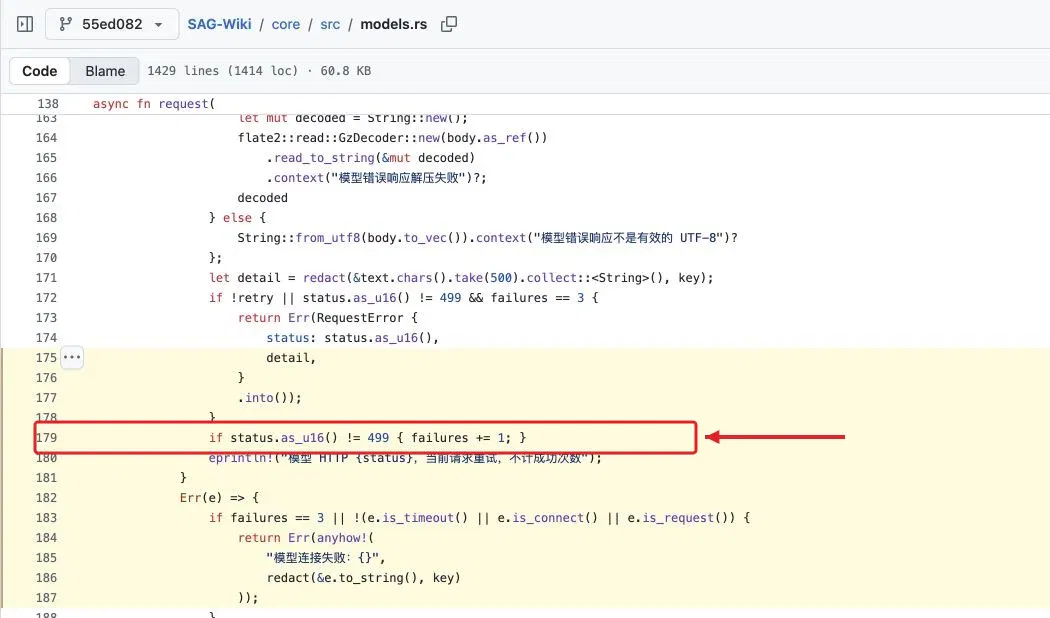
总耗时从原生组的 144 秒直接降到了95 秒。
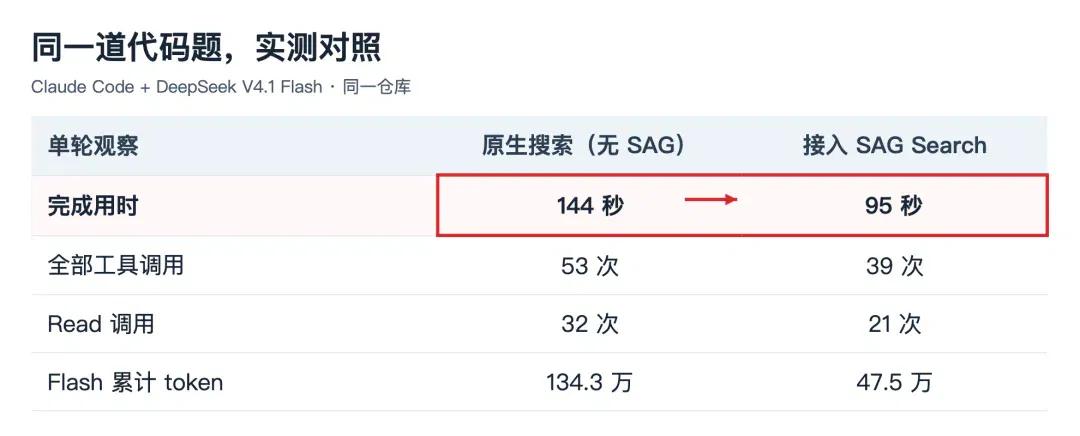
看来SAG2不仅适合超大规模的快速检索,甚至在数据量不是那么大的场景里,也比原生模型要强得多。
「最后」
这几年在 AI 领域摸爬滚打,我经常会有一种恍惚感。
大家好像都卷进了一种技术执念里:模型参数越来越大,向量数据库要搞集群。系统越做越庞大、越做越贵,门槛也越来越高。
但 SAG2 给我的感觉完全相反。它没去搞那些重型架构,也没扯那些虚头巴脑的概念,反而退回到了 Unix 最朴素的一句话:一切皆文件。
用了几十年的 BM25 倒排索引,用轻巧灵动的动态超边,把繁重的计算推迟到真正需要的那一刻。
用 10几MB 的体积、几秒钟的建库速度,把曾经无比困难的多跳推理能力,平权交到了每一个普通人手里(当然,这也得感谢Jev,新技术的突破往往能带动其他技术突破)。
而且,它真的打破了数据就得处理后存到库才能检索的传统。现在是你的数据根本不用动,它全自动😄
这让我想起老子在《道德经》里说的那句话:大道至简,少则得,多则惑。
SAG2 和 SAG Wiki 已经全部开源,有需要的朋友非常建议亲自去试一下。
另外,这么🐂🍺的先锋开源项目,怎么能忍得住不点个Star呢?
我是袋鼠帝,一个致力于帮你把AI变成生产力的博主。我们下期见~
能看到这里的都是凤毛麟角的存在!
文章来自于微信公众号 “袋鼠帝”,作者 “袋鼠帝”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
刚刚,10万人排队的ima copilot全面开放! (opens in a new tab)
灰度一个月,这个数字让我们有点坐不住——它说明大家对"让AI用我的知识替我干活"这件事,等不及了。好消息是,从今天起,所有人打开 ima,都可以直接使用copilot。同时,ima知识号也开始能发布 Skill 了,知识广场从“内容平台”延伸为“能力平台”。
卡帕西没做完的,开源社区48小时搞定了!完全体知识库,token省70倍 (opens in a new tab)
AI圈的节奏已经快到让人产生幻觉了。 Karpathy分享的个人知识库爆火出圈,48小时就有人拿着完全体送货上门。 Graphify,一款零配置、全模态、本地跑、还特能省token的知识图谱工具,GitHub开源狂揽2k+ Star。 不仅能自动构建可导航知识图谱、自带反向链接和关系溯源,更实现71.5倍token消耗节省,直接把卡神的/raw笔记法进化到了完全体。 万物皆可图谱化 卡神那套爆火的知识库,核心是一套不用复杂向量数据库的轻量化工作流。 靠raw/目录存论文、代码、截图等原始资料,再通过LLM自动生成带交叉引用的Wiki文档,配合定期体检维护,慢慢搭建起一个能持续生长、越用越好用的

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。