源策未来发布 Anchor 1,测试人形机器人全身控制精度
Anchor 1 用五个动作锚点和解耦误差反馈控制人形机器人。在团队的宇树 G1 全身操作测试中,手腕和脚踝的全局位置误差较最强对比方法分别降低约 28% 和 39%。
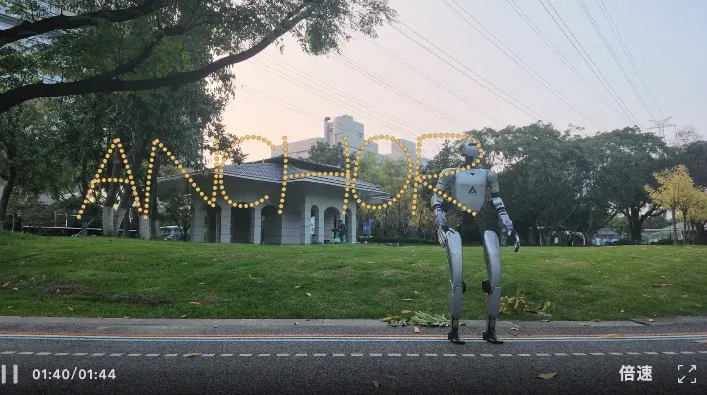
昨晚,具身智能算法创业公司源策未来(Archon Robotics)发布全身控制模型Anchor 1时,放出了一段并不炫技的真机视频:一台人形机器人抬起手臂,一笔一画地描出 ANCHOR 六个字母。直线、弧线、急转弯,轨迹一气呵成。
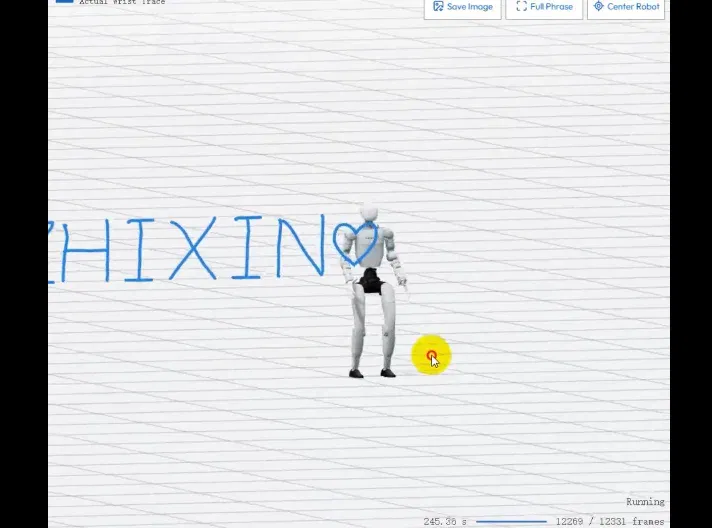
项目主页上还挂着一个可以上手玩的 demo:输入任意一行文字,仿真里的机器人就会把它写出来,提笔和空格处不留墨迹。我们也试玩了一下,输入了「JIQIZHIXIN」,机器人在仿真环境中完整手绘出了这些字符。
写字算不上高难动作,却是对「准」最直白的检验。手偏几厘米,字就歪了;身体晃一下,笔画就断了。对一台用两条腿站着的机器人来说,要让手稳稳走完每一笔,整个身体都得配合到位。
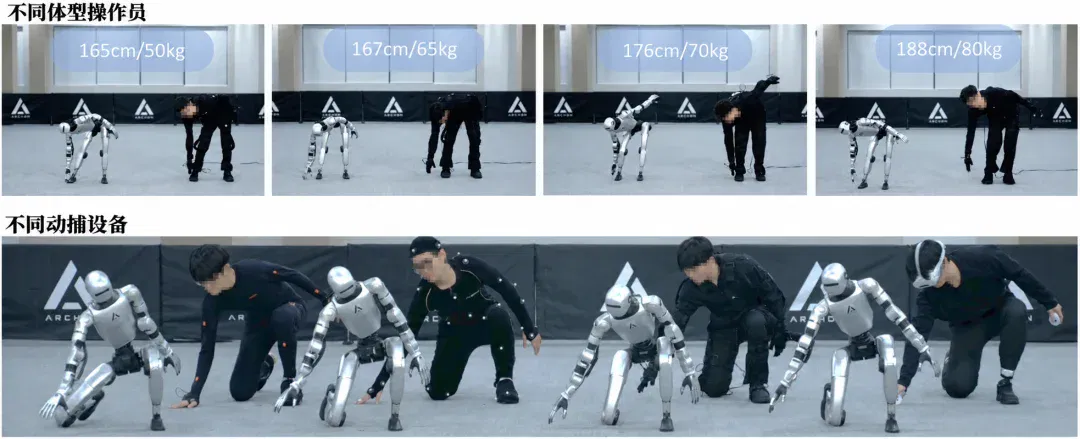
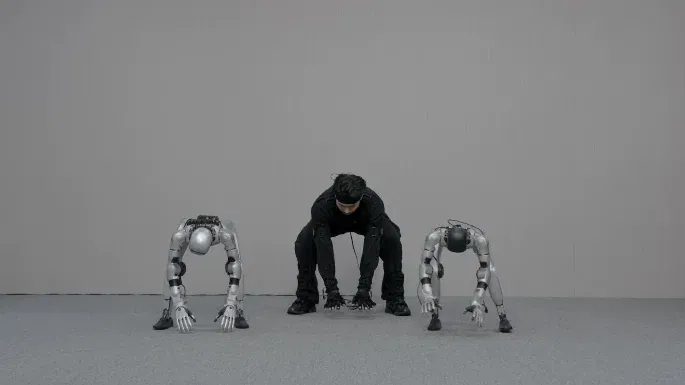
比写字更值得细看的是主页上的另一组视频。四名身高从 165 厘米到 188 厘米、体重从 50 公斤到 80 公斤不等的操作员,先后用动作捕捉设备驱动同一台机器人:弯腰触地、单膝跪地、侧身去摸脚踝、原地小步横移。人做什么,机器人就跟着做什么。
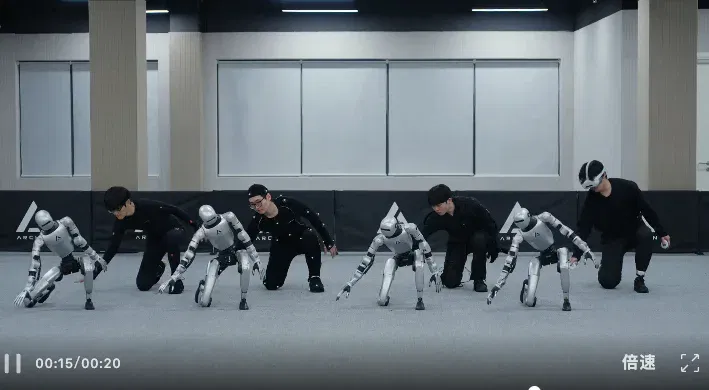
这正是今天人形机器人学习动作最直接的方式之一:人先做一遍,机器人跟着做。无论是遥操作采的示范数据,还是动作捕捉录下的人体数据,都要经过「跟着做」这一步,才能变成机器人身上的动作,再拿去训练上层的大模型。
问题在于「跟着做」这一步。人和机器人的身体比例不同、关节结构不同,人的动作必须先「翻译」成机器人能执行的动作,翻译稍有偏差,机器人的手就落不到位。人形机器人的手准不准,又牵动着腰、膝和脚,弯腰够地时多迈半步,手就跟着偏了出去。对全身操作而言,学得像其实并不难,难的是一直做得准。
源策未来给出了一组对比。操作员站着转动脚踝,一款主流开源全身控制模型驱动的机器人脚抬不起来;操作员弯腰去够地面,它开始摇晃失稳。控制器跟不准、站不稳,采回来的示范就带着偏差,上层模型学到的也是偏差。大脑的上限,被小脑的下限锁住了。
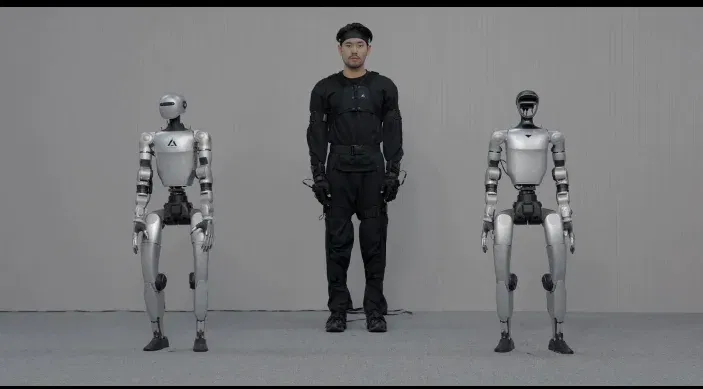
Anchor 1 要解决的正是这个「照着做」的环节。它被定位为源策全身智能架构中的 System 0(S0)层,也就是负责把指令精准、稳定地变成全身动作的「小脑」。毕竟,机器人要上岗,靠的不只是更聪明的大脑,还要有一个能把动作做准的小脑。
几组实验数据展示了 Anchor 1 在精度与稳定性上的提升:在 72 段全身操作动作的真机测试中,它的手腕和脚踝全局位置误差,比此前表现最好的对比方法分别低约28%和39%。用它做遥操作,踢纸箱任务的示范采集成功率从 37.5% 提升到98.0%,每小时采到的成功示范从 9 条增加到43条。
这个发布的行业背景也值得关注。从今年 1 月底 Figure 在 Helix 02 中加入 System 0;2 月,英伟达开源了全身控制基础模型 SONIC,用超过 1 亿帧人体动作捕捉数据训练,支持通过 PICO 头显进行全身遥操作;随后,Google DeepMind、智元相继推出全身控制相关模型,再到 10 月 arXiv 上集中涌现的一批全身控制论文,行业的目光正在从「大脑」移向「小脑」并从「表演」转向「部署」。
Anchor 1 发布之后,我们细读了这份 32 页的技术报告,试图回答三个问题:Anchor 1 是怎么做到「准」的?这份「准」是怎么被量出来的?它对上层的大模型又意味着什么?
- 论文标题:Anchor 1: Precise and Stable Humanoid Control for Whole-Body Manipulation
- 论文地址:https://arxiv.org/abs/2611.00193
- 项目地址:https://www.archon.tech/research/anchor1
Anchor 1
一个为精准与稳定的全身操作设计的「小脑」
要让「准」和「稳」同时成立,Anchor 1 的设计围绕三个问题展开:指令怎么给?多出来的自由度怎么用?执行中的偏差怎么纠正?
三个问题的答案,分别是五个锚点、经过严格筛选的训练数据以及与动作编码解耦的误差反馈。
聚焦五个锚点:让全身控制更精准
教人搬一张沙发,没有人会规定「左膝弯 63 度、腰前倾 20 度」,只会说「左手托这儿、右手扶那儿、脚站稳」。剩下的事,身体自己会找到最顺手的姿势。Anchor 1 给控制器下指令也是这个思路。
它发出的指令只包含五个部位:骨盆、左右手腕、左右脚踝,每个部位给出目标位置和朝向。
这五个部位恰好决定了操作和支撑:手腕决定能不能够到、拿稳,脚踝决定站得稳不稳,骨盆决定身体整体往哪去。其余关节一概不指定。
少了这些约束,控制器反而多出了调整空间,可以通过弯腰、屈膝、转体,把手脚更精确地送到目标位置。这类稀疏指令的思路此前已有研究探索,比如英伟达的 MaskedMimic 和 HOVER 等工作尝试过只给出部分关键部位的目标,由控制器补全全身动作。Anchor 1 的不同之处在于如何把人的动作「翻译」成这五个锚点。
行业里常见的做法是在线重定向:操作员每动一下,系统就实时求解一遍机器人的关节角,再把结果交给控制器。这有点像同声传译,译得快,但一旦译错,机器人的动作就会突然走样。
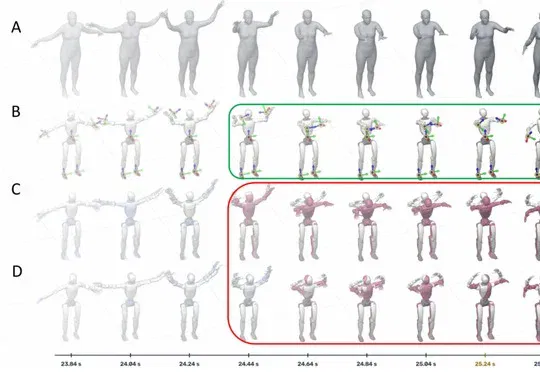
论文用同一段 PICO 录制的人体动作做了对照:依赖在线重定向的配置在手臂伸展时偏离了原本的动作,还出现了指令突变,这既会打断任务,也会给关节带来不必要的冲击。
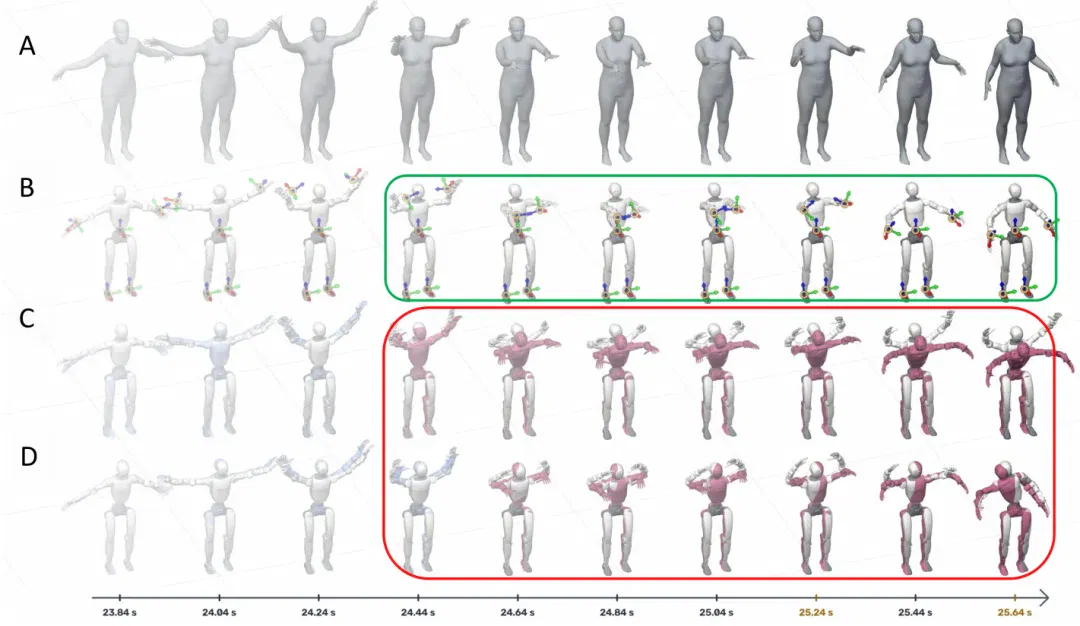
同一段人体动作,三种控制方式的执行效果。四行使用的是同一段由 PICO 录制的人体动作,时间从左到右推进。(A) 人体参考动作;(B) Anchor 1,直接以五个锚点作为输入,不经过重定向;(C)(D) 一款主流开源全身控制模型,分别搭配基于逆运动学的重定向工具和基于学习的重定向工具,先把人体动作转换为机器人动作再执行。手臂伸展时,依赖重定向的两种配置都出现了动作偏离和突变(红框),Anchor 1 则稳定还原了原始动作(绿框)。
另一条路线是绕开重定向,直接把人体动作编码给控制器,但如果采用通用的参数化人体模型、忽略操作员自身的身体比例,手部轨迹同样会被扭曲。
Anchor 1 走的是第三条路,做法更接近裁缝打版:系统先用操作员和机器人各自的 T 字站姿做一次标定,算出每一段肢体的缩放比例、旋转对齐和位置偏移,之后逐帧套用这组固定参数,把人体动作换算到机器人的尺度上,全程不求解关节角。
源策未来用一段半径 16 厘米的画圆动作检验了这种换算的保真度:与参数化人体模型的输入相比,Anchor 1 的手腕轨迹在运动方向上的偏差指标低80.2%,画出来的圆更接近人手原本的样子。
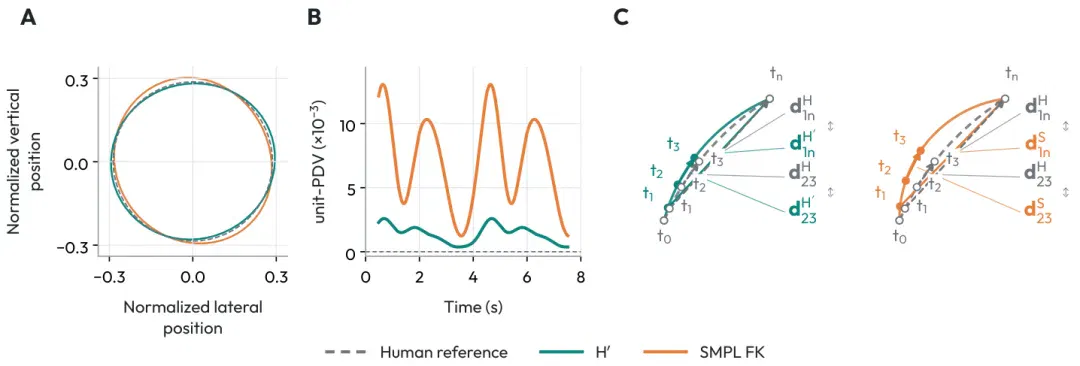
画圆动作中的手腕轨迹保真度对比
省掉在线重定向也带来了部署上的便利。论文展示了 Xsens 惯性动捕、CHINGMU 光学动捕、诺亦腾 PN-LINK 有线惯性动捕和 PICO VR 四种输入设备,虽然它们的骨架表示和数据质量各不相同,但都能直接换算成五个锚点交给控制器。身高从 165 厘米到 188 厘米、体重从 50 公斤到 80 公斤的操作员,也都能直接上手。同时,Anchor 1 只需要 60 毫秒的未来指令,而参与对比的各方案需要 80 毫秒到接近 1 秒。
自由度怎么用,由数据说了算
五个锚点解决了「指令怎么给」的问题,而只给五个锚点,意味着同一组指令可以对应很多种全身姿态。同样是把手伸到低处,可以弯腰、可以下蹲、可以单膝跪地,也可以用一种别扭的姿势硬够过去,脚下还可能悄悄滑动。多出来的自由度是一把双刃剑:用好了让手更准,用不好就会让身体不稳。
Anchor 1 的解法是在训练数据上下功夫,就像师傅带徒弟,只示范稳当的做法。
团队为每一段人体动作配上一段离线重定向得到的机器人动作:训练时,五个锚点作为输入,配对的机器人动作则用来提供监督和奖励,告诉模型「这种情况下,身体应该这样配合」。这些配对数据都要经过自动质检,筛掉长时间悬空、关节突变、自碰撞、周期性抖动和穿透地面的片段;自采数据还要再经过一轮人工复核,对照原始人体动画检查动作质量和对应关系。
最终的训练集包含406,222 段动作、约 1081 小时,其中 77% 来自源策自采的动作捕捉数据,其余来自 AMASS、OMOMO 等公开数据集。论文直言,这种筛选是在刻意引入一种偏向,让模型在补全全身动作时倾向于稳定、物理上合理的姿态。
这里有一个巧妙的分工。重定向被从部署时的实时环节,挪到了训练前的离线环节。离线做重定向,有时间检查、有机会剔除坏样本;部署时直接用五个锚点,不再受重定向出错的影响,也省去了相应的计算开销和延迟。人体动作负责告诉机器人「做什么」,经过筛选的机器人动作负责教会它「怎么做才稳」。
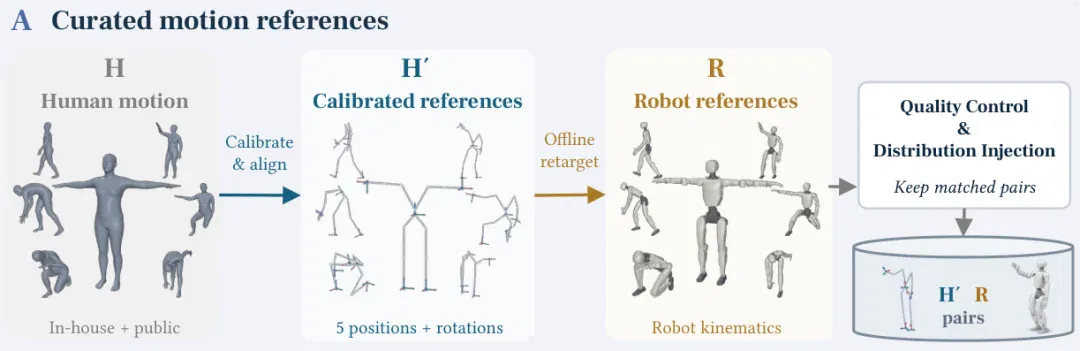
人体与机器人配对数据的构建与筛选流程
纠偏单独走一条路
指令给准了,执行中照样会出偏差。机器人在弯腰、迈步时,手脚总会偏离目标一点点,控制器需要随时知道偏了多少,才能及时拉回来。
现有方案获取这个纠偏信号的方式大致有两种:
- 把目标动作压缩成 motion token,连同机器人自身状态一起交给策略,偏差多少由策略自己去推断。token 紧凑、结构化,方便上层模型学习,但压缩会丢掉细节,小的残余误差很难被察觉和纠正。
- 直接把「目标和当前状态的差值」算出来喂给策略,纠偏信号最直接,可一旦把这个差值也编码进 token,同一个动作在不同执行状态下就会得到不同的 token,上层模型学起来会无所适从。
我们可以用开车导航类比:「目的地」和「你现在偏离路线多远」是不同的。如果每次偏航都去改目的地,导航就乱了套;合理的做法是目的地不动,偏航提醒单独给出。Anchor 1 采用的正是这种思路:在编码器、量化器、解码器的架构中,手腕和脚踝的跟踪误差不进入编码器,而是绕过 token,直接送进负责输出关节动作的解码器。token 只描述「要做什么」,误差只负责「拉回来」。
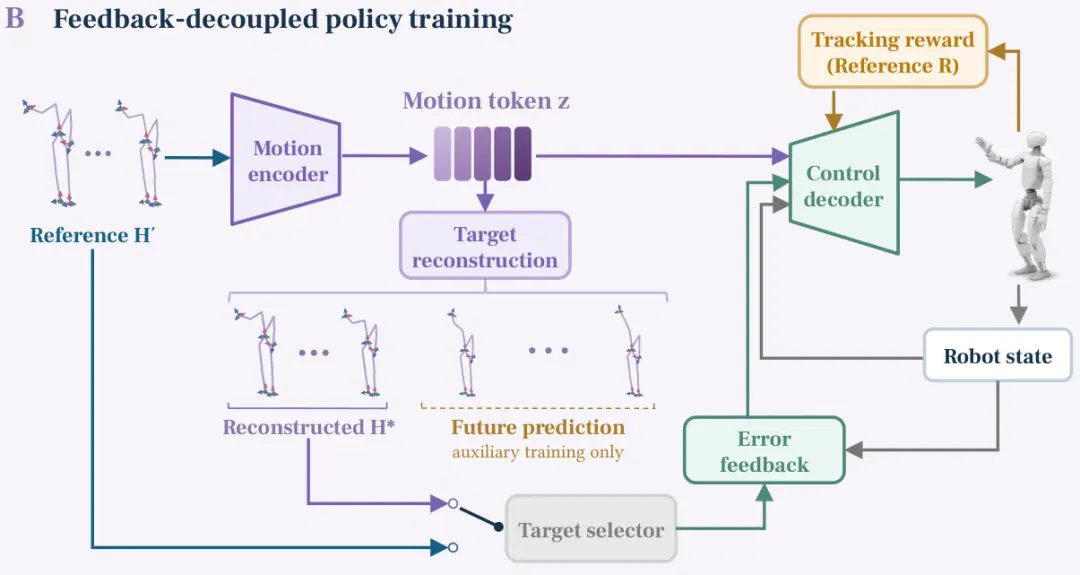
Anchor 1 的控制器结构:跟踪误差绕过编码器,与 motion token 一起送入解码器
当上层模型直接下发 token、没有附带五个锚点的位姿时,纠偏的参照从哪来?
Anchor 1 额外训练了一个轨迹头,能从 token 里重建出近期的目标位姿,再用它计算跟踪误差。这样,同一个控制器就有了两种指挥方式:遥操作和上层策略可以下发五个锚点,上层策略也可以直接输出 token。
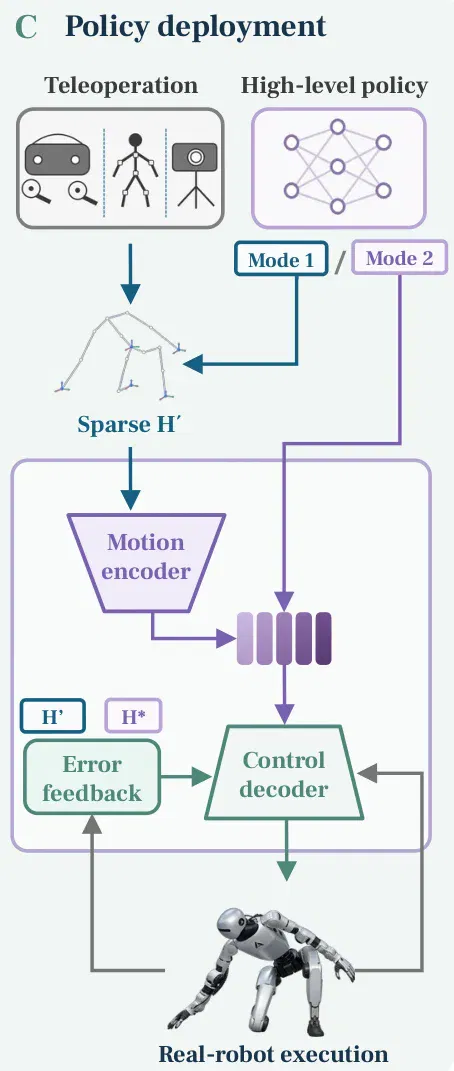
两种指挥方式:遥操作和上层策略可以下发五个锚点,上层策略也可以直接输出 motion token
消融实验展现了这一设计的价值。在 MuJoCo 仿真的 In-house 评测上,去掉显式误差反馈后,全局和局部成功率分别只有 70.9% 和 61.7%;把误差送进解码器后,两者分别升至 88.7% 和 88.4%。在 token 插值实验中,解耦的版本也能更顺滑地完成从蹲姿到站姿的过渡,耦合的版本则卡在了更深的屈膝姿态里。
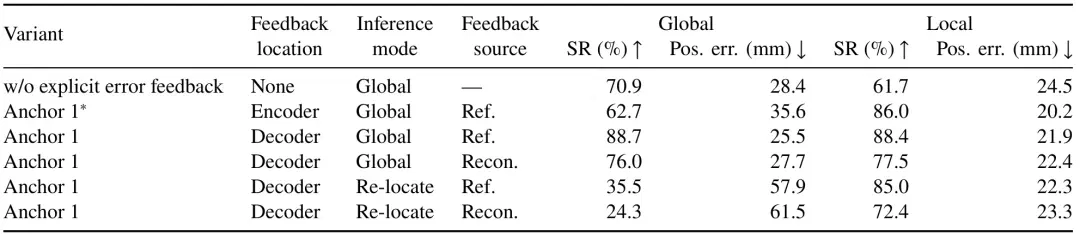
消融实验:误差反馈送入的位置、推理模式和纠偏目标的来源,对成功率与跟踪误差的影响
从重建目标计算误差也有代价,精度会略有下降,在仿真中局部位置误差从 21.9 毫米升到 22.4 毫米。因此论文建议,在对精度要求最高的遥操作采集场景中,优先使用直接下发的五个锚点。
一把更严的尺子
接下来是第二个问题:这份「准」是怎么被量出来的?
源策的回答是另起一套评测体系。在他们看来,现有的评测方式在衡量「准」这件事上各有盲区:任务级评测的成功率混杂了感知和规划的因素,说不清是哪一层出了问题;按整段动作取平均的跟踪误差,又会掩盖短暂但致命的偏差。
这有点像考驾照。科目二不看考生全程的平均车速,压一次线就不合格。源策搭建了一套包含 In-house、Public 和 Reachability 三条 Track 的评测体系,分别考察全身操作协调、动态动作跟踪以及不同姿态下的手部可达性与足部稳定性。其中,在 In-house 和 Public 两条 Track 上,一段动作只有在全程中手腕和脚踝的位置误差都不超过 10 厘米、朝向误差不超过 1 弧度、其余身体部位误差不超过 25 厘米时,才算成功。
三条 Track 的具体评测内容如下:
- In-house Track包含 15,342 段动作、覆盖 3,247 种任务,团队把躯干与手臂动作、下肢支撑与移动方式分别描述,再组合成动作捕捉指令,专门考察单手和双手够取、手脚协同、移动中稳住手部等操作相关的全身协调。
- Public Track从四个公开数据集中选出 2,230 段动作,补充了跑、跳等更动态的行为。
- Reachability Track给定空间中的手腕目标点,在站立、浅蹲、深蹲、前后错步和半跪五种姿态下,要求机器人把手送到位、保持住、再收回,全程不能打滑、不能多迈步,共 3,210 段参考动作。
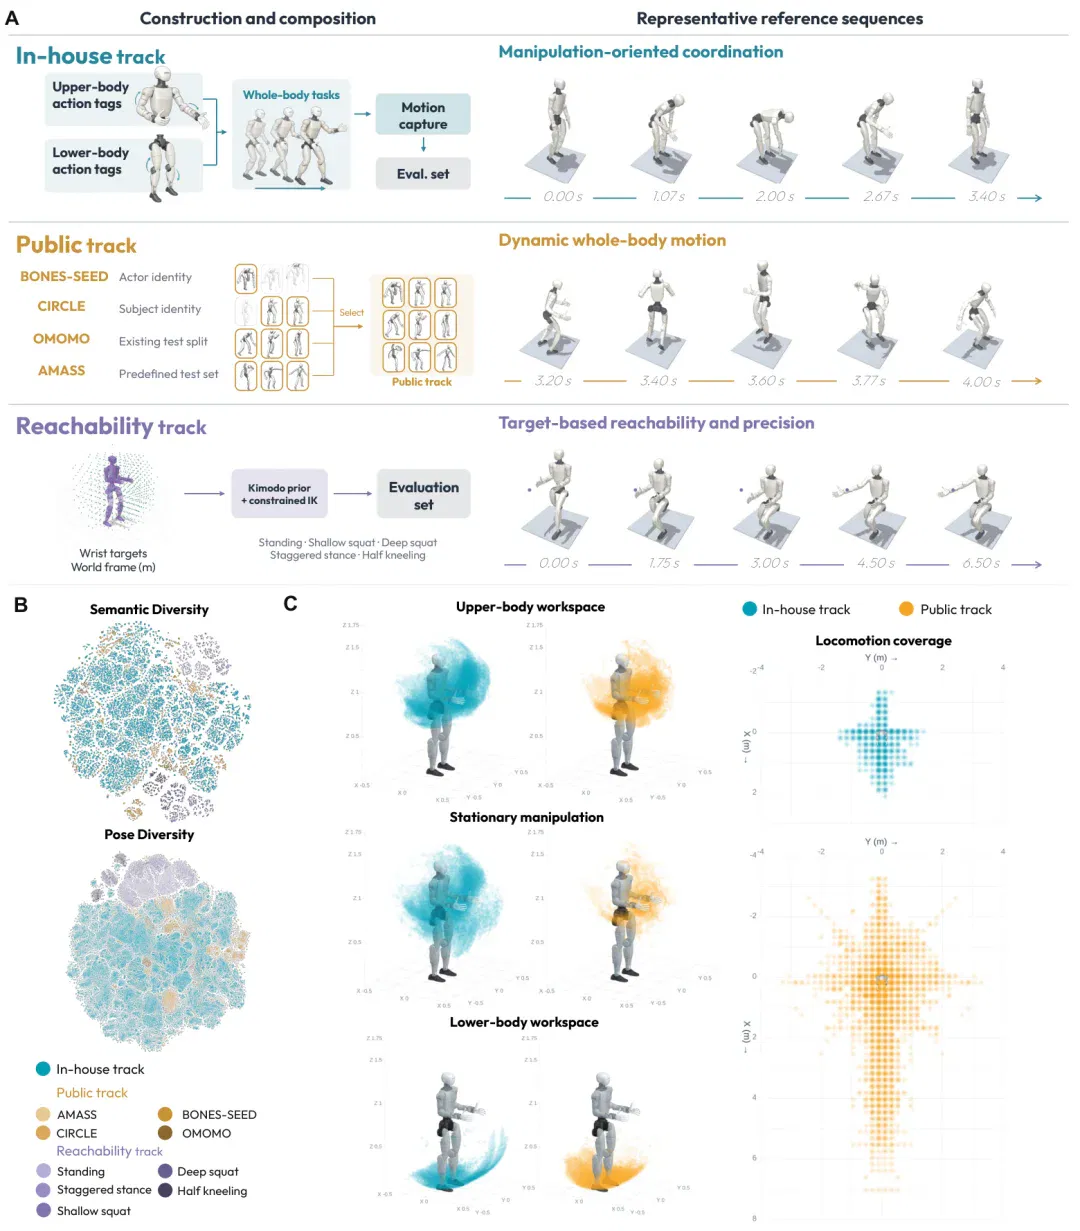
源策未来所构建评测的三条 Track 的构建方式与动作覆盖
三条 Track 的所有评测动作都不参与训练。
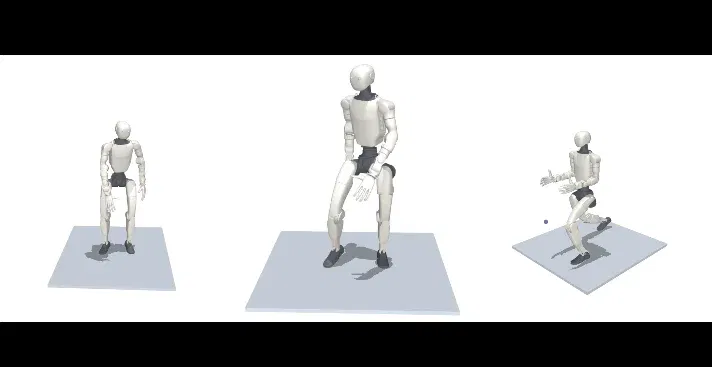
三条 Track 各一个动作示例,从左至右依次为前进弯腰拾取组合动作(In-House)、舞蹈动作(Public)、右侧单膝下跪(Reachability)
在仿真中,Anchor 1 在 In-house Track 上取得了最高的全局和局部成功率,分别为 88.7% 和 88.4%,水平方向的根部位置误差也最低。边走边做非对称双手够取这类动作最能拉开差距:Anchor 1 的局部成功率为 91.2%,这一场景下表现次佳的方法仅有 57.0%。
在更偏动态动作的 Public Track 上,各方法的绝对成功率都明显下降,Anchor 1 仍保持最高;论文也提示,参与对比的方法在训练时可能接触过部分公开数据。
在 Reachability Track 上,Anchor 1 在多数姿态组取得最高成功率,平均每段动作仅有 0.06 次打滑和 0.53 次多余迈步。
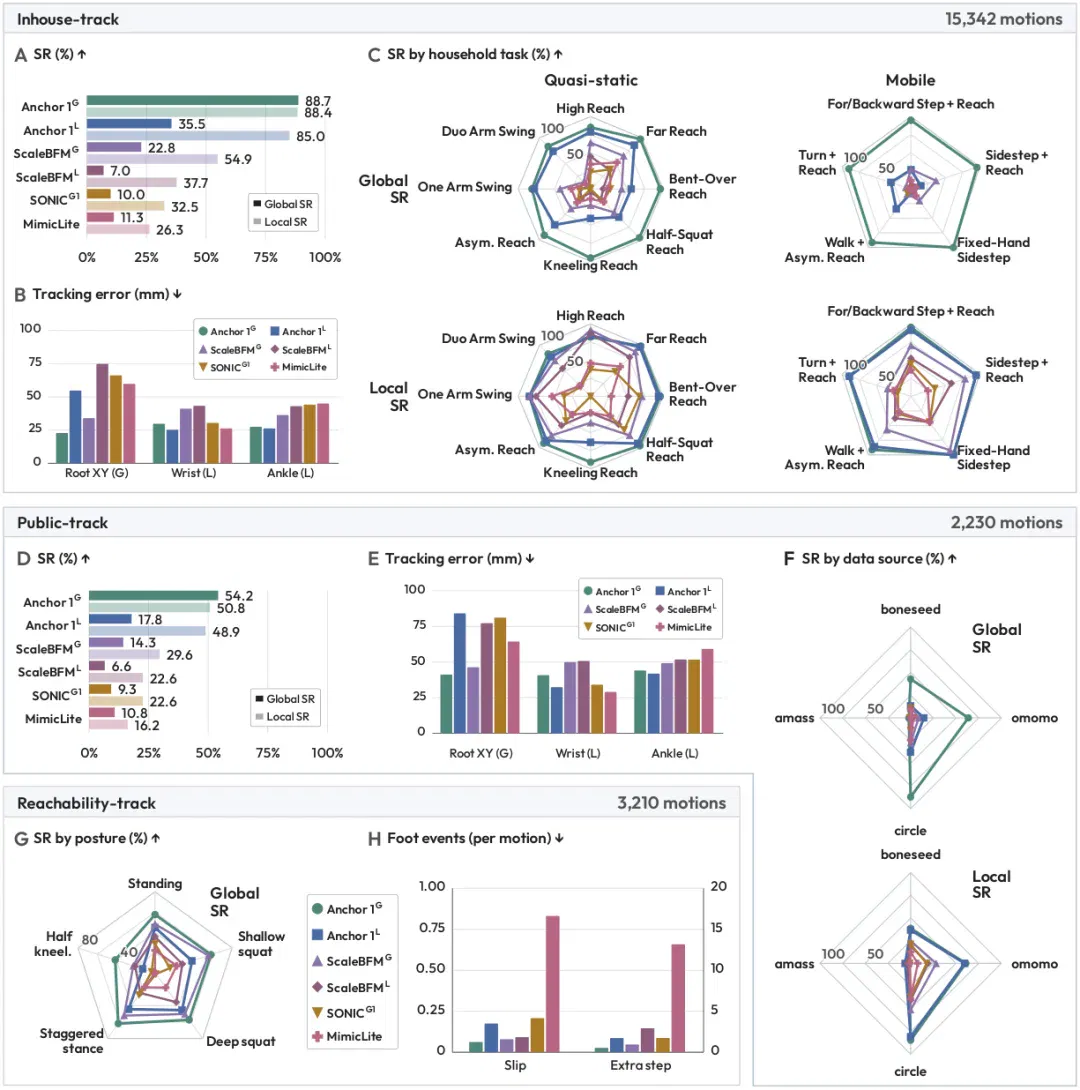
三条 Track 上的成功率、跟踪误差与足部事件对比
真机测试:标准越严,差距越大
仿真之外,团队在宇树 G1 人形机器人上做了两组真机测试:一组是 51 段站立够取动作,考察手腕定点的精度;另一组是按动作标签挑出的 72 段全身操作动作,覆盖够取、移动、平衡扰动、手脚协同等七类任务。
在站立够取(standing-reach)测试中,Anchor 1 的手腕和脚踝全局位置误差分别为 44.58 毫米和 35.70 毫米,此前表现最好的对比方法分别为 53.59 毫米和 50.40 毫米。
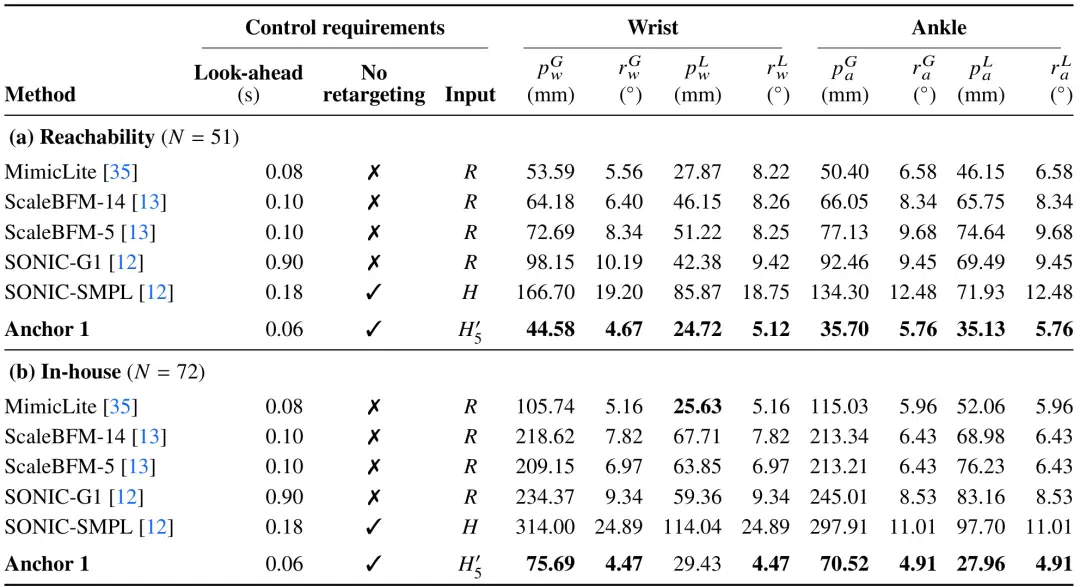
In-house 与 Reachability Track 子集中的真实世界跟踪误差和参考要求
值得注意的是,这个结果是在更短的未来指令(0.06 秒对 0.08 秒)、且无需在线重定向的条件下取得的。与另一种同样免重定向、直接接收人体动作的方案相比,Anchor 1 的手腕和脚踝全局误差分别降低 73.3% 和 73.4%,所需的未来指令只有对方的三分之一。
在 72 段全身操作动作上,团队把手腕和脚踝的误差阈值从 10 厘米逐级放宽到 25 厘米,其余标准保持不变。Anchor 1 在全部六档阈值下都保持最高的总体成功率,在最严的 10 厘米一档领先最强对比方法 41.2 个百分点。
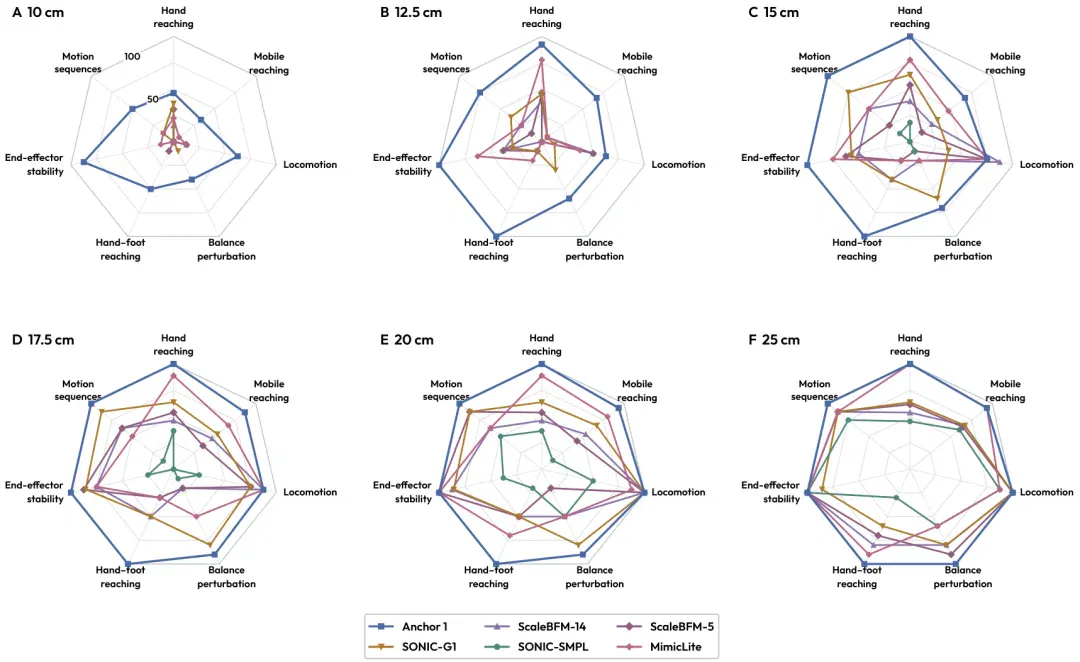
真机全身操作测试中不同误差阈值下的分类成功率
误差层面,正如上表所示,Anchor 1 在 8 项指标中有 7 项最低:手腕和脚踝的全局位置误差分别为 75.69 毫米和 70.52 毫米,比此前表现最好的对比方法低约 28% 和 39%,局部脚踝位置误差则低 46.3%;唯一的例外是局部手腕位置误差,有一种对比方法略低于它。
这组结果也解释了源策为什么要坚持一把更严的尺子:阈值放宽,各方法的分类成功率逐渐靠拢;阈值收紧,差距才显现出来。论文在讨论部分专门指出,宽松的成功标准会掩盖控制器之间的真实差异。对全身操作来说,「能不能做到」和「能不能一直做准」,是两道不同的题。
小脑够准,大脑才好发力
最后是第三个问题:这份「准」对上层的大模型意味着什么?精准的价值,最终要在两个地方兑现:遥操作采数据和上层模型自主干活。
遥操作中,控制器跟不准,操作员就得反复做补偿动作,采集效率、成功率和示范质量都会受影响。正如文章开头视频展示的那样,在小幅侧移、转动脚踝、弯腰触地、侧身摸脚踝等动作上,一款主流开源全身控制模型要么复现不出细微变化,要么脚抬不起来,要么开始摇晃失稳,Anchor 1 则能贴合操作员的动作。
量化测试选了两个任务:把纸箱踢进指定区域以及从低处鞋架上取出拖鞋放到指定位置,分别考验脚的落点和低位抓取。
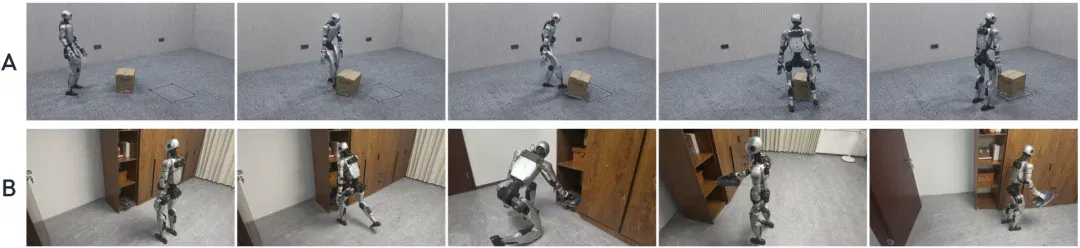
VLA 驱动下的踢纸箱与捡拖鞋自主执行过程
使用 Anchor 1 时,踢纸箱每小时可采集 43 条成功示范,采集成功率98.03%;捡拖鞋为每小时 62 条、成功率97.37%。同样的任务换成上述开源模型,对应数字分别为 9 条和 37.50%、41 条和 68.33%。
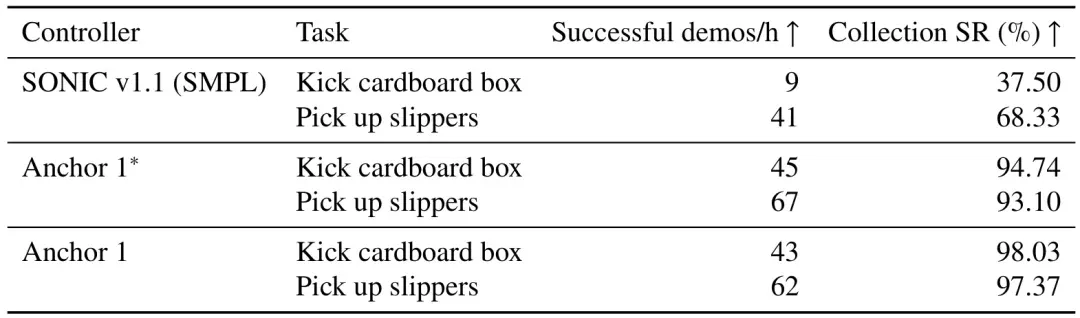
遥操作数据收集效率
自主执行方面,团队用遥操作采集的示范数据微调了一个开源 VLA 模型GR00T N1.7,让它根据语言指令、三路 RGB 画面和本体状态,输出五个锚点的目标位姿或 motion token,连同手部指令一起交给冻结的 Anchor 1 执行。
在 20 次试验中,以 motion token 作为接口、配合重建目标纠偏的 Anchor 1,踢纸箱成功率达到 90%,捡拖鞋为 45%;作为对比,同样以 token 为接口的开源模型分别为 70% 和 10%。另一个结果同样说明问题:把误差编码进 token 的耦合版本,一旦改用 token 指挥,两项任务全部失败。纠偏和指令分开,token 接口才真正可用。
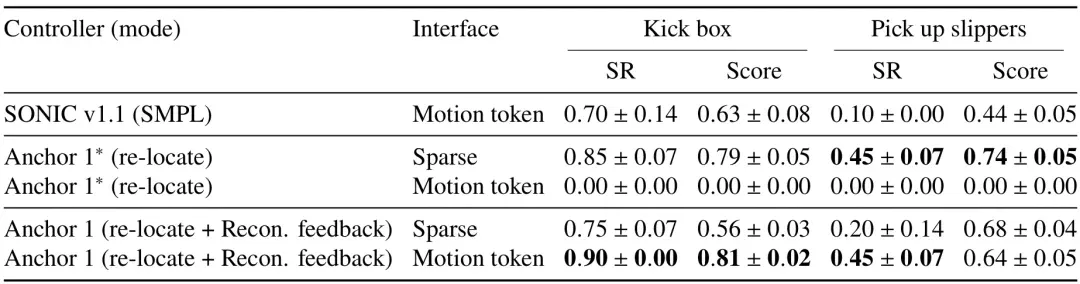
捡拖鞋 45% 的成功率也提醒我们,自主全身操作远未到可以交卷的程度。但这组对比清楚地展示了一条链路:小脑的精度,会一路传导到数据质量,再传导到大脑的任务成功率。
把「准」变成行业的公共能力
论文也坦率列出了局限。目前的评估只在一种人形机器人上完成,没有不同本体上不同方法的严格对比;五个锚点只描述身体该到哪里,不描述物体的几何形状、接触力和抓握稳定性,所以动作跟得准,并不等于一定能把东西拿稳;从 token 重建目标带来的精度损失也还需要继续缩小。
团队给出的下一步方向是引入相对于物体的目标和接触感知,把全身控制更直接地连接到物体交互上。在源策未来设想的全身智能架构里,S0 是让机器人「站得稳、做得准」的底座,上面还有负责感知与决策的 S1。
源策未来计划在 2026 年底分阶段开放 Anchor 1 的模型权重和部署代码,以及基于 PICO 及 PN-LINK 的遥操作和示范数据采集链路,并配套部署镜像、使用教程和示例动作。评测侧将逐步开放相关评估工具,持续维护全身操作评测榜单,并计划在 2027 年年中举办一场国际竞赛。
回到开头那段写字的视频。一台人形机器人一笔一画写出 ANCHOR,远不如空翻、打拳热闹,却指向了行业接下来真正要比拼的东西:从「表演」走向「部署」比的是机器人能不能在弯腰、迈步、换姿态的过程中,始终把手稳定且精准地送到该去的地方。Anchor 1 给出的是一个关于「准」的答案和一把衡量「准」的尺子。对一个仍在寻找规模化落地路径的行业来说,这两样东西可能同样重要。
等到年底模型权重和采集链路陆续开放,这份关于「准」的能力,会交到更多团队手里。到那时,人形机器人能稳稳写下的,或许就不只是 ANCHOR 这六个字母了。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。

黄仁勋离任后:硅谷101访谈英伟达的技术、供应链与组织挑战 (opens in a new tab)
硅谷101采访半导体、科技与投资人士,讨论黄仁勋离任后CUDA生态、系统整合、供应链、开源投入和组织传承的潜在变化。产业放缓、估值折扣及人才流失判断属于受访者观点。