X7 Ultra 如何让大模型用上标称算力?从芯片架构到车企协同
新芯航途介绍 X7 Ultra 的超大核 NPU、专用算子、编译优化与硅前模型验证,尝试减少智驾大模型的数据搬运和计算等待。公司披露的20万颗出货与40余款车型订单属于 X7 系列整体;下一代 X9 和 L4 落地时间仍是后续规划。
近期,Momenta CEO 曹旭东提出一个判断:
智驾摩尔定律正在加速,安全性与性能的提升,正从「每两年十倍」迈向「每年十倍」。
沿着这一趋势,他预计,2028 年有望成为 L4 落地的引爆点。
听起来很提气,但这句话还有个前提,底层芯片得跟得上。
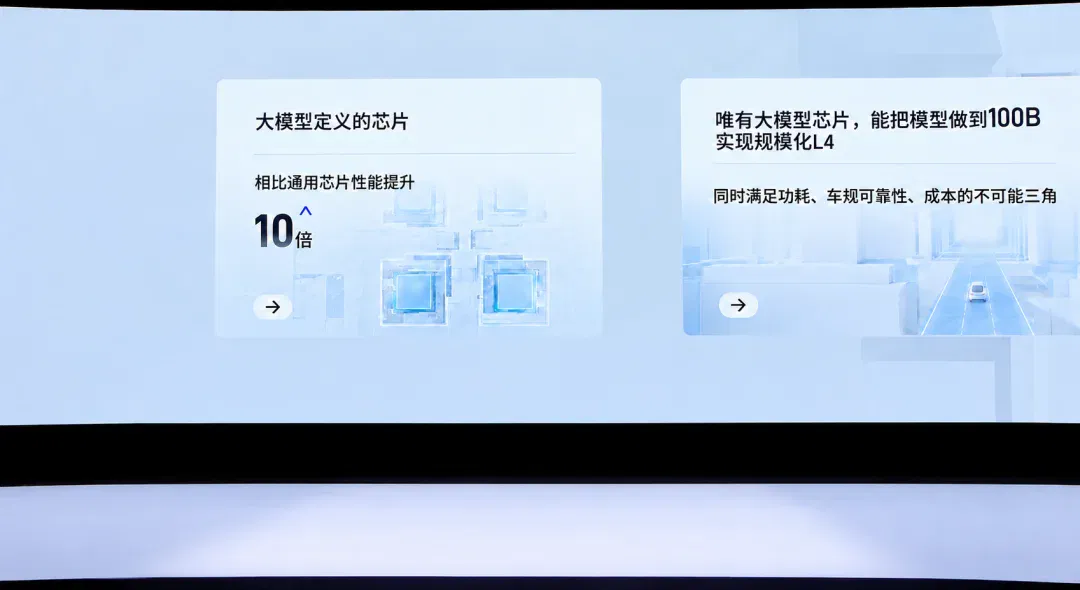
随着智能驾驶迈向规模化 L4,系统需要支撑百亿甚至千亿参数的大模型,传统通用芯片正面临「不可能三角」的制约,难以在有限功耗和车规可靠性要求下同时满足成本约束。
曹旭东认为,围绕大模型需求定制芯片,综合性能可比通用芯片高出整整 10 倍,这是当下支撑千亿参数模型在车端落地的唯一可行路径。
其实早在三年前,Momenta 就提出了「大模型定义芯片」这个方向,并拉着「兄弟」公司 XHEART 一起搞研发。
10 月 29 日,这个纸面想法落地兑现。
XHEART 新芯航途正式推出旗舰芯片 X7 Ultra。
这是一款从架构底层开始、围绕大模型需求深度定制的智驾芯片。大模型算力达 700 TOPS,在量产模型输出相似度达 99.99% 的条件下,依然能够释放高效计算能力。
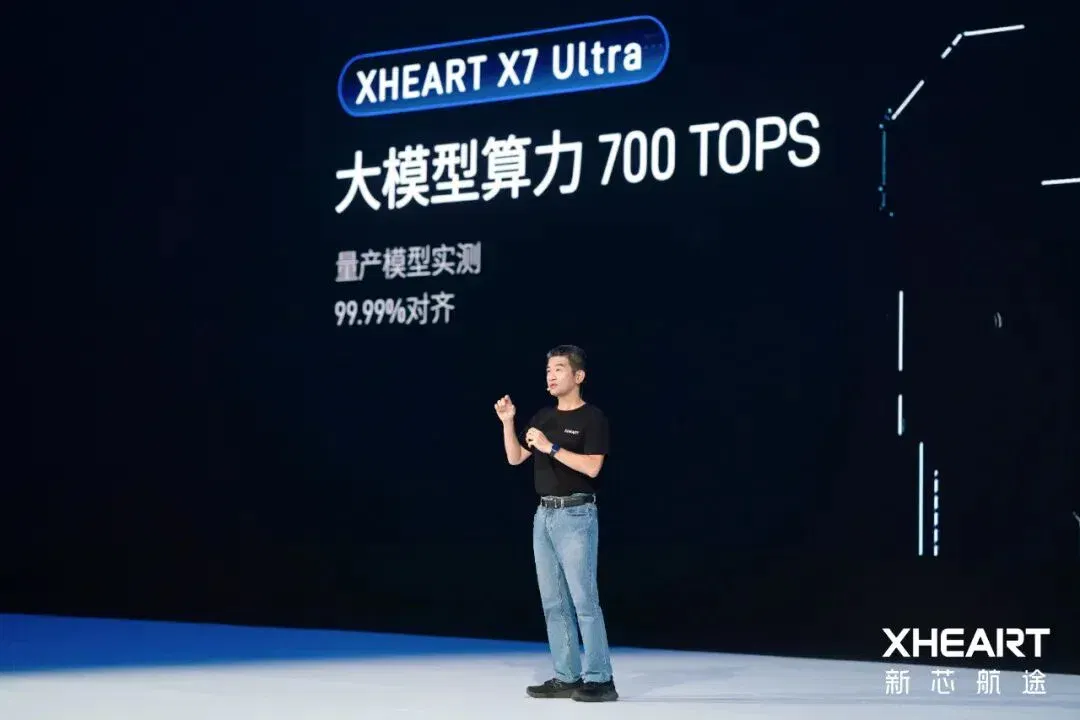
据 XHEART CEO 李宗霖介绍,X7 系列已经量产 8 个月,累计出货超过 20 万颗,搭载 10 款量产车型,并获得超过 40 款车型订单。
X7 Ultra 在技术上到底改变了什么?一家成立不到三年的公司,又凭什么拿下主流车企的量产订单?
大模型定义芯片
芯片释放大模型潜能
发布会上,大家普遍关注 X7 Ultra 700 TOPS 的大模型算力。
但智驾行业里有一个公开的秘密,标称算力和大模型真正能用到的算力,往往是两回事。
这是因为峰值 TOPS 只代表芯片在特定精度和理想负载下的理论运算上限,大模型真正上车后,数据搬运、算子支持、计算精度、并行调度和功耗限制,都会影响算力释放。纸面算力很高,并不代表量产模型能够充分调用。
X7 Ultra 试图从架构层面解决这个问题,而不是在原有逻辑上打补丁。
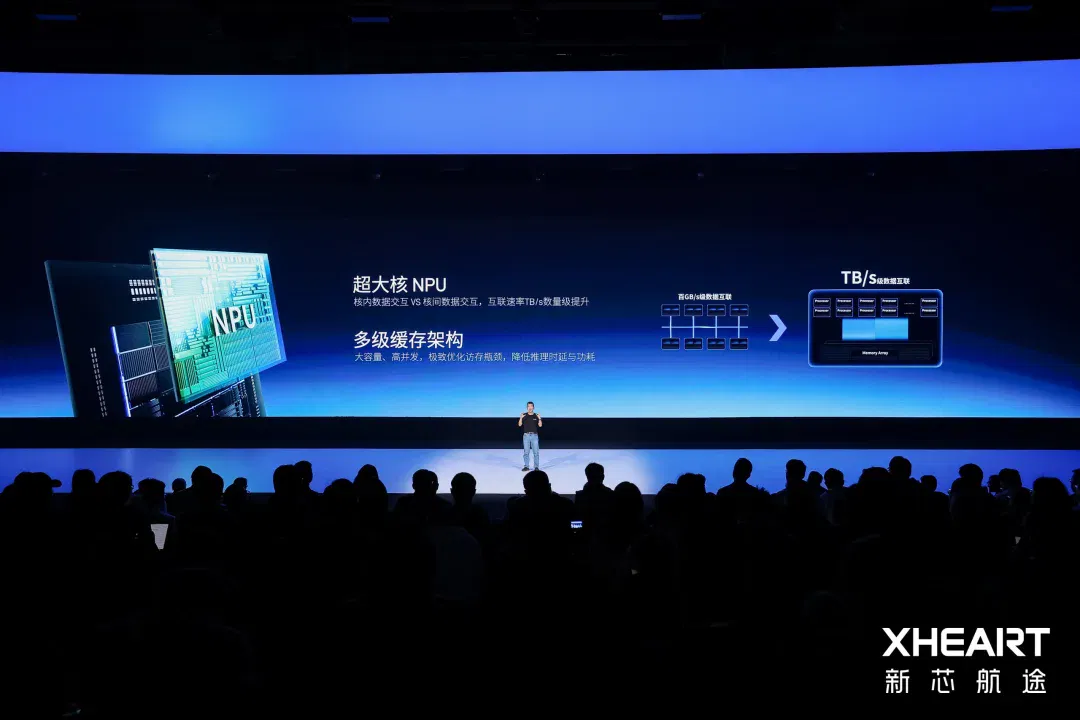
第一个关键改变,是专为大模型设计的超大核 NPU。
传统多小核方案里,计算单元之间搬数据是绕不开的成本,核间交互带宽往往只在百 GB/s 量级,计算单元等数据的时间被大量消耗。X7 Ultra 把计算任务集中在超大核内部处理,核内数据交互速度提升到 TB/s 量级,配合多级缓存,外部存储的访问次数和等待时间都大幅下降。
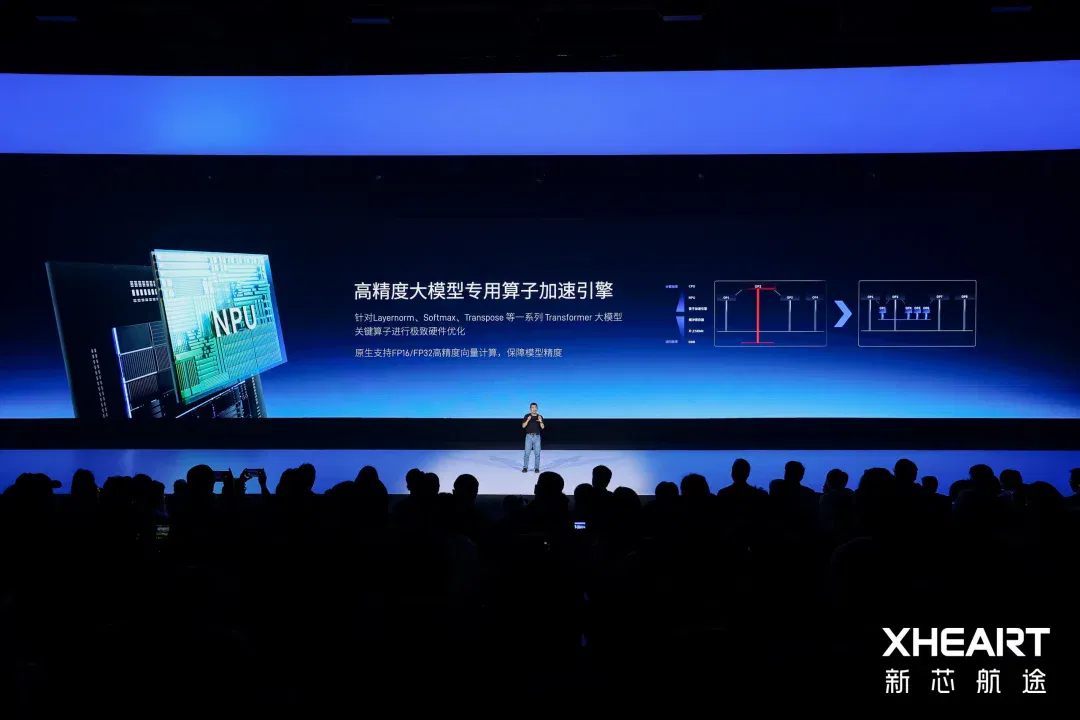
第二项变化,是给 Transformer 关键算子开了专属硬件通道。LayerNorm、Softmax、Transpose 这类算子,决定着大模型推理结果的精度。以前全靠通用计算单元处理,速度慢、精度也容易出偏差。X7 Ultra 在硬件层面对这些算子做了专项加速,原生支持 FP16 和 FP32 高精度向量计算,让推理速度和模型精度可以同时顾到。
第三项变化,是释放 NPU 的硬件并行度。X7 Ultra 让更多计算单元同时工作,并支持模型计算与权重加载并行进行,一部分单元执行当前任务时,下一批权重已经开始载入,等待时间随之缩短。
第四项改变落在 AI 工具链。XHEART 对底层编译器进行软硬件联合优化,整网级融合可以统一编排模型计算,片上存储和内存零拷贝则减少中间数据搬运,降低外部 DDR 读写次数。
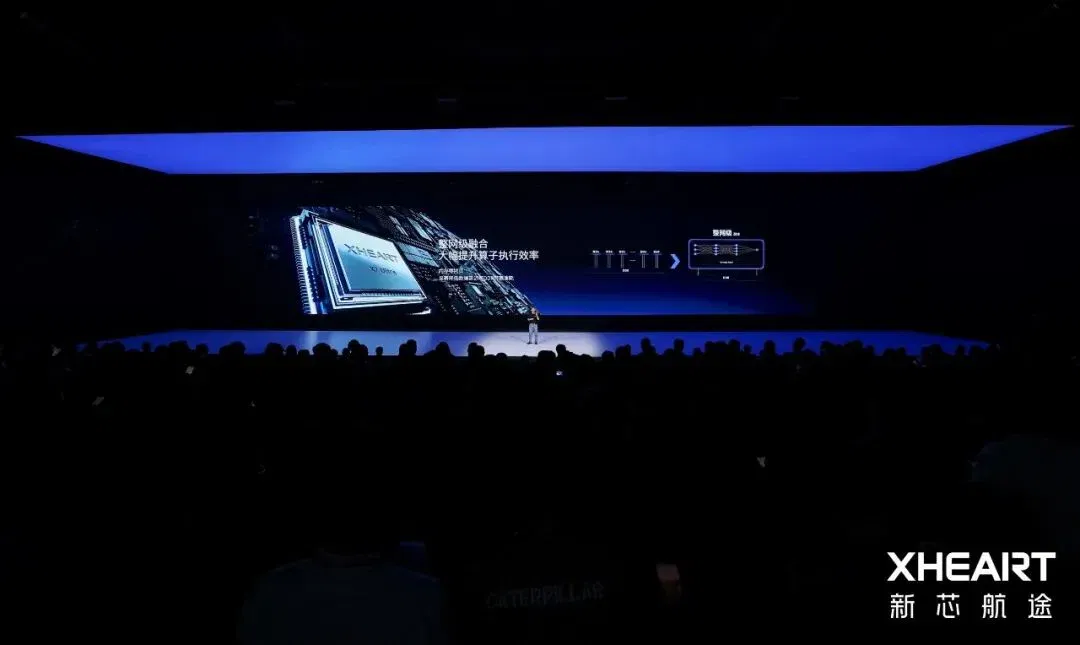
以上技术设计都是为了让标称算力尽可能转化为模型真正能够调用的算力。实测数据显示,基于合作伙伴的 Transformer 量产智驾模型,X7 Ultra 的计算利用率达到 98.7%;在模型性能相当、对标行业旗舰产品的条件下,其内存带宽消耗下降 80%,每瓦性能与体验表现提升 100%。
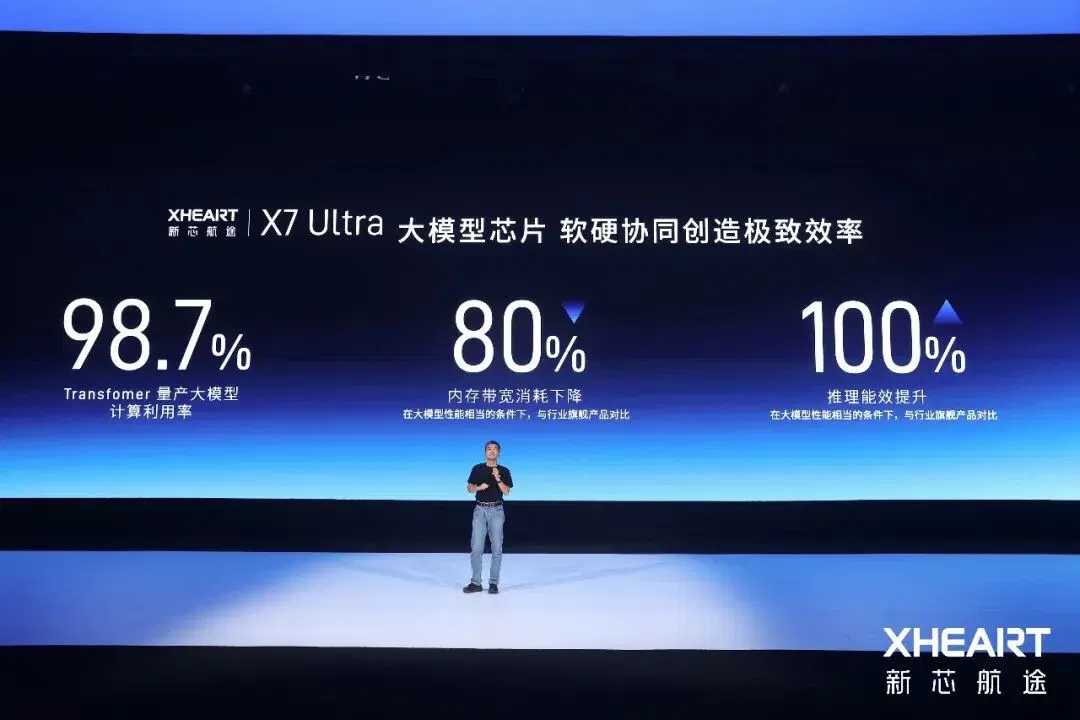
同时,量产模型输出相似度达到 99.99%,也就是「四个九」,这说明不论芯片是哪一批次生产的、车内温度高低、已经连续运行多久,大模型给出的推理结果几乎完全一致,这对真正规模化落地的智驾来说至关重要。
NPU 之外,X7 Ultra 还升级了 CPU、传感器处理和安全能力。
芯片采用 Armv9 车规级 CPU,通过 SVE2 向量处理、大集群架构和 L3 缓存访问优化,承担操作系统、任务调度及复杂系统工作。激光雷达处理加速器的点云处理能力达到每秒 2000 万点,高性能实时计算单元的预处理稳定性提升 100%,为后续模型提供及时、稳定的输入。
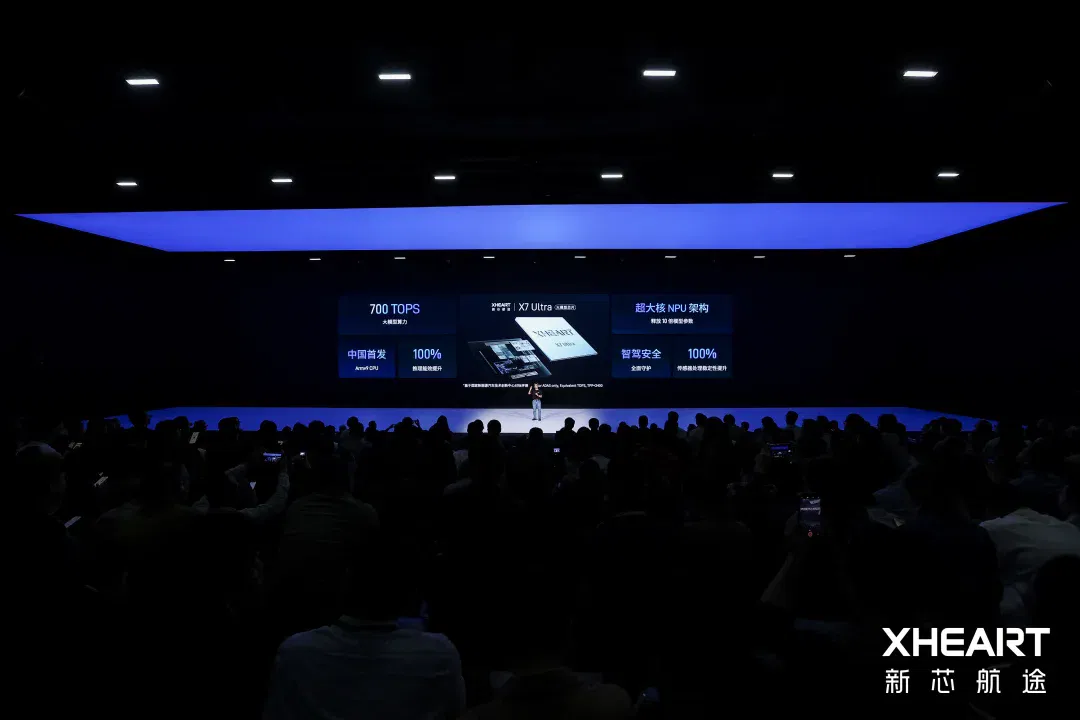
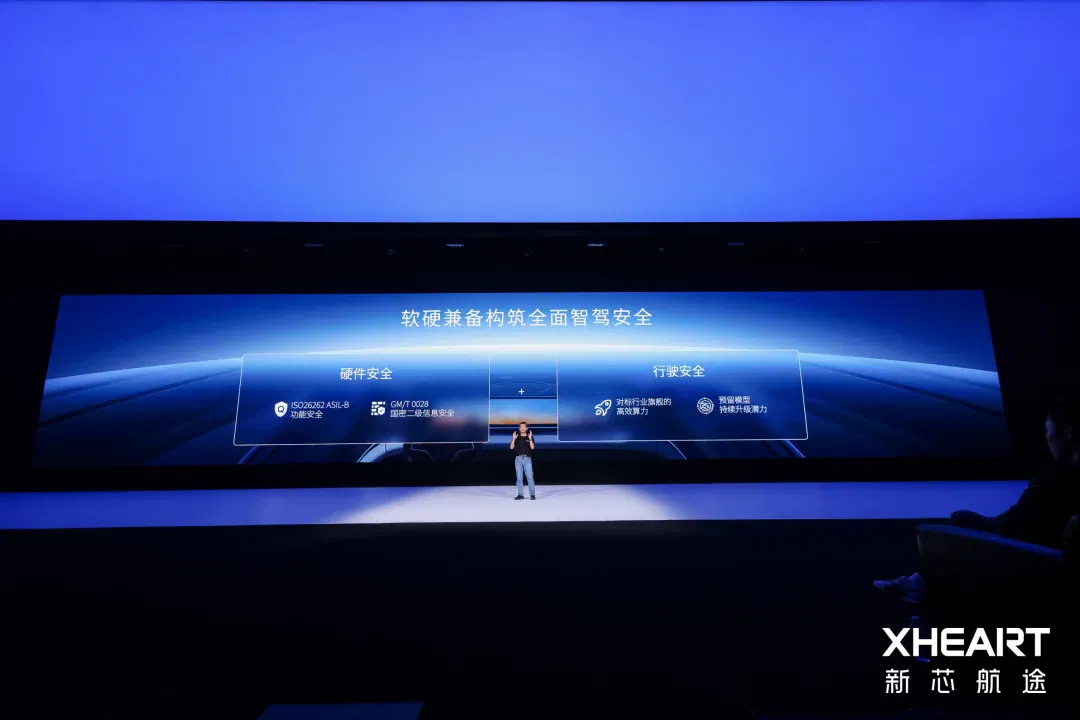
在安全方面,X7 Ultra 满足 ISO 26262 ASIL-B 功能安全要求,内置 MCU 通过 ASIL-D 认证,信息安全达到国密二级要求,并支持多项物理攻击防护手段。
成立不到三年
凭什么拿下 40 款车型订单?
芯片参数再好看,最终还是得看有没有车企真金白银买单。
目前,X7 系列已量产 8 个月,累计出货超过 20 万颗,已经搭载 10 款量产车型,并获得超过 40 款车型订单。这个速度在整个行业里其实并不多见。
XHEART 为什么能跑得这么快?这里面有一个绕不开的行业背景。
前几年,大多数车企为了赶上智驾落地的窗口期,选了当时最成熟的通用方案,但随着端到端大模型快速铺开,他们遇到一个共同的难题:平台定下来了,模型却在快速演进,而芯片架构的约束让模型越来越难以完整上车。
更让人头疼的是时间差。整车研发周期动辄两三年,车规芯片从设计到量产又要经历漫长验证,等车真正上市,当初选定的算力平台可能已经跟不上那时候的模型需求了。
而XHEART 与传统芯片公司是反着来的,它不是先把东西做出来再谈适配,而是在芯片还处于规划阶段,就把做模型的、造车的全拉到一起。
作为国产智驾技术的头部玩家,Momenta 是不可替代的一环。他们的 R7 世界模型已经真正理解路上的车为什么这样走、行人下一步会去哪、复杂交叉路口里的博弈逻辑是什么,这种级别的模型对芯片的要求,和早年的感知模型根本不在同一个维度。
Momenta 把这些真实的模型结构、关键算子需求、以及对未来模型演进方向的判断,直接带进了 X7 Ultra 的设计过程,XHEART 据此调整 NPU 架构、资源配置和执行方式。
更重要的是,量产模型参与硅前验证,芯片尚未回片,团队便可提前发现算子和数据流上的问题。
车企侧也不是被动的接收方。上汽、奇瑞、通用这些合作伙伴,从早期就把自家车型的道路数据、整车电气约束、功耗上限和实时性要求反馈进来,这些限制反过来影响了模型的结构设计和工具链的优化方向。
每一个参与者解决一类问题,这套协同形成了一个真正的闭环。
围绕不同车型的部署需求,XHEART 还提供 COB、SiP 和双 X7 域控制器参考设计。双 X7 方案面向 L3 和 L4,在 SoC、MCU 和电源等关键环节设置冗余,平台支持 16 路相机输入、多路车载以太网,并提供风冷和液冷选择。这些参考设计降低了车企的系统集成成本,也让芯片公司承担更多交付工作。
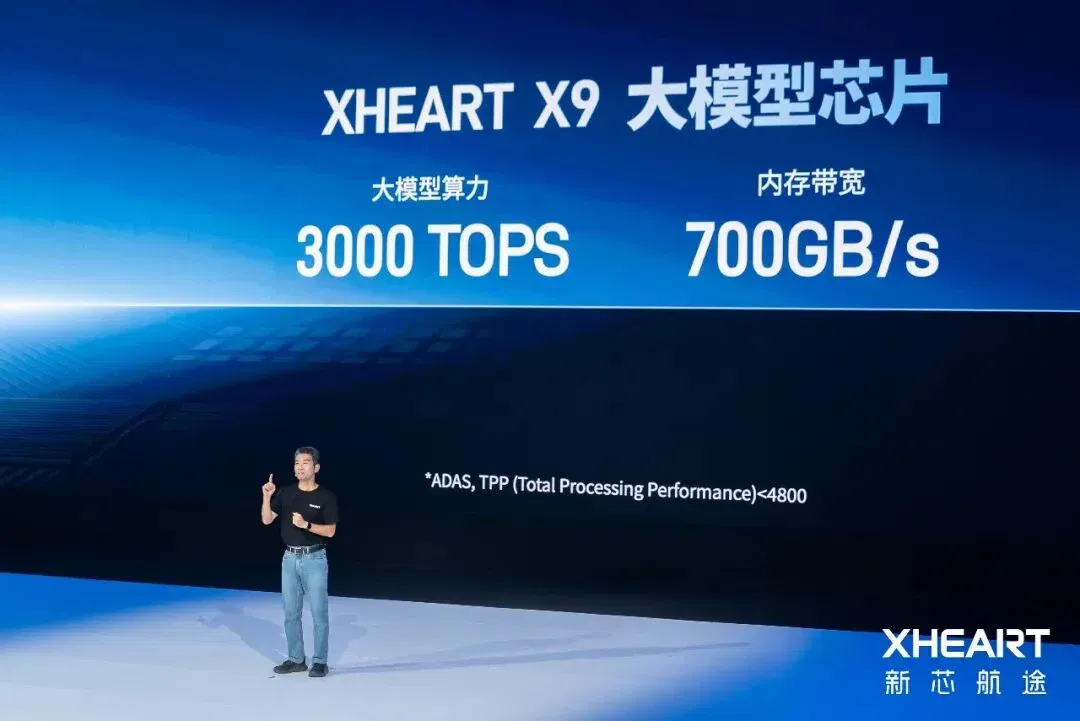
发布会现场,XHEART 亮出自己的产品节奏:量产一代、开发一代、预研一代。CEO 李宗霖表示,XHEART 已经启动下一代 X9 研发,其大模型算力目标直指 3000 TOPS、内存带宽达 700 GB/s,进一步面向 L4 自动驾驶、机器人和其他端侧物理 AI 场景。
结语
智能驾驶进入大模型阶段后,芯片的评价方式也在改变。
峰值算力固然重要,但模型适配程度、计算利用率、带宽消耗、能效、安全和交付速度,也共同决定着一颗芯片的实际价值。
X7 Ultra 提供了一个具体样本。模型方向提前进入芯片设计,量产模型参与验证,车端限制再反馈给模型和工具链,其量产成果也说明这条路线已经得到一批客户认可。
2028 年是 L4 的重要引爆点,留给芯片供应商证明自己的时间窗口已经打开。下一阶段的竞争,将同时考验模型上限、芯片效率和量产速度。谁能更快把模型进步转化为车端可负担、可持续升级且可安全交付的能力,谁就更可能掌握规模化 L4 的节奏。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
X7 Ultra 的大模型算力口径:利用率、量化相似度与软硬协同 (opens in a new tab)
这篇报道进一步解释新芯航途与 Momenta 如何把量产模型需求带入芯片设计,以及计算图融合、缓存和专用算子如何减少等待。厂商公布的 98.7% 是指定任务下的计算利用率,99.99% 指量化输出与基准的相似度,两者都不能直接当作道路安全率或任意模型的可用算力。
新芯航途发布 X7 Ultra,以智驾模型需求反向设计芯片 (opens in a new tab)
XHEART 新芯航途介绍面向智驾大模型的 X7 Ultra,从大核 NPU、缓存、专用算子和工具链降低数据搬运开销,并与 Momenta 讨论模型和芯片协同路线。带宽与能效收益来自厂商的指定模型测试,量产订单、后续芯片和 L4 落地预测需与已实现能力区分。
国产世界模型首次出海上路!Momenta直接让百亿公里老司机开上欧洲街头 (opens in a new tab)
Momenta与神龙科技达成战略合作,将基于R7世界模型共同开发高阶智能辅助驾驶系统并搭载于标致、Jeep新量产车型,覆盖中国、欧洲及全球市场,实现国产世界模型首次出海上路进入国际品牌全球车型开发体系。
独家丨Momenta前高级研发总监谢思洋离职创业,入局AI硬件 (opens in a new tab)
雷峰网·鲸犀独家获悉,Momenta 前高级研发总监谢思洋已于今年四月离职,联合前徕芬首席产品官/研发负责人刘璇创办一家智能硬件初创公司。团队计划从智能戒指切入消费可穿戴硬件市场。
英伟达讲了三年的故事,Momenta准备在港交所兑现 (opens in a new tab)
今天上午,利弗莫尔证券数据确认:MOMENTA GLOBAL LIMITED(梦腾智驾环球有限公司)已正式通过港交所上市聆讯,联席保荐人为中金公司、德意志银行。