当年「字节投毒实习生」田柯宇,估值 2 亿美元,要挑战李飞飞做世界模型
曾因在字节跳动实习期间篡改代码被判赔50万元的田柯宇,其10人团队获五源资本和IDG 3000万美元投资、估值2亿美元,拟以自回归符号世界模型挑战李飞飞的空间智能路线,并于2027年发布基座模型。
“他是一己之力干崩大厂算力集群的「内鬼」,也是国内第一篇 NeurIPS 最佳论文的执笔人。如今,他要在「世界模型」的赛道上,向 AI 教母李飞飞拔剑。”
2026 年 10 月,AI 创投圈迎来一笔颇具戏剧感的融资。
一家 10 人规模的神秘实验室,没产品、没名字,成了资本市场冰火两重天的风暴眼。一方面,业内进行着道德审判,“人品不行的公司绝对不能投”,另一方面,顶级 VC 机构五源资本和 IDG 却暗中追捧,偷偷塞了 3000 万美金,把估值推到 2 亿美元。
而这家公司的创始人,正是 2024 年震动国内 AI 圈、被称作 “字节投毒实习生” 的北大博士生田柯宇。彼时,他身陷字节跳动索赔 800 万元的诉讼风波,却同时以第一作者身份拿到 NeurIPS 2024 最佳论文奖。这样一个争议与天才并存的人,如今又拿到了顶级 VC 的巨额押注,要在世界模型领域另辟蹊径,与李飞飞较量。
在世界模型热的当下,路线之争加速分化且日趋复杂,资本押注技术团队时,也在技术爆发力和历史污点中重新权衡。
田柯宇的公司在做什么?
田柯宇切入世界模型赛道的角度确实独特,他想让 AI 发明一套自己的语言,重新理解现实世界。
在他看来,人类语言并不适合完整描述物理世界,它的信息维度太低,会丢失了海量物理信息,也会白白消耗算力。比如,一段橘猫从桌上跳下的五分钟视频,很难用文字准确描述物体的位置、运动轨迹、光影和物理变化。
因此,他的思路是创造一套 AI 专属的符号语言。目前,团队已经搭建了一套包含 20 万个符号的“视觉词典”。这些符号人类看不懂,但 AI 可以用它们表示、压缩和预测视频。据他介绍,这种方法能将生成一秒钟视频的成本降低至少一个数量级。
然后,他们准备喂进去大约 1 亿小时的视频,让模型通过这套自己的语言去学习现实世界。最终,田柯宇希望打造一个机器人、自动驾驶和交互式视频等领域的基座模型,计划于 2027 年正式发布。
他透露,团队目前不急于商业化,重心仍放在基座模型研发上。
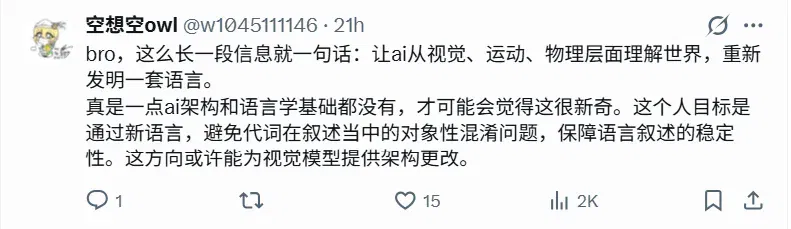
有网友指出,这个想法并无新意,本质上就是把图像和动作换成了机器自己的符号。不过,这套“新语言”对视觉模型有一个实打实的用处,能彻底解决“指代不清”的混乱,让 AI 在长时间模拟物理世界时保持绝对的稳定,从而真正改良视觉模型的底层架构。
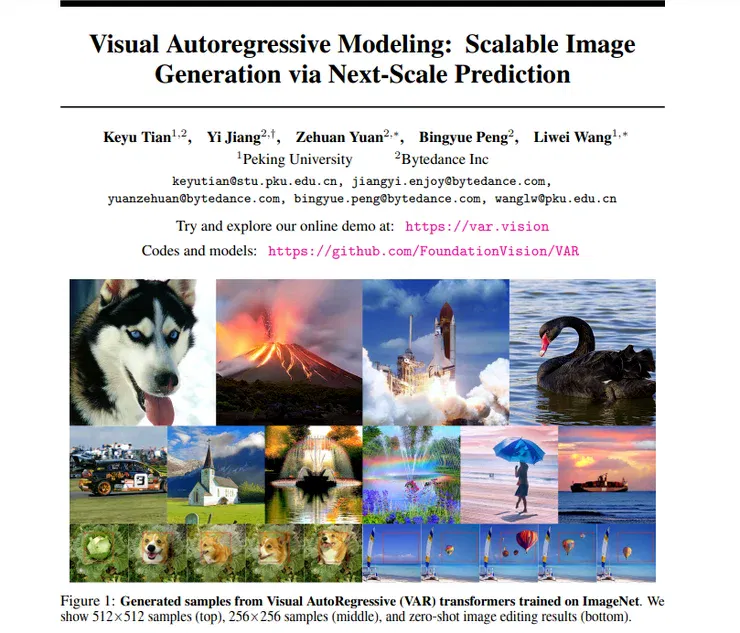
这个想法并非凭空诞生,如果溯源,其实绕不开两年前,他以第一作者身份拿下的那篇 NeurIPS 2024 最佳论文,《Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction》,这篇论文正是他在字节参与的项目,开发新一代的视觉生成模型 VAR。
在当年 NeurIPS 上万篇投稿中,这篇论文能杀出重围,关键在于它让视觉生成像 LLM 一样,可以依靠 Scaling Law 持续提升能力,同时降低生成成本和实现复杂度。
在 VAR 出现之前,视觉生成一直在两条弯路上内卷。
最早的一派是模仿 LLM 的自回归的路线,以 VQ-VAE、VQGAN 为代表。它采用光栅扫描,把 2D 图像强行展平成 1D 长序列,像老式打印机一样,从左上角到右下角一个一个 Token 地预测。
这带来的问题,一个是像素间的二维空间联系被切割,AI 并没有真正获得原生的视觉能力;另一个是图像 Token 数量远多于文本,为了重新理解像素间的关系,注意力计算量直接爆炸。
另一条路线是以 Midjourney、Sora 为代表的扩散模型,它们的逻辑更符合人类的视觉体验,“先画出模糊的全局轮廓,再精心修饰”。在画面质量上,扩散模型击败了早期自回归模型,统治了视觉生成。
但扩散模型也有自己的问题,生成速度太慢,算力消耗巨大,很难用在自动驾驶、实时交互等需要实时响应的场景。而且它和 LLM 的自回归架构根本不是一套体系,做不了原生的多模态统一。
田柯宇和当时的团队没有沿袭扩散模型,而是重新回到自回归这条老路,提出了一套叫“下一尺度预测”的新玩法。
具体来说,VAR 不再把图像拉成一维,而是保留图像原本的二维结构。它靠多尺度残差 VQ-VAE,把图像拆成一层比一层清晰的分辨率图,从 1×1 的模糊全局轮廓开始,接着是 2×2、4×4、8×8……模型像人类画画一样,由粗到细,一层一层地并行预测出下一级的所有细节。
这个思路让生成速度直接涨了 20 倍。更关键的是,它用纯正的 GPT 架构搞定高质量的视觉生成,给多模态大一统铺了路。
VAR 也是第一次在视觉生成里跑通了近乎完美的 Scaling Law。当模型参数从 3 亿扩大到 23 亿时,不仅性能跟着提升,还自动“涌现”出了零样本的图像修复、画面外扩和指令编辑能力。
然而,就在这篇顶会获奖论文发布的同时,田柯宇个人的争议事件爆发,VAR 项目的代码仓库里出现了大量关于学术伦理和诚信的质疑。字节的起诉、后续法院判决,也让国内外高校、大厂研究机构短期内不敢和他开展公开学术合作,算力支持也成了问题。
面对这种局面,田柯宇主动退出传统学术赛道,转身创业,把 VAR 的思路套在更复杂的视频和世界模型上。
当年投毒事件更多细节
离开字节后,田柯宇近乎两年销声匿迹,没有再发表过什么令人瞩目的论文。在最新接受彭博社的独家专访时,他主动揭开了当年那场“投毒事件”的更多内幕。
关于这个争议事件,当年在互联网上版本众多,且充斥不少夸张细节:某实习生摧毁 8000 张 GPU,造成上千万美元损失,直接让字节大模型训练瘫痪。但结合字节官方声明、法院裁决文件,这件事折射出的问题更像是大厂内部算力资源争夺的真实困境。
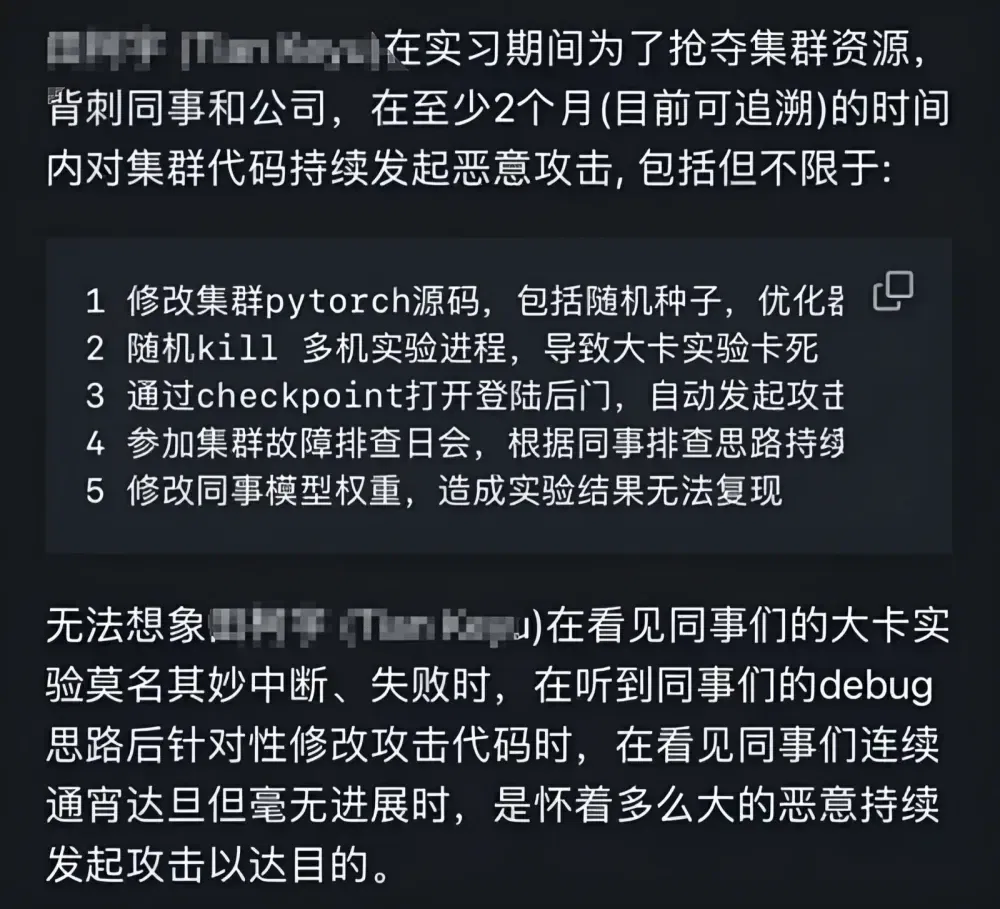
2024 年 6 月到 7 月期间,田柯宇作为北大在读博士生,在字节商业化技术部门实习,做 VAR 项目。他不满团队算力分配,于是,他编写篡改代码,干扰同事模型训练任务。
他采用的技术手段并不复杂,是利用了 Hugging Face 加载模型存档时的一个安全漏洞,在权重文件里偷偷塞进了恶意代码。其他同事只要加载这份文件继续训练,恶意代码会动态改写对方训练用的优化器,让模型朝着错误的方向去优化。另一方面随机插入延时指令,拖慢训练速度。结果就是整整一个季度里,团队 30 多位研究者白干。
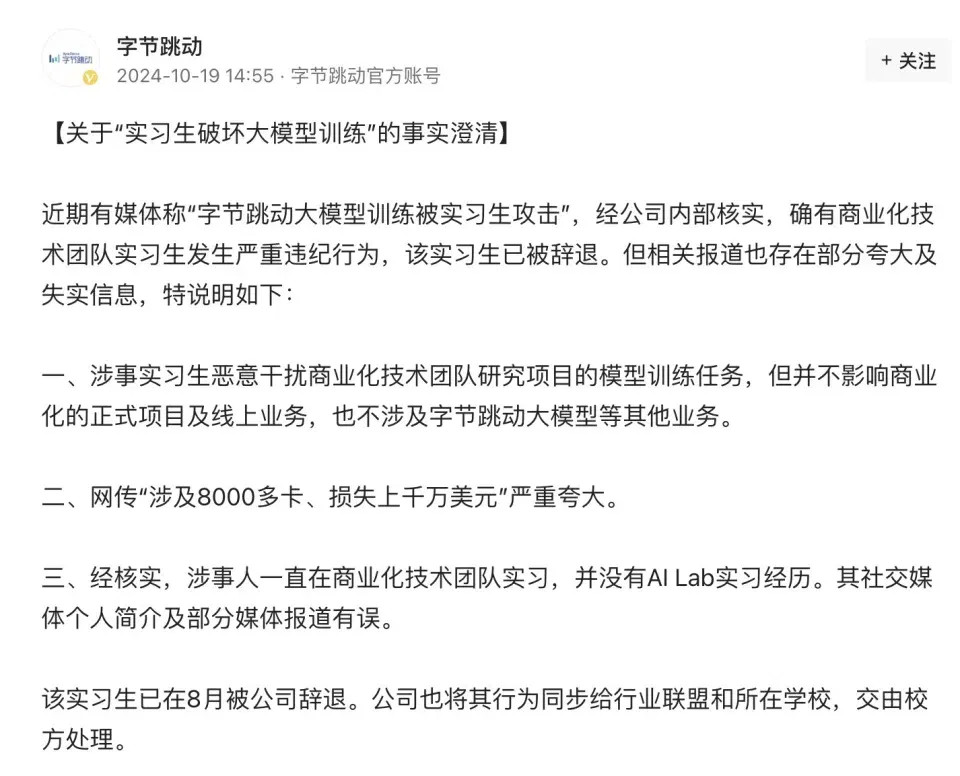
2024 年 8 月,字节完成内部调查后,解除田柯宇的实习协议,将事件同步北京大学、阳光诚信联盟与企业反舞弊联盟。最初,字节最初考虑到田柯宇博士生身份,并没有把这事闹大,而是交由校方内部处理。
2024 年 10 月中旬,“字节实习生给大模型投毒、涉及 8000 多张卡、损失上千万美元”的聊天截图在微信群里病毒式扩散。
10 月 18 日,字节公开声明确认有实习生被辞退,同时澄清“涉及 8000 多卡、损失千万美元”言论是严重夸大,受影响的只是内部研究项目,并非字节对外商用大模型。
在事件曝光后,田柯宇多次对外否认作案,声称自己遭到嫁祸,甚至报警维权。字节认为对方没有认识到行为问题,11 月 25 日,一纸诉状,把他告到了北京市海淀区人民法院,要求索赔 800 万元,以及 2 万元合理支出,要求田柯宇公开赔礼道歉。
随后,戏剧性一幕出现:2024 年 12 月 4 日,NeurIPS 2024 公布最佳论文,田柯宇作为一作的 VAR 上榜,这项成果正是他在字节实习期间和团队共同完成。在人工智能领域的学术殿堂中,NeurIPS 的地位堪比文学界的诺贝尔奖,而这篇论文是第一篇来自中国大陆的 NIPS 最佳论文。
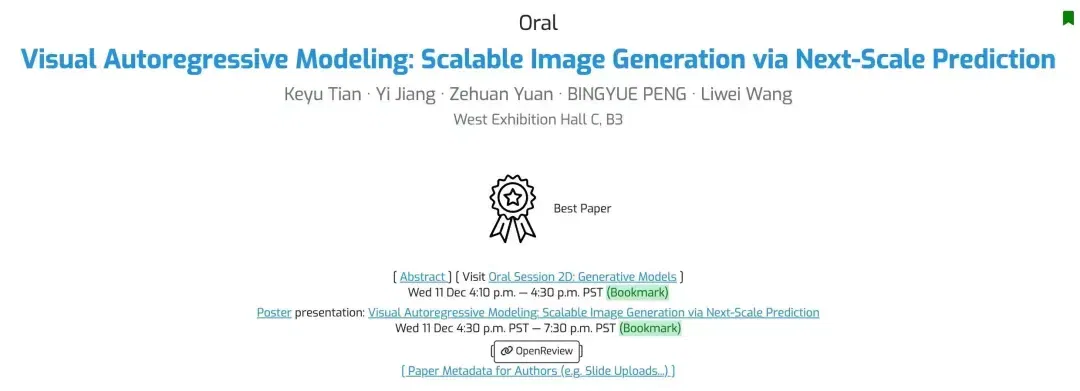
天才成就与职场违纪,集中在一人身上,整个国内 AI 圈哗然。
后续经过审理,法院最终判决田柯宇违反实习合同,赔偿字节 50 万元,同时返还全部实习工资。
在 2026 年彭博社的专访中,田柯宇补充了更多细节。他当时叫停了另一名实习生的项目,是因为他认为对方超额占用算力,所以他用干扰的方式去对抗。回顾这件事,他承认自己做错了,“当时我的做法无异于以暴制暴,”田柯宇说道。“如果能以今天的眼光重新来过,我一定会采取更明智的做法。”
不少人指出,技术天赋不能作为突破职业底线的理由。也有媒体认为,这件事暴露出大厂 AI 实验室残酷的算力内卷。在 AI 实验室里,所有人都在排队等 GPU,如何合理分配资源,是当前大厂面临的组织困境。田柯宇的做法固然极端,同时也折射出天才个体和组织规则的激烈碰撞。
在创投界,唯人品论还是唯技术论的争议,至今是难解的议题。一方面不少投资人表示“人品有问题的绝对不能再用,越聪明越危险”。另一方面,在世界模型赛道,能够提出底层范式创新的顶尖人才极度稀缺。而田柯宇在视觉自回归、模型压缩上的工程能力,正是赛道刚需。而田柯宇的融资透露了一个赛道新风向,资本开始押注效率。
世界模型热潮中,资本为什么押注效率路线
2026 年的世界模型,融资消息不断传来。
李飞飞创立 World Labs,连续多轮融资累计超 10 亿美元,估值 54 亿美元,近期被 AMD 82 亿美元收购;杨立昆离开 Meta 创办 AMI Labs,种子轮拿到 10.3 亿美元,投后估值 45.3 亿美元;前阿里通义负责人林俊旸的语用科技,首轮拿到高榕、红杉、腾讯等 2.2 亿美元,估值 20 亿美元。
作为连接机器人、自动驾驶、具身智能体、交互式虚拟场景的底层物理引擎,世界模型正展现出巨大的产业前景并加速分化,衍生出一些具体的流派。
比如,以 Sora、PixVerse 为主的像素渲染派,画面越像现实越好;以 DeepMind Genie3 为代表的几何物理模拟派,能生成可持续几分钟交互一致的 3D 环境;李飞飞 World Labs 属于空间重构派,核心是空间智能,从 2D 还原 3D;还有具身规划派,以宇树、Pragmatik Labs、Momenta 为代表,把世界模型直接当成机器人小脑。
五源资本等机构把钱砸给田柯宇,赌的就是“纯自回归路线(VAR)在效率上能降维打击李飞飞的路线”。
李飞飞团队走的是“学院派”的优雅路线,重建三维世界,再去理解物理。但重建三维几何工程成本极高,算力消耗是个无底洞。而且这里有个逻辑盲区,AI 知道物体长什么样,不代表懂物理规律。比如一张拱桥的照片,AI 能完美画出每一块砖,但它可能根本不知道,如果抽掉最底下的一块砖,整座桥会塌。
田柯宇的思路,完全绕开显式三维重建。用极致压缩的符号去猜下一个画面,凭借 Scaling Law,自己悟出物理规则。
两者最大差异,落在压缩效率和算力成本上。
AI 圈一直有个共识,智能的本质就是信息压缩。视频数据存在巨量冗余,静止的背景、无意义噪点,占据绝大多数像素。田柯宇的符号系统,本质上就是一个超级压缩包,只留核心动作。压缩效率越高,模型就越容易捕捉到深层的物理因果,推理成本也会成倍下降。
在世界模型商业落地的进程中,算力成本是难以逾越的门槛。有的高阶模型算一秒钟的物理模拟,要烧掉十几美金。田柯宇对外披露能将生成一秒钟视频的成本降低至少一个数量级,正是打动投资人的关键。
李飞飞 World Labs 被 AMD 收购,证明空间重构路线有巨大产业价值,但不代表这就是唯一答案。田柯宇的纯自回归符号世界模型,代表了另一条更适配硬件、更容易跑通 Scaling Law 的技术叙事。
但这条路线,同样有巨大不确定性。
- 仅靠 20 万个符号进行视频的时空压缩,能否在长时序、复杂物理交互中稳定涌现出可靠的物理因果,目前尚未经过大规模的公开验证。
- 1 亿小时高质量视频数据的清洗、去重与质量筛选,本身就是一项庞大的工程。
- 团队规模仅有 10 人,在世界模型赛道,算力调度、基础设施、数据治理的工程压力极大。
- 过往的争议会持续影响人才招募、学术合作、行业信任,一旦技术进展不及预期,资本会快速失去耐心。
在商业与科技的绞肉机里,道德审判往往会让位于工程奇迹。
田柯宇能否用一次技术的核爆,来洗刷掉职业生涯的污点?这不仅是对 Scaling Law 的一场豪赌,更是对人性的极限测试。
文章来自于微信公众号 “雷峰网”,作者 “雷峰网”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
中国的 AI,不需要「天才娇妻文学」|记田柯宇案 (opens in a new tab)
最近看国内 AI 圈的一些新闻,我真的有点绷不住了。求求了,别再玩「天才娇妻文学」了,雷爆的还不够多吗?
我实名讨厌田柯宇和他的投资人丨VC Weekly (opens in a new tab)
VC Weekly文章作者表达了对田柯宇及其投资人的职业道德质疑,并推荐5期播客,结合Theranos、WeWork、Uber和Affectiva案例讨论创业投资中的诚信、员工伦理与技术责任。
谁领投了字节投毒实习生田柯宇 (opens in a new tab)
两年前因在字节跳动实习期间恶意篡改代码、干扰模型训练任务而被辞退,随后遭字节起诉索赔800万元的田柯宇,已经带着一家世界模型实验室重回牌桌。团队只有约 10 个人,没有公开公司名字,没有推出产品 demo ,完整模型预计要到 2027 年才发布,但已经融到近 3000 万美元,投后估值 2 亿美元。
基座模型田柯宇从不缺卡 (opens in a new tab)
事情大家都知道了,田柯宇昨天一炒作,一堆人联合出来打假田神,不仅列时间线、列代码、还列上了自己的Github主页,搞学术的就是严谨啊👇 https://keyu-tian-sabotage.github.io

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。