爆火的 Jev 模型,到底能帮我们做什么?(附免费体验地址)
内容编辑丨特工小师 特工小天 内容审核丨特工少女 一片树林里分出两条路,而我选了人迹更少的一条。 最近一段时间,社媒上被一个 Jev 模型刷屏了。 在 jev.openchamber.devg 上,关
一片树林里分出两条路,而我选了人迹更少的一条。
最近一段时间,社媒上被一个 Jev 模型刷屏了。
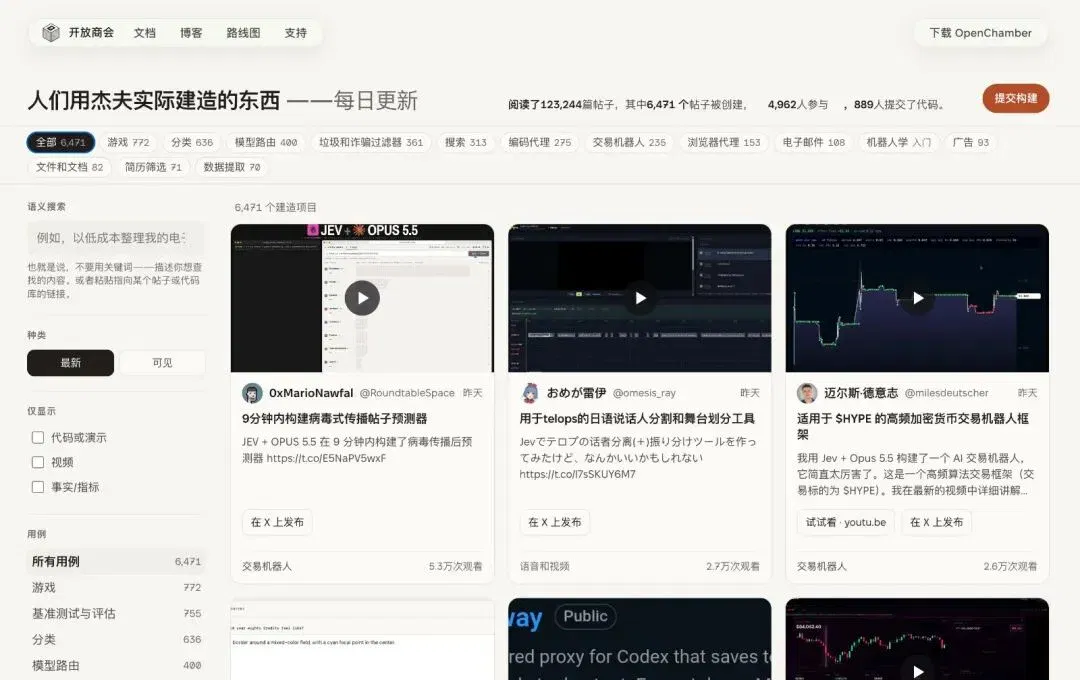
在 jev.openchamber.devg 上,关于 Jev 的应用,已经聚集了 6000 多个作品:有人用它搜航班,7 秒跑完整个流程,成本不到 0.004 美元。还有人让它同时跑 50 场《地铁跑酷》,速度快到像开了挂。
Jev 的创始人 Diogo Almeida 之前在 OpenAI 工作,他参与过让语言模型学会遵循指令的研究,那些工作后来成了 ChatGPT 的基础。
而这次,他创造的 Jev 走了一条几乎没人走过的路,做的事情跟我们熟悉的大模型完全不同。
Jev 到底在做什么?
Jev 的模型所属的类别「System One」,这个命名来自 Daniel Kahneman 的《思考,快与慢》。
Kahneman 把人类的认知分成两个系统:系统 1 是快速、自动、直觉式的,你看到一张愤怒的脸立刻知道对方在生气,不需要分析。系统 2 是缓慢、费力、需要集中注意力的,你算一道复杂的数学题,得一步步推导。
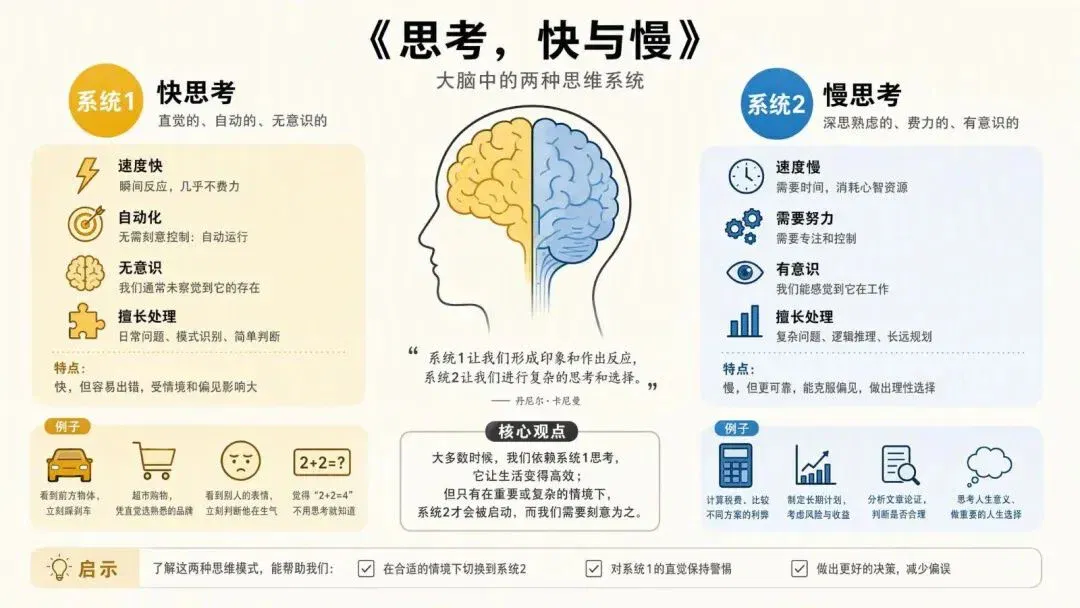
现在的大语言模型,尤其是加了推理能力的那些,走的是系统 2 的路线。它们逐个 Token 生成,一步一步思考,追求的是深度和准确性,代价是慢和贵。
而 Jev 走的是系统 1:它不逐 Token 生成,而是并行采样,一次性输出所有概率。
除此之外,它不生成文本,不写代码,不跟你聊天。它只做一件事:做决策。你给它一堆非结构化的信息,再给它几个预定义的选项,它从里面挑一个最合适的,然后把结果连同置信度一起返回给你。
整个过程 70 到 500 毫秒,输出 Token 的成本低到官方直接标注「免费,太便宜不值得计量」。
日常工作中有许多任务,本质上就是在做选择题:
比如分类任务:这封邮件是不是垃圾邮件?或者路由任务:这个用户请求应该路由给哪个客服?又或者评分任务:这段文本的情感倾向是正面还是负面?
这些任务的共同点是:你不需要模型洋洋洒洒写一大段话,它只需要一个快速、准确、带置信度的判断。
而 Jev 之所以能实现这些任务,是因为它放弃了字符串生成能力。它不会写文章,不会编代码,甚至不会说一句完整的话。
作为交换,它获得了几个能力:极快的速度、极低的成本、零类型错误、以及校准过的置信度。
官方给出的数据是:在同等智能水平下,Jev 比前沿模型快 40 到 200 倍,便宜两个数量级。输入 Token 的价格是每百万 0.042 美元,大约是 GPT 系列的百分之一。
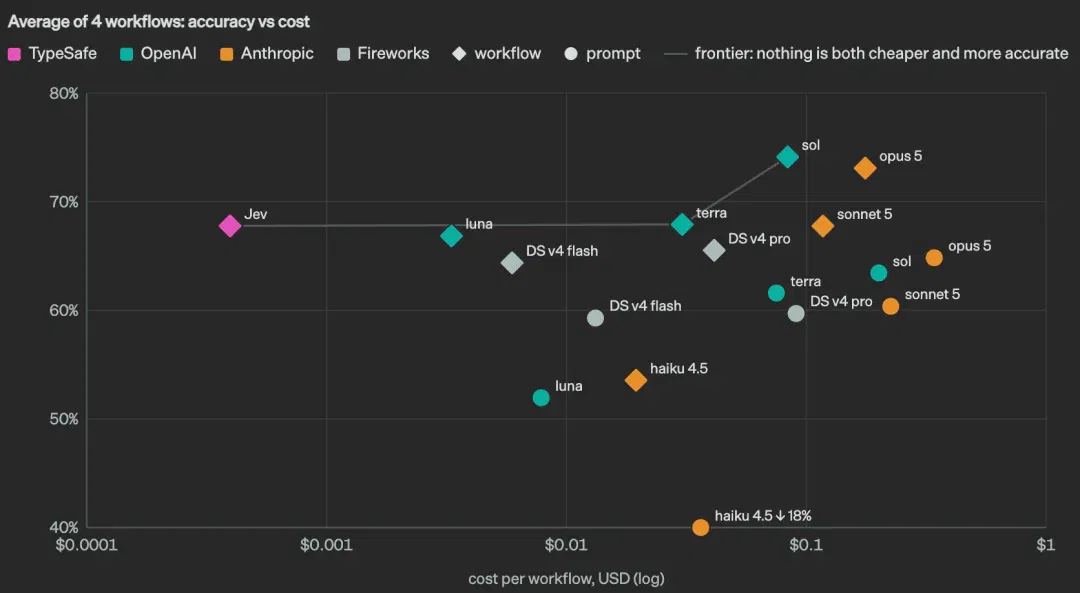
快到离谱的决策引擎
Jev 的处理方式,有什么特别的呢?
它的输入是一段话,输出是一段概率,并且非常快。
以一个用户退款的场景看,假设用户的输入是这样的:
用户留言:你们这个会员自动续费也不提醒一下,直接扣了我 88 块,我要退款!
那么经过 Api 封装后的完整请求是这样(一般需要给定预设的分类,然后让 Jev 进行判断):
POST https://tokendance.space/gateway/typesafe/v1/systemone Authorization: Bearer sk-9f18…9f { "model": "bocha-jev-v1", "state": "用户留言: 你们这个会员自动续费也不提醒一下,直接扣了我 88 块,我要退款!", "questions": { "q1": { "type": "noul", "instructions": "这段话带有负面情绪吗?", "criteria": { "true": "有负面情绪", "false": "无负面情绪" } }, "q2": { "type": "choice", "instructions": "这段话的主要意图?", "criteria": { "咨询": null, "投诉": null, "退款售后": null, "闲聊": null } }, "q3": { "type": "score", "instructions": "处理的紧急程度?", "criteria": [ "不紧急", "一般", "较紧急", "非常紧急" ] } } }
而 Jev 的输出,则长这样:
{ "model": "bocha-jev-v1", "answers": { "q1": { "type": "noul", "noul": 0.9829739332199097 }, "q2": { "type": "choice", "probabilities": { "咨询": 0.007551450747996569, "投诉": 0.6349058151245117, "退款售后": 0.35735565423965454, "闲聊": 0.00018711277516558766 }, "confidence": 0.6349058151245117, "choice": "投诉" }, "q3": { "type": "score", "probabilities": { "0": 0.048316895961761475, "1": 0.20446832478046417, "2": 0.36562931537628174, "3": 0.3815854787826538 }, "confidence": 0.3815854787826538, "score": 2.080483391880989, "legend": { "0": "不紧急", "1": "一般", "2": "较紧急", "3": "非常紧急" } } }, "usage": { "input_tokens": 573, "output_tokens": 0 }, "metadata": { "inference_ms": 25.823, "cuda_graph_enabled": true, "checkpoint_status": "experimental", "calibrated": true, "confidence_definition": "maximum candidate probability; not guaranteed correctness" }, "_elapsed_ms": 275 }
这样的模型,可以做什么呢?
让我们来看几个爆火的 Jev 应用:
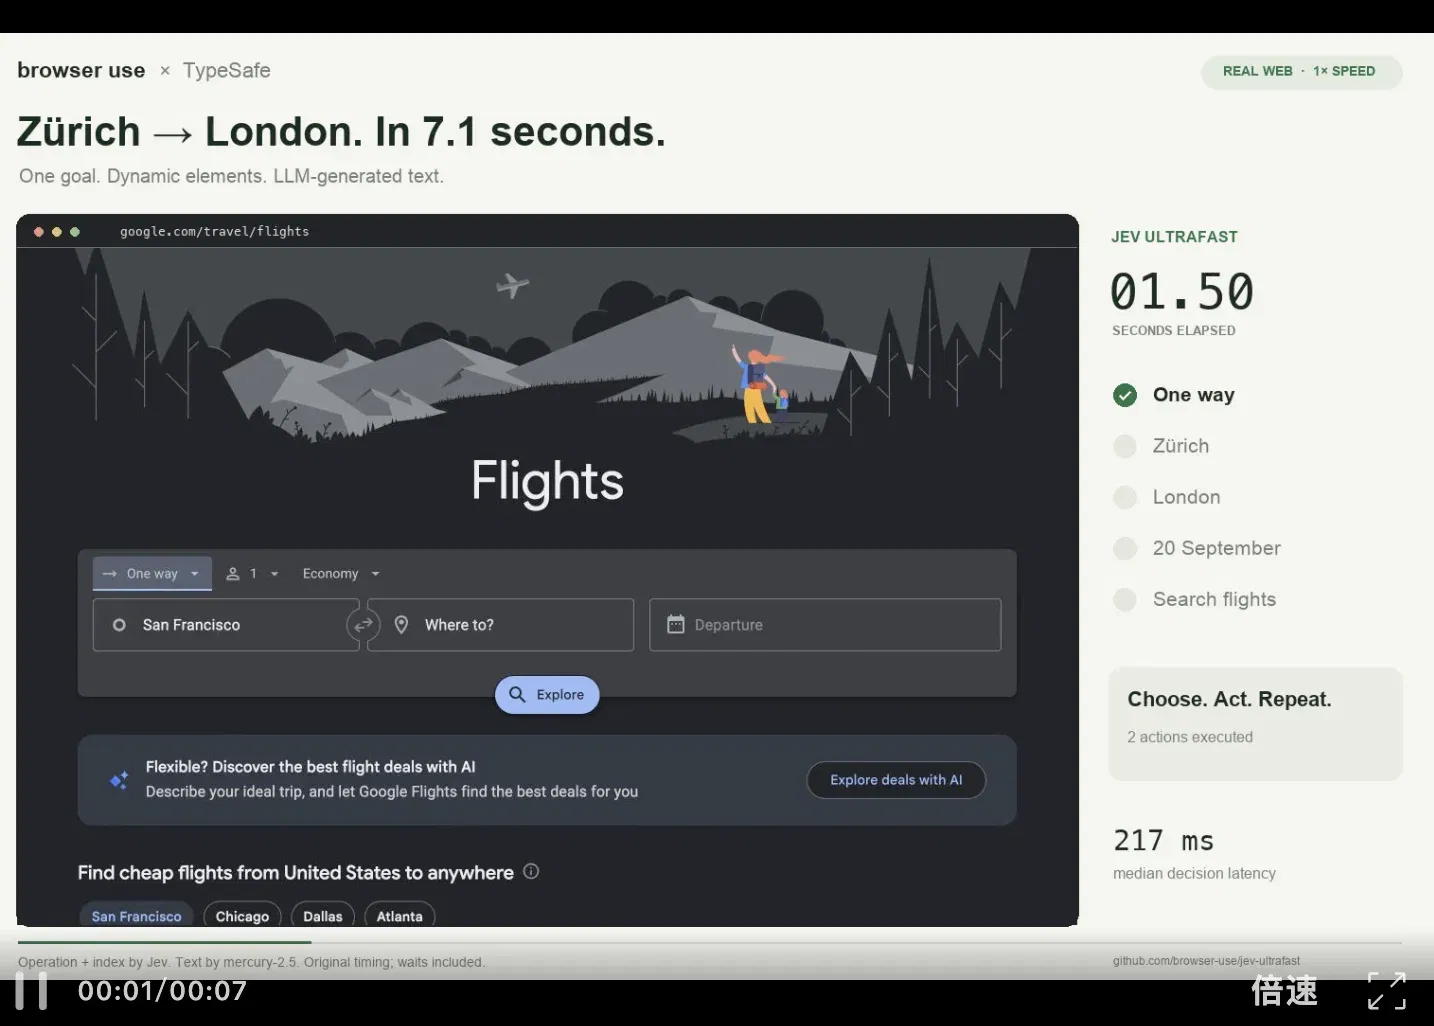
第一个是 browser-use 团队做的航班搜索。
传统的浏览器 Agent 怎么工作?截图,用视觉模型识别页面元素,决定点哪里,执行操作,再截图,再识别。每一步都要等模型生成一段文字描述,再从文字里解析出动作指令。
整个流程下来,搜一个航班可能要一两分钟。
而 Jev 全程不截图,不用视觉模型,它可以用一段轻量的 JavaScript 把当前页面里所有可交互的元素,提取成一张结构化的表格,标签名、ID、文本内容都列好,然后把这张表连同用户目标一起交给 Jev。
Jev 从这些元素里选一个去点击或填写,程序执行完毕后再提取新的元素表,再让 Jev 选。
用它在 Google Flights 上搜航线,8 次表单操作,总耗时 7.1 秒,仅花了 0.0039 美元。
第二个案例更有意思。
有个开发者叫 Toran Bruce Richards,他把 Jev 接到了一个驾驶模拟器的原始控制系统上:
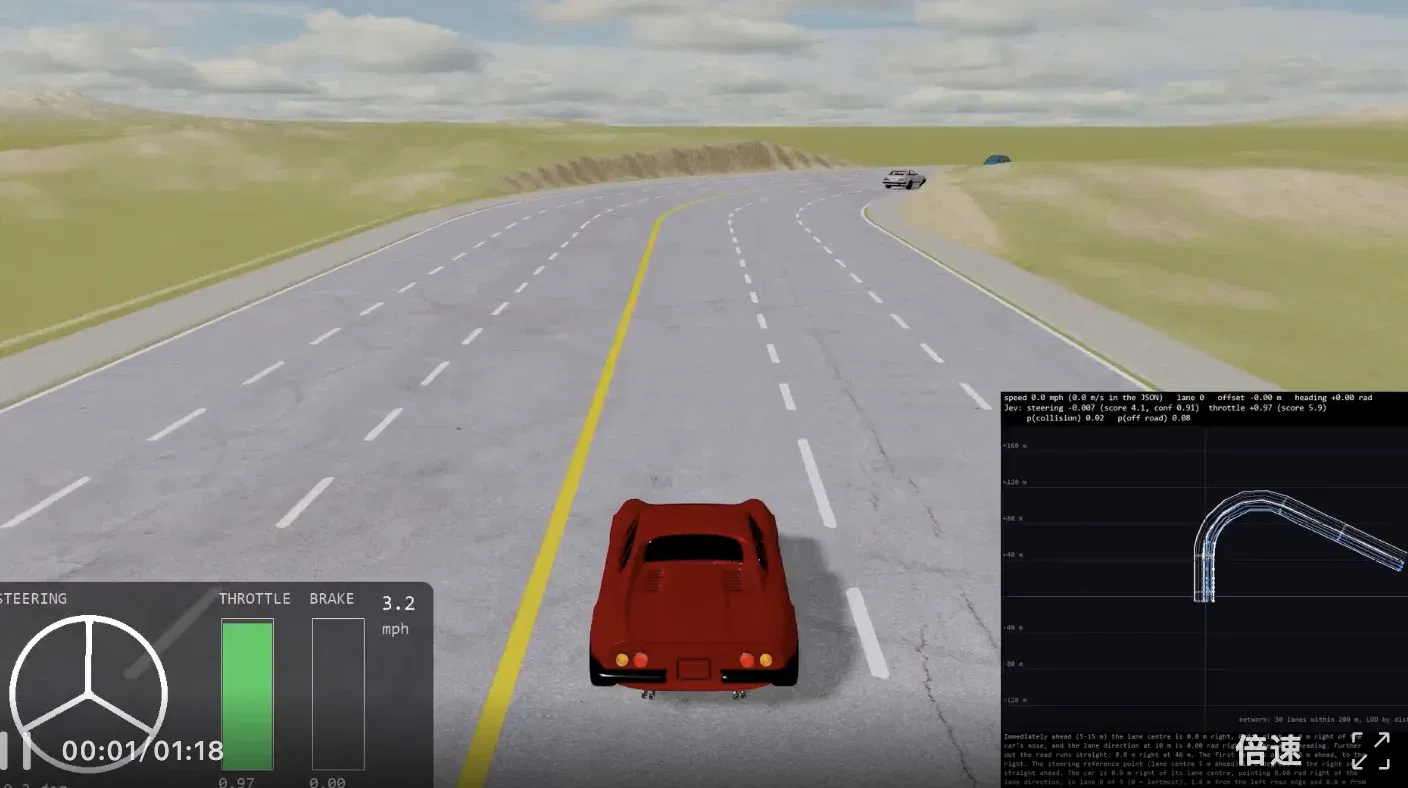
每 50 毫秒一个决策循环:程序把车辆状态发给 Jev,Jev 从「加速、减速、左转、右转、保持」这些选项里选一个,程序执行。已经接近人类的反应速度了。
第三个是一个实时股票交易的案例。
X 上的 @milesdeutscher 用 Jev + Opus 5.5 构建了一个 AI 交易机器人,他结合一个高频算法交易框架,实现了股票的实时自动交易。
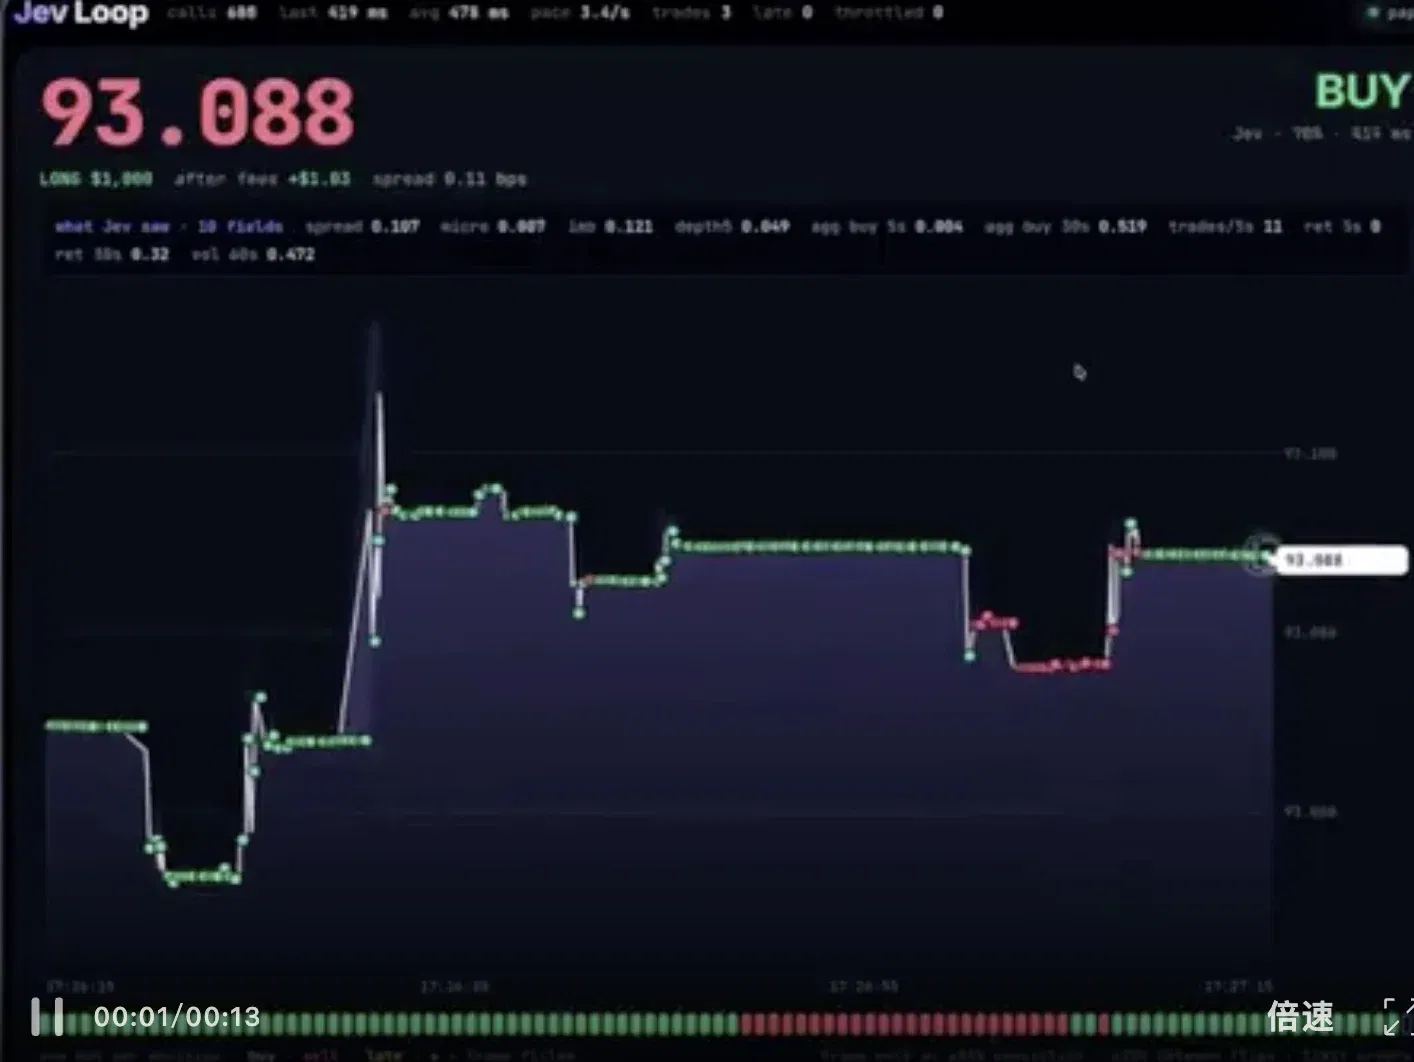
老实说,这也是我第一次见到,一个模型拥有这么多不同类型的案例:从这个意义上,Jev 的发布是一种很新颖的创新。
Jev 和通用模型的差异点
过去两年,大模型的竞争基本上就是一条赛道:通用智能。
模型越来越大,能力越来越强,价格越来越贵,然后再想办法降价。所有人都在同一条曲线上卷。
Jev 做的事情是跳出了这条曲线,并且垂类模型的训练成本更低,在特定任务上效果更好。
看到 Jev 这个模型,你可能会有一些疑问:
这些事情用大模型也能做啊,为什么以前没看到有人演示?
答案很简单:太慢,太贵。
用 GPT 来判断一封邮件是不是垃圾邮件,技术上完全可行,但你要等 3 到 5 秒,花几分钱。如果你每天要处理 10 万封邮件呢?光是 API 成本就够一个人喝一壶了,更别提用户等不了那么久。
而 Jev 把单次决策的成本压到了万分之一美元量级,延迟压到了 100 毫秒以内,直接把这些使用场景变得可以落地和解锁了。
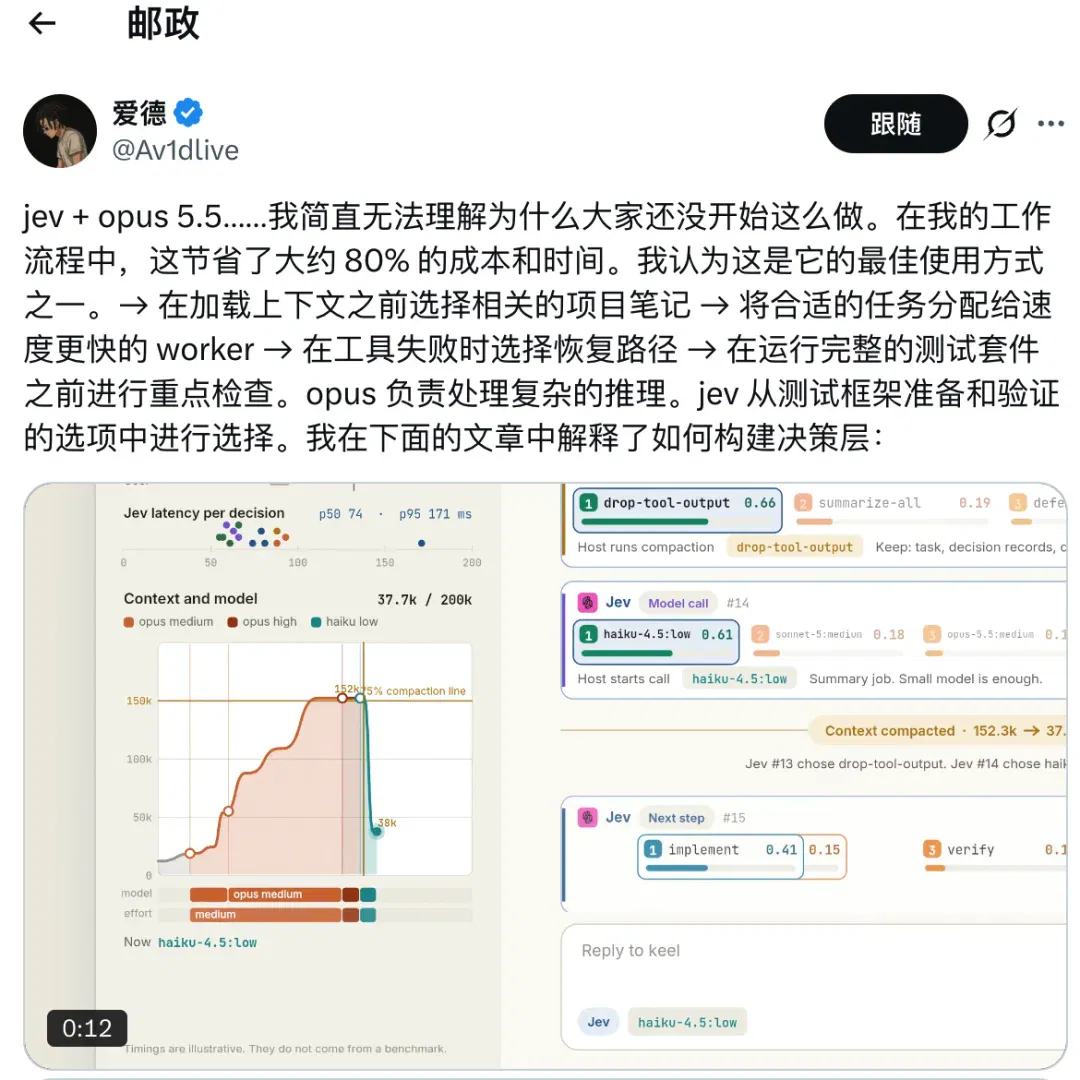
即使未来通用模型在决策任务上追了上来,Jev 在速度和成本上的优势依然存在。这跟各种大模型做 Flash 系列的逻辑很像,基于成熟的大模型蒸馏出更快更便宜的版本:
但 Jev 走得更极端,它直接放弃了生成能力。
这种取舍解锁了一些全新的可能性:
有人用 Jev 自动玩闯关类小游戏,每秒做几十次决策,成本几乎为零。有人根据任务难度做 LLM 自动路由,简单问题交给 Jev 瞬间判断,复杂问题才调用大模型深度推理。
官方博客里列了几类最适合 Jev 的场景:
- AI 驱动的工作流,说白了就是「智能 if 语句」:在普通代码里嵌入一个模糊决策节点,分类、路由、评分、提取、分支,用在手写规则太脆弱的地方。
- 大数据 Map-Reduce:把 PB 级数据批量转化为特征和洞察。
- 实时应用:100 毫秒的速度意味着可以放进用户体验敏感的产品里。
- 还有对 LLM 的输出做评分、判断、护栏和越狱检测。
总的来说,Jev 不是来替代大模型的,它填补的是一个此前被忽视的生态位:
如何通过 AI,实现一些高频、低延迟、结构化的微决策。
大模型发展的一条新赛道
Jev 这件事,有一种文艺复兴的味道。
大模型这几年做的事情,本质上是把一切机器学习和自然语言处理的分类、翻译、预测任务都抽象成了同一个任务:
预测下一个 Token。
这种统一性带来了巨大的规模效应,但也意味着所有任务都在为「生成」这个能力买单,哪怕你的任务根本不需要生成。
而当大模型的能力逐渐接近人类,行业开始走回头路了:
不是所有任务都需要系统 2 的深度思考,有些任务天然就是系统 1 的直觉判断。Jev 把这部分需求剥离出来,用一套完全不同的架构去服务,反而做到了更好的效果。
此外,大模型为了提高思维的准确度,发明了思维链、重复提示、自我反思这些技巧,本质上是在用更多的 Token 换更好的结果。而 Jev 为了速度,把这些全部舍弃,用并行采样一步到位。
这也是自 GPT3 发布后,大模型第一次开始从通用回到专精。
Jev 的模型名字取自 William Stanley Jevons,一位 19 世纪的经济学家。他提出过一个著名的悖论:蒸汽机效率提升后,煤炭的消耗量不降反升,因为更高的效率解锁了更多的使用场景。
TypeSafe 团队相信:智能成本每下降一个数量级,就会解锁更多数量级的用例。
而 Jev 的爆火也证明了这件事:当一次 AI 决策的成本从几分钱降到万分之一美元,当延迟从几秒降到几十毫秒,开发者们几乎是本能地开始探索模型的新用法,甚至把 AI 放进之前想都不敢想的地方。
Jev 不会取代 GPT 或 Claude,就像系统 1 不会取代系统 2。
但它让我们看到了一种可能性:大模型的未来也许不只是越来越大、越来越强,也可以是越来越快、越来越专、越来越便宜。
这条新赛道才刚开始。
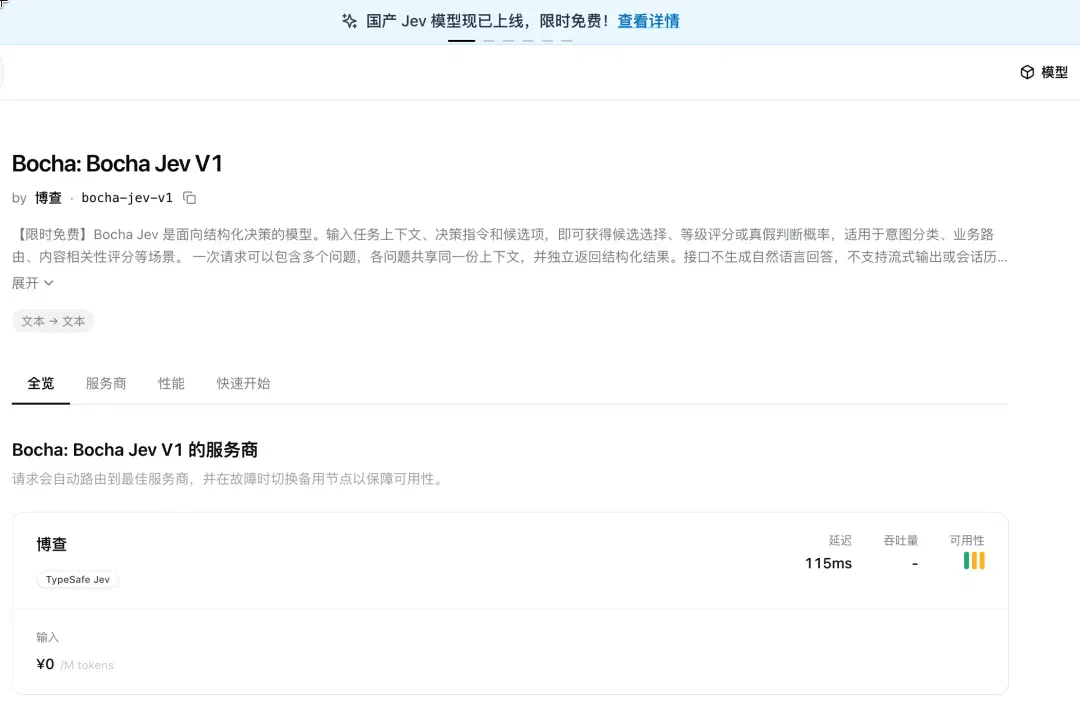
国产 Jev 模型现已在 TokenDance 上线,限时免费!
文章来自于微信公众号 “特工宇宙”,作者 “特工宇宙”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Jev 联合 Treg 开源人员检索工作流,连接候选筛选与邮箱工具 (opens in a new tab)
TypeSafe AI 与 Treg 展示面向招聘及商业研究的人员检索流程:Agent 调用数据工具,Jev 判断候选匹配度,再按需查找或验证工作邮箱。文中低价及相对 Clay 的降幅来自平台特定测试,邮箱查找、验证和履历补全分别计费;也有用户反馈检索结果不足。
断层领先Jev,全球第一!决策模型新王震撼发布新版本 (opens in a new tab)
StartLux发布StartLux-Decision新版本,推出Instant与AutoThink双模型矩阵及原创RLCD²,在Decision Index 0.3和DecisionPivot评测中领先多款模型,并公开模型权重与推理代码。
被a16z看中,上线三周的Jev拿下75亿美元估值 (opens in a new tab)
TypeSafe AI完成8.7亿美元A轮融资,投后估值达75亿美元,由a16z领投,其可直接写入代码的决策模型Jev上线后迅速增长。
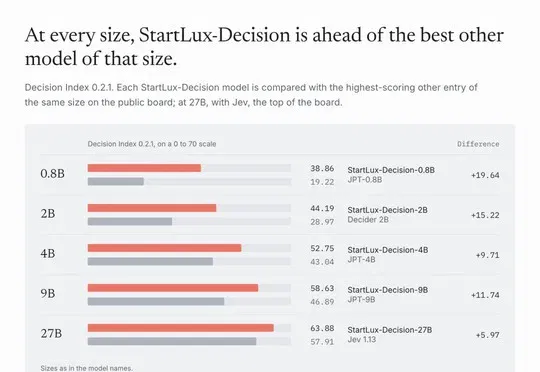
Jev被请下王座,StartLux中国开源决策模型冲上第一 (opens in a new tab)
StartLux发布完全开源的StartLux-Decision,其27B版本在Decision Index 0.2.1的38项基准中有31项超过Jev 1.13,并以63.88分升至公开榜首。
耗时1h!打造属于你自己的Jev,喂饭级教程来了! (opens in a new tab)
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。