AI代写论文露馅?顶刊主编一问,作者啥都答不上来
机器学习期刊TMLR联合主编Nihar B. Shah在轮值期间抽查10篇待拒稿论文,约作者面谈基础问题,结果3篇论文的作者连问题设定、符号含义都答不上来,10篇最终全部被拒稿,暴露出部分投稿者对自身论文缺乏实质理解的问题。
你写了一篇论文,现在问你三个问题:你这篇论文的问题设定是什么?这个符号代表什么?摘要里说的这个结论,在正文哪一部分得到了支撑?
如果论文真是你写的,那这些问题肯定很简单,甚至不用准备就能答出来。
但在机器学习期刊 TMLR(Transactions on Machine Learning Research)最近的一次小规模试验中,有三篇论文的作者连这些基础问题都答不上来。
9 月 16 日,TMLR 在官方博客上发布了一篇题为《向作者询问他们自己的论文》的文章,作者是该刊联合主编之一、卡内基梅隆大学(CMU)的 Nihar B. Shah。他在两周的主编轮值期内,挑出 10 篇原本要被直接拒稿(desk rejection)的投稿,没有直接拒掉,而是逐一约作者「聊聊」。结果,这 10 篇论文还是全部被拒了。
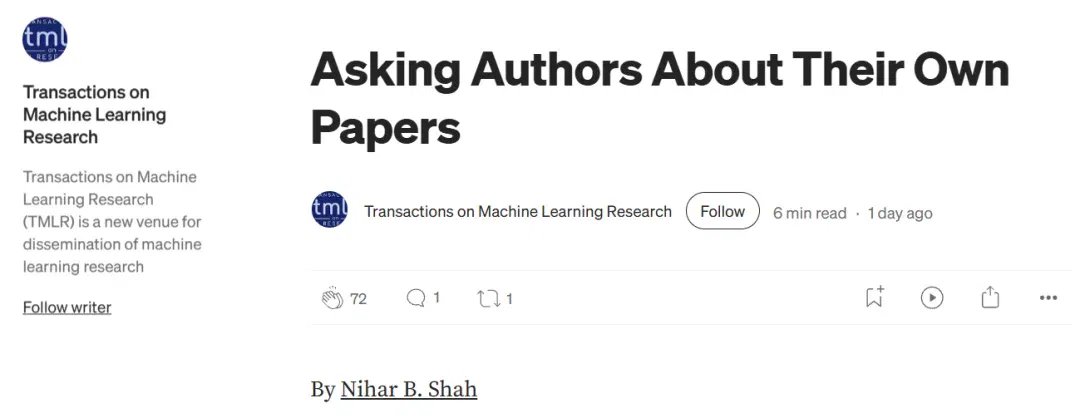
https://medium.com/@TmlrOrg/asking-authors-about-their-own-papers-3d2e04e5dee0
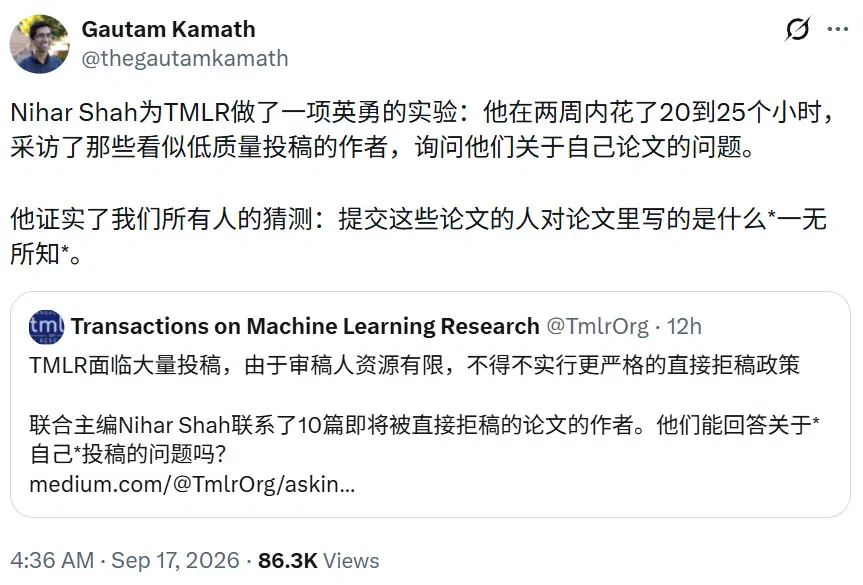
同为 TMLR 主编的 Gautam Kamath 在 𝕏 上转发时称这是一次「英勇的实验」,并说它证实了很多人心里早有的猜测:一部分投稿者其实并不知道自己的论文里写了什么。
抽查 10 篇待拒稿,都拒了
据 Shah 的描述,这次试验发生在 2026 年 8 月 14 日至 28 日他轮值主编期间。他从待直接拒稿的论文中非正式地抽取了 10 篇,通过审稿平台 OpenReview 给作者发去一条简短消息:一位主编希望在送审之前和您聊聊,以便更好地理解这篇论文,如果方便,请发邮件告知可约时间。
消息发出后,事情迅速分化。一篇论文的作者直接撤稿;一位作者回复说手头事情太多,没空通话;剩下 8 篇约上了会,但其中一位作者到点没有出现。
最终与 Shah 见上面的,是 7 篇论文的作者。他们身份各异,包括本科生、硕士生、博士生、高校教师和独立研究者。这批论文大多是单作者论文,但并非全部。
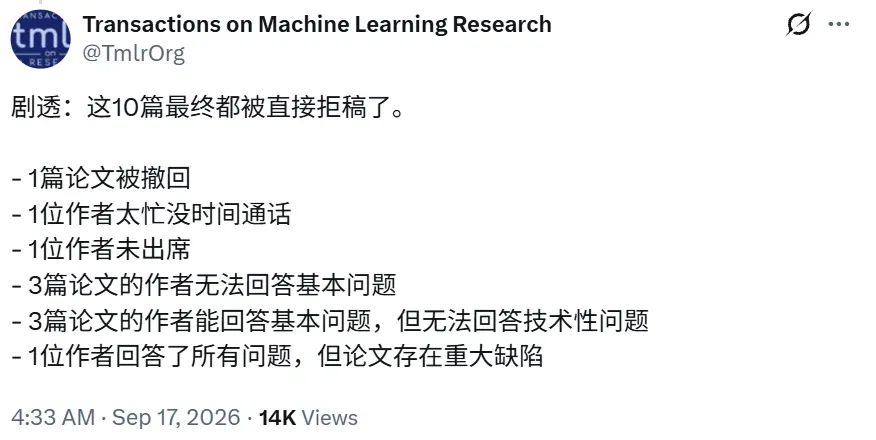
Shah 的提问分两类:一类是关于问题设定、符号和论文所声称结果的基础问题,另一类是关于具体技术表达式、理论结果和实验设计选择的细节问题。
7 场会谈里,只有 1 篇论文的作者答上了全部问题。 另有 3 篇的作者能讲清高层思路,但一被追问技术细节就陷入困难。最糟糕的是另外 3 篇,作者连基础问题都答不上来,而且这 3 篇全是单作者论文。
Shah 写道,其中两位作者看起来对自己论文的内容几乎没有实质理解,另一位则找不到摘要中声称的几项关键结果究竟在正文哪里给出或得到支撑。
唯一全部答对的那篇,也没能过关。Shah 在审读中发现,论文的一项主要结论存在重大错误,作者随后也承认了。TMLR 对这篇作了直接拒稿,但允许作者在修正错误或收窄结论后重新投稿。其余 9 篇则被直接拒稿,且不开放重投。
会后的两个插曲
Shah 在文中还记录了两件事,读来颇具黑色幽默。
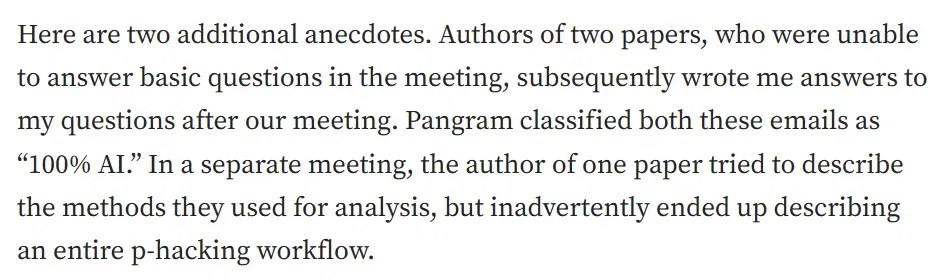
第一件:有两篇论文的作者在会上答不出基础问题,会后却给他发来了书面答复。Shah 把这两封邮件交给 AI 文本检测工具 Pangram,结果均被判定为「100% AI」。
第二件:另一场会谈中,一位作者试图向 Shah 介绍自己用到的分析方法,结果讲着讲着,无意间完整描述了一套 p-hacking 流程,也就是通过反复调整分析方式、直到数据「显著」为止的做法。
需要说明的是,Shah 本人并不排斥 AI。他在文中坦言,为了在两周内读完 8 篇论文,他自己也借助了 LLM 来辅助理解,甚至学习了一些此前不熟悉的概念。他关心的并不是作者有没有用 AI,而是作者能否为署着自己名字的内容负责。
为什么要做这件事?
TMLR 创刊于 2022 年,由 JMLR 背后的团队运营,以「只看结论是否被证据支撑,不以新颖性和 SOTA 作为拒稿理由」的审稿标准著称。它的审稿人、执行编辑(Action Editor)和主编全部是无偿志愿者,这也让它在今年的投稿潮中格外吃力。
根据 TMLR 6 月发布的公告,过去一年里其投稿量增长到原来的三倍,其中单作者投稿更是暴增至 13 倍,编辑部甚至见过有人一天投出 5 篇论文。Shah 在最新文章中给出的另一组数字更直观:2023 年,TMLR 直接拒稿的比例约为 6%,如今已升至约 53%,也就是说超过一半的投稿走不到外审环节。
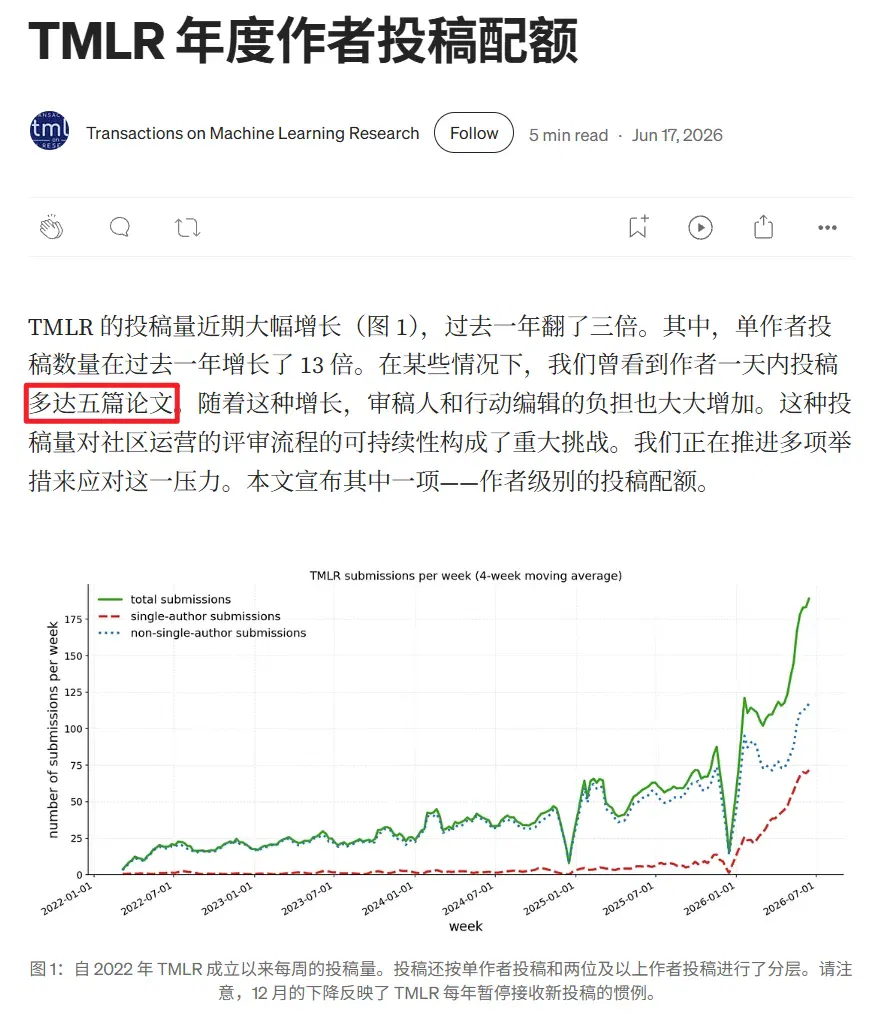
面对这种局面,TMLR 在今年夏天密集推出了一系列措施。
其一是按作者设置年度投稿配额。与许多会议「每人最多 N 篇」的固定上限不同,TMLR 采用了一种「调和式」配额规则,一篇论文消耗每位作者的额度会随合著者人数增加而递减。具体参数是:只投单作者论文的人,每年最多投 2 篇;若所有投稿都是 9 人合著,则每年最多 9 篇;活跃的审稿人和执行编辑额度翻倍。该规则从 7 月 1 日起执行。TMLR 在公告中解释,之所以不按人数平摊,是为了防止有人靠挂名「凑作者」来换取更多投稿额度。
其二是引入 AI 审稿。TMLR 7 月宣布,每篇投稿将在常规人工审稿之外附带一份 AI 生成的审稿意见,只评估论文的「可靠性」,即结论是否有准确、清晰、令人信服的证据支撑,不做主观判断,也不给出录用建议,最终决定仍由执行编辑作出。经过评测,TMLR 选用了 CSPaper 的 AI 审稿器。
其三是把「写得清楚」写进录用标准。8 月 28 日,TMLR 修改了原有的「受众兴趣」标准,明确要求论文要向读者清楚地传达其发现。公告直言,当前的 AI 写作往往绕、术语堆砌、难以读懂;如果一篇论文几乎完全由 AI 生成、缺少人的参与,至少以现有 AI 系统的水平,它很可能达不到这一标准。
Shah 在文章结尾总结,这次约谈让编辑部对现有的直接拒稿流程更有信心,配额制度和对清晰写作的强调也被证明很有帮助。
不只是 TMLR
TMLR 的遭遇并非孤例。今年以来,AI 领域几个重要的发表渠道都在与同一个问题搏斗。
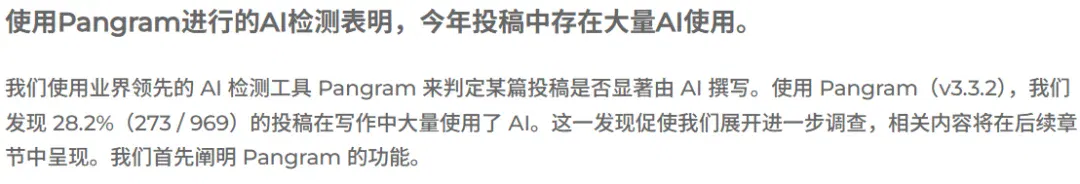
6 月初,NeurIPS 官方博客披露,NeurIPS 2026 立场论文(Position Paper)赛道的 971 篇投稿中,有 273 篇(28.2%)被 Pangram 判为 AI 分数 100%。
https://blog.neurips.cc/2026/06/02/ai-generated-papers-in-the-neurips-2026-position-paper-track/
该赛道今年明确要求论文必须「实质上由人类撰写」,AI 只能用于文字润色等外围修改。NeurIPS 同时指出,AI 写作的增长是全面性的:在「评测与数据集」赛道,Pangram 分数不低于 90% 的论文数从 2025 年到 2026 年增长了十倍以上。不过 NeurIPS 也承认检测结果对参数敏感,改用中等尺寸的检测窗口后,AI 分数在 90% 至 100% 区间的论文比例会从 42.7% 降至 12.7%。
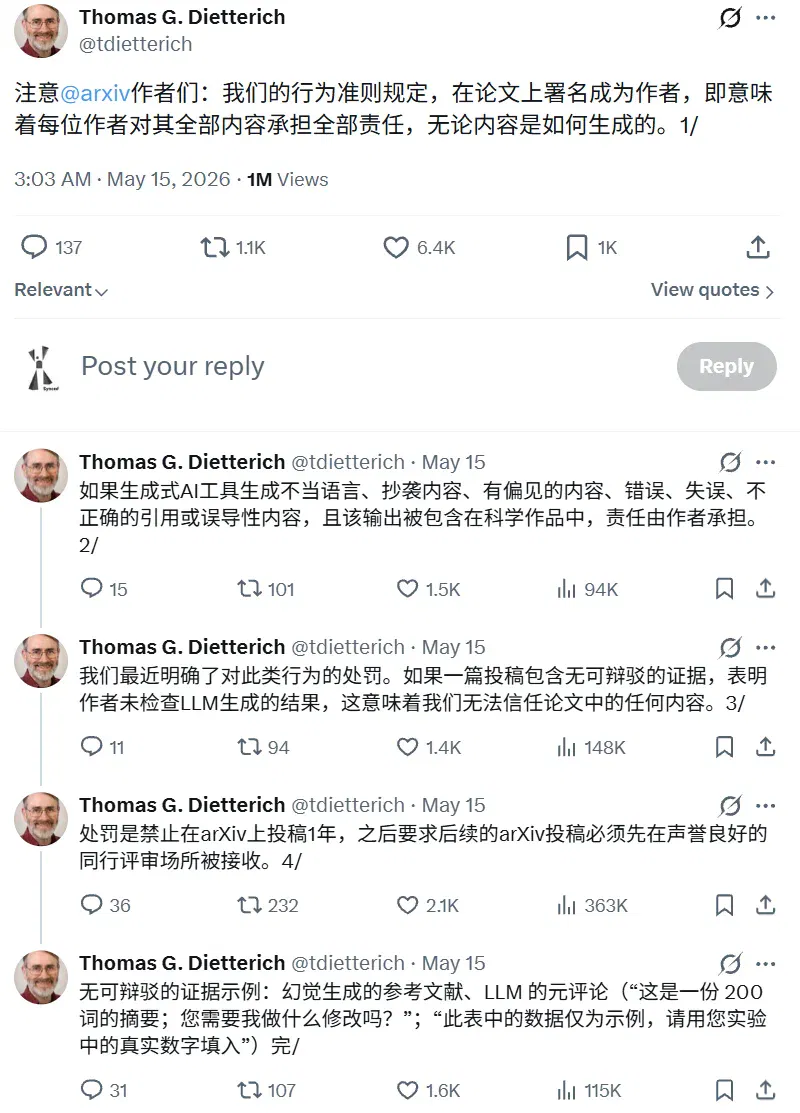
更早的 5 月中旬,arXiv 计算机科学板块负责人 Thomas G. Dietterich 在社交媒体上宣布了一项明确罚则:如果一篇投稿中存在作者未检查大模型输出的「确凿证据」,比如幻觉参考文献、遗留在正文里的聊天机器人对话语句,所有作者将被禁止在 arXiv 投稿一年,此后的投稿必须先被正规同行评审渠道接收才能上架。Dietterich 强调,在论文上署名,就意味着每位作者要对全部内容负责,无论这些内容是怎样生成的。
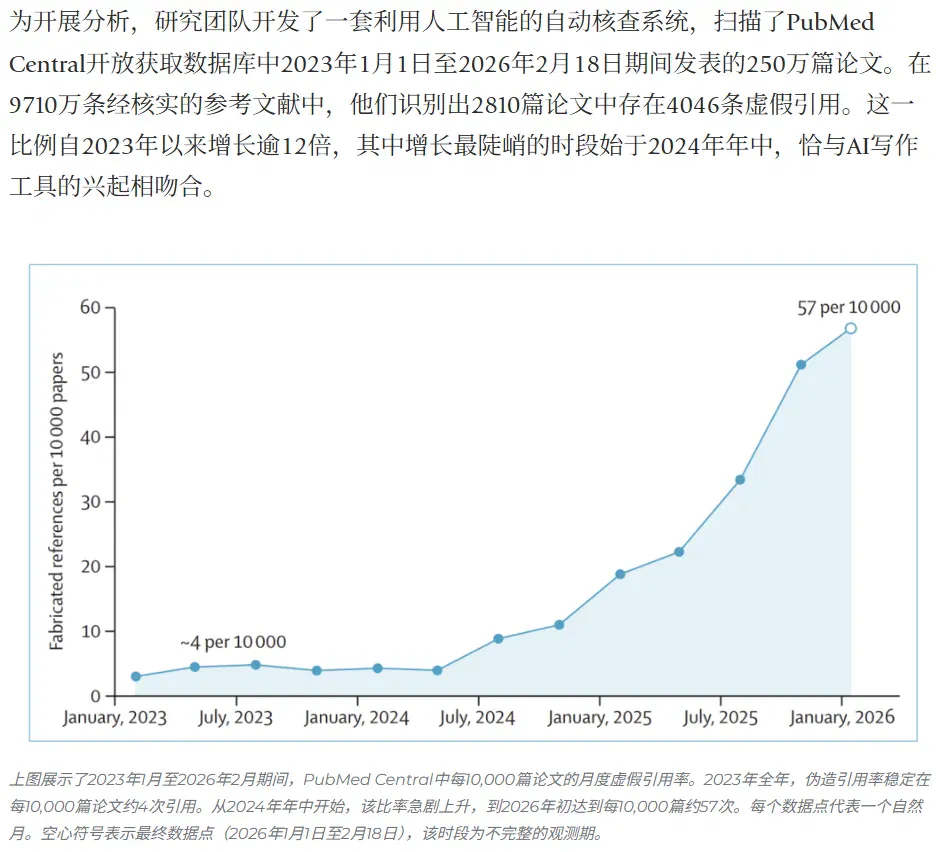
与此相关的数据同样刺眼。据哥伦比亚大学的一项《柳叶刀》研究,在 PubMed Central 收录的生物医学论文中,含有至少一条虚构引用的论文比例,从 2023 年的约万分之 4,升至 2026 年初的约万分之 57。
https://www.nursing.columbia.edu/news/nearly-3-000-peer-reviewed-medical-papers-have-fake-citations-columbia-nursing-ai-assisted-audit-finds
从「查文本」到「查人」
Shah 在文中坦承,这次试验花掉了他 20 到 25 个小时,只处理了 8 篇论文,面对如今的投稿规模,这种做法很难推广。
他同时提到,自己的团队正在研究可规模化的方案。
而就在前几天,Shah 与 CMU 的 Justin Payan、Bálint Gyevnár、Atoosa Kasirzadeh 发布了一篇论文,提出名为greCAPTCHA的评估方法。名字一半取自美国研究生入学考试 GRE,一半取自区分人与机器的 CAPTCHA 验证码。
https://www.cs.cmu.edu/~nihars/preprints/greCAPTCHA.pdf
它的思路是:不再去检测文本是不是 AI 写的,而是直接考作者。作者提交论文和一份个人贡献说明,系统据此自动生成题目,作者在监考条件下作答,最后生成一份评估报告,供期刊、招聘或招生方参考。研究者把要考察的能力称为「核验能力(capacity to verify)」,即作者是否具备批判性评估自己所贡献内容的知识和推理能力。
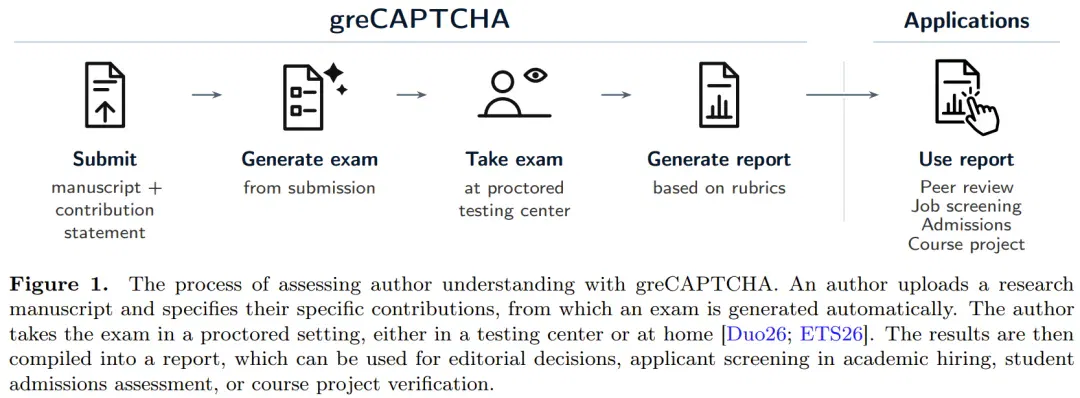
题目分为四类:在多个版本中识别论文真实报告的数据(预置错误识别)、解释论文没有写明理由的设计选择、解释论文默认读者已知的背景概念,以及指出方法在什么具体条件下会失效。
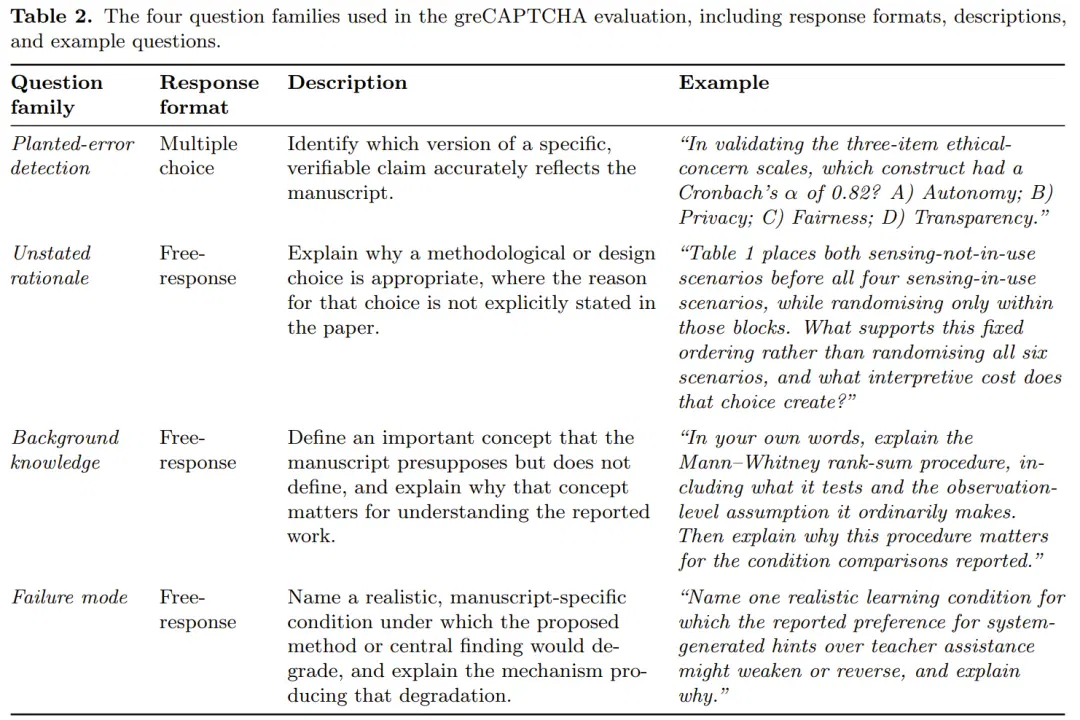
团队招募了 31 名研究者进行测试,每人分别就自己的论文和一篇陌生论文作答。结果显示,系统区分「自己的论文」和「陌生论文」的 AUC 达到 0.90,去掉选择题后升至 0.934。选择题本身几乎没有区分度,AUC 只有 0.595,原因很简单,答案可以直接在 PDF 里搜到。另一个值得注意的结果是,受试者面对本领域和跨领域陌生论文时,得分没有统计学上的显著差异,说明这套题考的不只是领域知识。
一位受试者的经历颇能说明问题:他在测试前把陌生论文丢给 AI,让它从头到尾讲解了一遍,但面对深入问题依然答不上来,陌生论文得分 1.3,自己论文得分 51。
但这套系统远未成熟。论文报告的最低误判率约为 20%,也就是说,每五位真正的作者里可能有一位被误判。受试者对评分的抱怨最多:不清楚该答到多细、评分标准过于死板。一位作者面对否定自己答案的评分标准时脱口而出,那个东西明明是我自己设计的。还有受试者指出,合作论文中有些部分由合著者完成,自己本就答不上来;也有人担心,这类考试会在无形中考察英语表达、打字速度,对非英语母语者和残障研究者不公平。
结语
Shah 在文中列出了几点结论,这两点值得一看:
一是credit 分配。在今天的科研生态里,学术贡献主要通过论文署名来认定。如果作者无法解释、无法捍卫自己的论文,一篇发表作为「研究者贡献」的信号价值就大打折扣。
二是审稿体系的循环。许多期刊和会议会邀请投稿作者去审别人的论文。如果作者连自己的论文都看不懂,他们能否胜任审稿,自然要打上问号。在 AI 审稿、AI 写作同时涌入的当下,这个循环一旦断裂,同行评审的根基就会被掏空。
当然,这次试验本身也有明显的局限。10 篇样本数量很小,是 Shah「非正式」抽取的,而且全部来自原本就要被直接拒稿的论文,它能说明的是「被判定为低质量的投稿里有什么」,而不是 TMLR 投稿的整体面貌。这一点 Shah 自己也写了:试验的目的之一,正是检验直接拒稿流程是否靠谱。
但 Shah 的这次试验至少给出了一个底线:一篇论文可以由 AI 帮忙完成,但署名的人必须能说清楚里面写了什么。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
堪比Transformer奠基论文?这篇研究让AI圈吵起来了 (opens in a new tab)
这篇文章彻底颠覆了人工智能领域的认知,引发了广泛的猜测,Sam Altman 还公开表达了赞赏。
三分之一arXiv沦陷!CS论文65%被判「AI味」,数学仅0.7% (opens in a new tab)
三分之一的arXiv论文,竟然是AI写的?
刚刚,DeepMind经典巨作再封神!ICML 2026大奖公布 (opens in a new tab)
ICML 2026大奖公布来了!ICML年度杰出论文奖和时间检验奖,正式公布。其中杰出论文共有9篇入围,含7篇研究论文及2篇立场论文,最终优胜奖3名和荣誉提名6名;ICML时间检验奖花落强化学习领域,DeepMind经典巨作再封神。
两名本科生,半年5个顶会!CVPR斩获最佳学生论文提名 (opens in a new tab)
CVPR 2026全部奖项揭晓!最佳学生论文荣誉提名颁给了ChordEdit,一作和通讯都是广东工业大学本科在读生。他们用一块7年半前的老Titan,跑完了全部实验。
NeurIPS用AI检测,说我的论文是AI生成的 (opens in a new tab)
NeurIPS 2026 正在用 AI 检测器来判定「论文投稿是否使用 AI」,并作为拒稿的重要依据。