刚刚,小米刷新 AI 大模型斩杀线,罗福莉:技术难度超过 DeepSeek R1
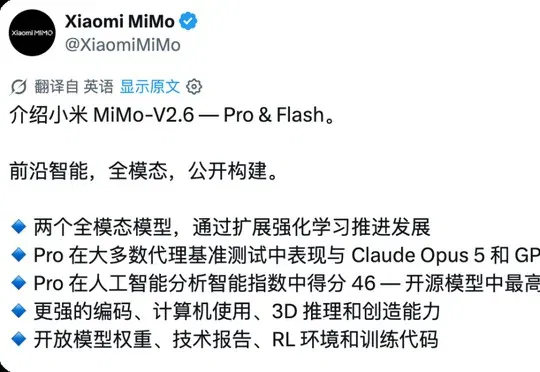
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
就在刚刚,小米正式发布并开源 MiMo-V2.6 系列模型。
此次发布包含两款原生全模态模型。MiMo-V2.6-Pro 面向复杂编程、Agent 和专业任务,MiMo-V2.6-Flash 更强调性能、效率与成本之间的平衡。
小米还同步推出 MiMo-V2.6-Pro-UltraSpeed,官方称其在保持模型质量的前提下,输出速度最高可达到 Pro 版本的 20 倍。
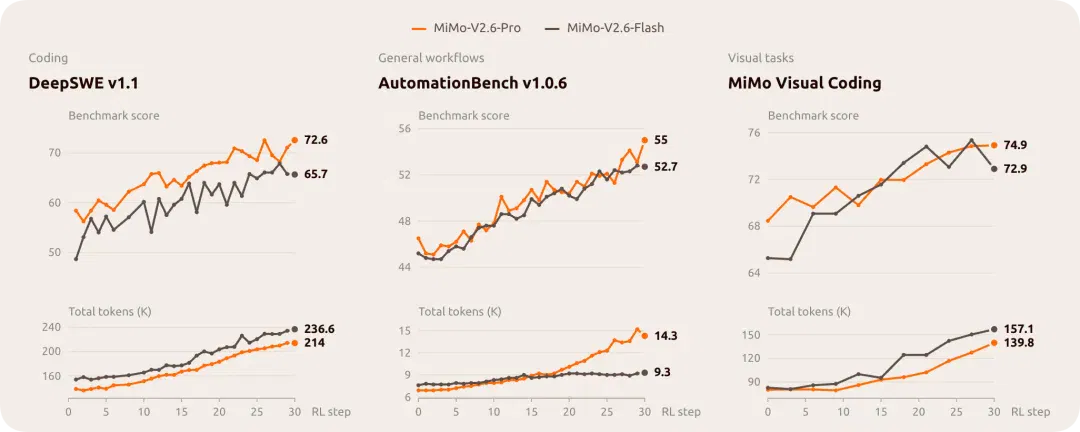
而除了版本更新,APPSO 之前也报道过,小米把一场持续近六天、合计花费约 347 万美元的强化学习训练公开到了网上。
从训练进度、成本变化到任务通过率,外界可以近乎实时地观察两个模型如何在 30 个 RL step 中逐渐提升能力。小米将它视为探索 RSI,也就是递归自我改进路线的一次重要尝试。
MiMo V2.6 登场,国产开源模型迎来新标杆
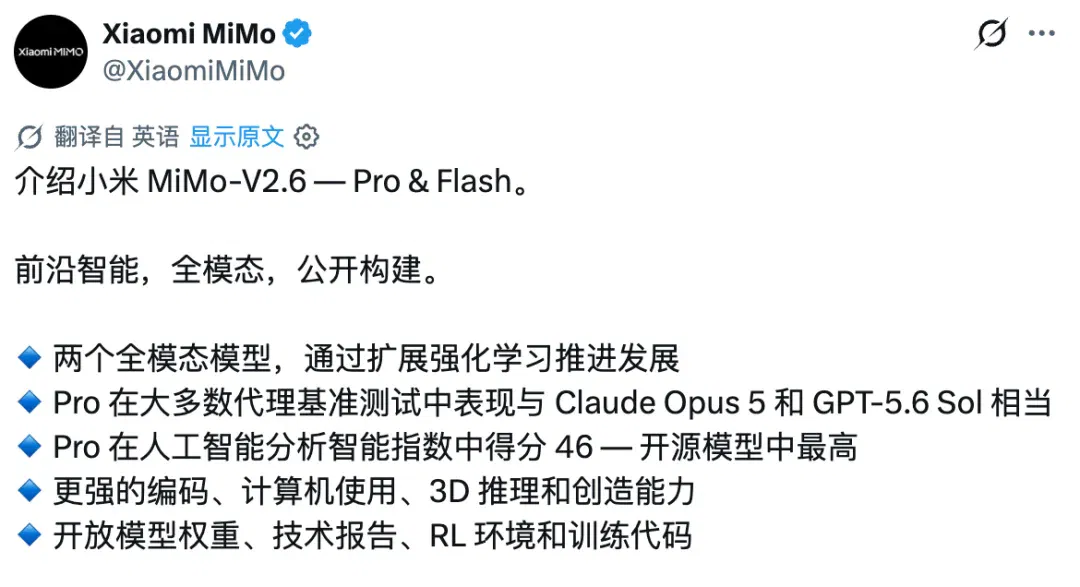
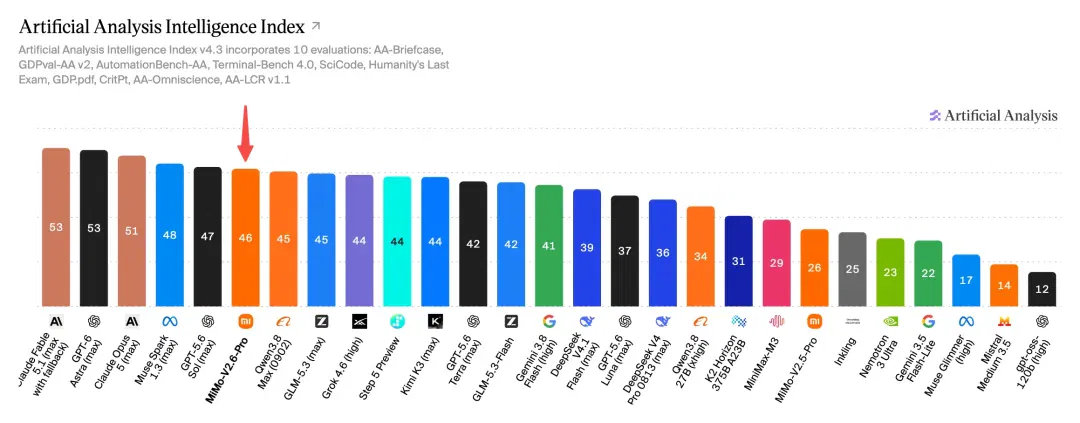
官方公布的结果显示,MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index v4.3 中获得 46.32 分,超过 Kimi K3 和 Qwen3.8 Max。
小米据此称其为当前该榜单得分最高的开源模型,同时表示 V2.6 沿用了 V2.5 的 API 价格,希望用相同成本提供更高的智能水平。
具体到各项基准测试成绩,Pro 在 DeepSWE v1.1 中获得 71.9 分,接近 DeepSeek V4.1 Flash 的 74.2、Claude Opus 5 与 GPT 6 Astra 的 74.0;在 Toolathlon-verified 中获得 76.9 分,高于 GPT 5.6 Sol 的 74.9;
在 Automation Bench v1.0.6 中获得 53.1 分,略低于 DeepSeek V4.1 Flash 的 54.8,高于 GPT 6 Astra 的 52.0;面向真实职业任务的 JobBench 得分为 62.0,仅次于 Claude Opus 5 的 65.7。
网页与可视化界面生成,也是此次更新的重点。
在小米自建的 MiMo Visual Coding 评测中,Pro 和 Flash 分别获得 72.3 分和 71.5 分,高于 DeepSeek V4.1 Flash 和 Claude Opus 5,但与 GPT 6 Astra 的 82.2 分仍有差距。
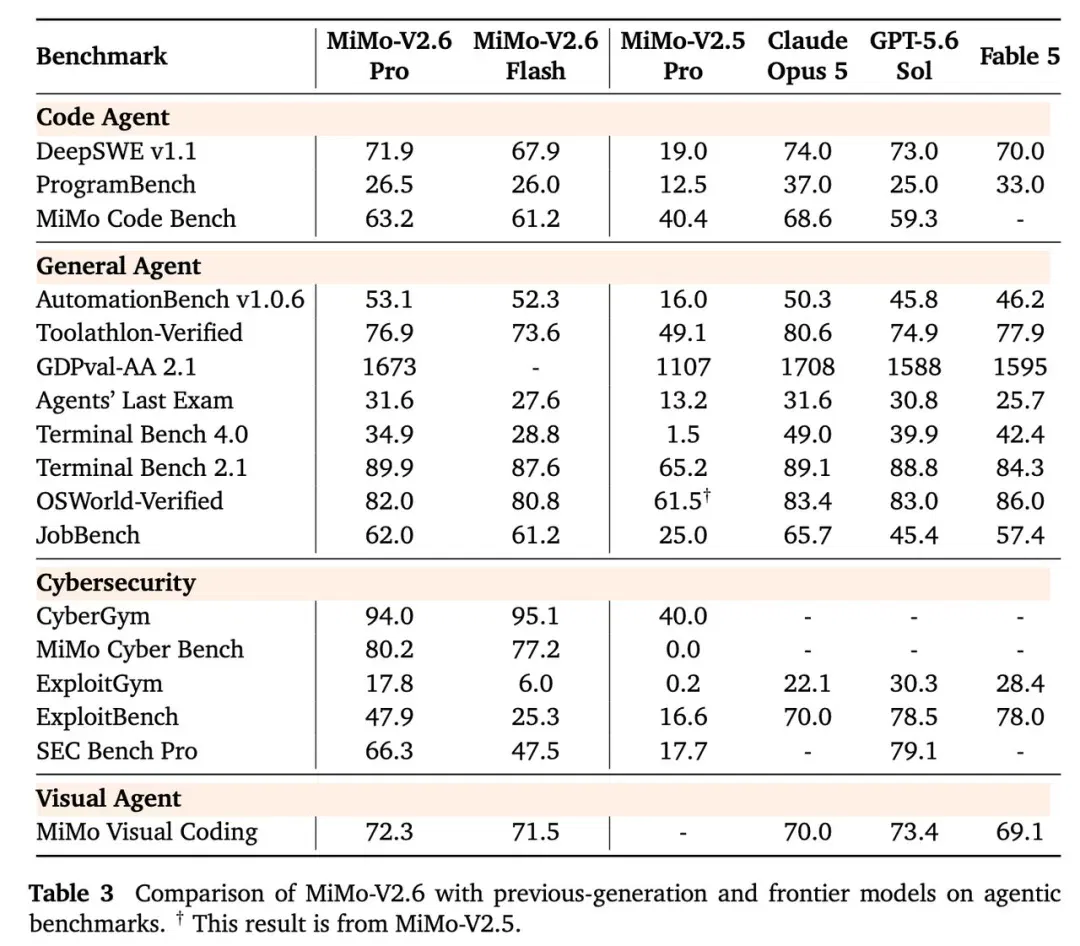
当然,整体来看,MiMo-V2.6 尚未在所有能力上追平闭源前沿模型。
Pro 在 Terminal Bench 4.0 中获得 34.9 分,与 GPT 6 Astra 的 59.6、Claude Fable 5.1 的 55.1 仍有明显差距,在多项网络安全评测中也整体落后于头部闭源模型。
不过,对开源模型而言,46.32 分的综合成绩与便宜大碗的 API 价格放在一起,可能比个别榜单上的名次更有现实意义。
六天烧掉 347 万美元,小米豪赌 RL
MiMo-V2.6 背后的训练过程,可能比最终分数更能说明小米想做什么。
APPSO 也第一时间查阅了 MiMo-V2.6 的技术报告:MiMo-V2.6-Flash 和 Pro 分别完成 30 个强化学习 step,各自产生约 75 万条训练轨迹,成本分别约为 85 万美元和 262 万美元。
两个模型的平均任务通过率相对提升约 25% 和 12%,在没有参与训练的长程软件工程评测 DeepSWE v1.1 上,Flash 从 48.8 分提高到 65.68 分,Pro 从 58.4 分提高到 72.57 分。
多个项目在训练后半程仍保持增长。小米据此判断,大规模 RL 仍有较高的样本效率,而且收益能够扩展到训练分布之外,模型学到了一定的通用长程执行能力。
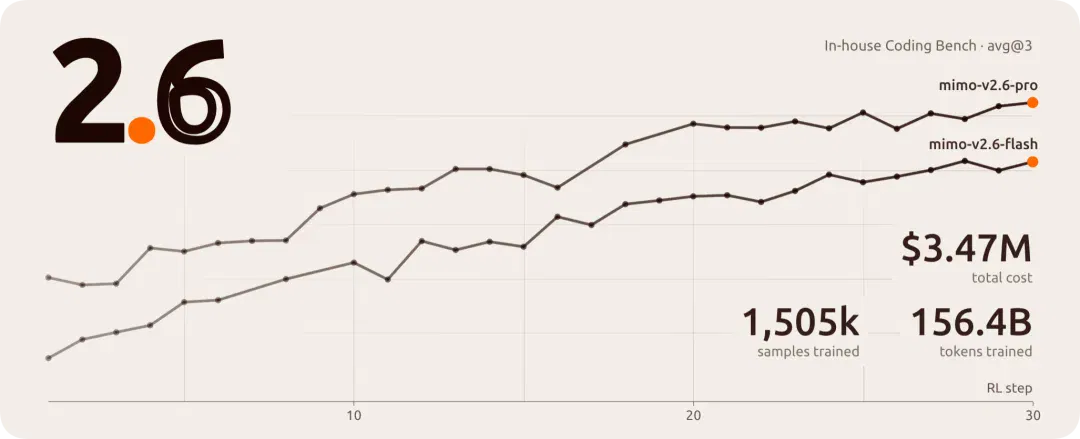
训练规模也远超常见的后训练实验。
每个 step 包含 1568 个 prompt,每个 prompt 同时生成 16 条候选轨迹,相当于一次处理约 2.5 万条长序列和 27 亿至 37 亿训练 token,最长上下文达到 100 万 token。
任务覆盖编程、通用 Agent、视觉和网络安全,并混合多个运行环境;评分系统则对同一问题下的多条轨迹进行比较,为长链路任务提供更细致的奖励信号,引导模型减少无效步骤和 token 消耗。
大规模 RL 也容易出现训练漂移和奖励投机。
模型可能寻找评分规则的漏洞,表面拿到高分,实际没有完成任务。小米在训练期间固定 MoE 路由器,并通过奖励设计、对抗评测、异常检测和多个验证器交叉核验提高稳定性,同时统一不同 Agent 框架产生的轨迹格式,让多类任务进入同一套训练系统。
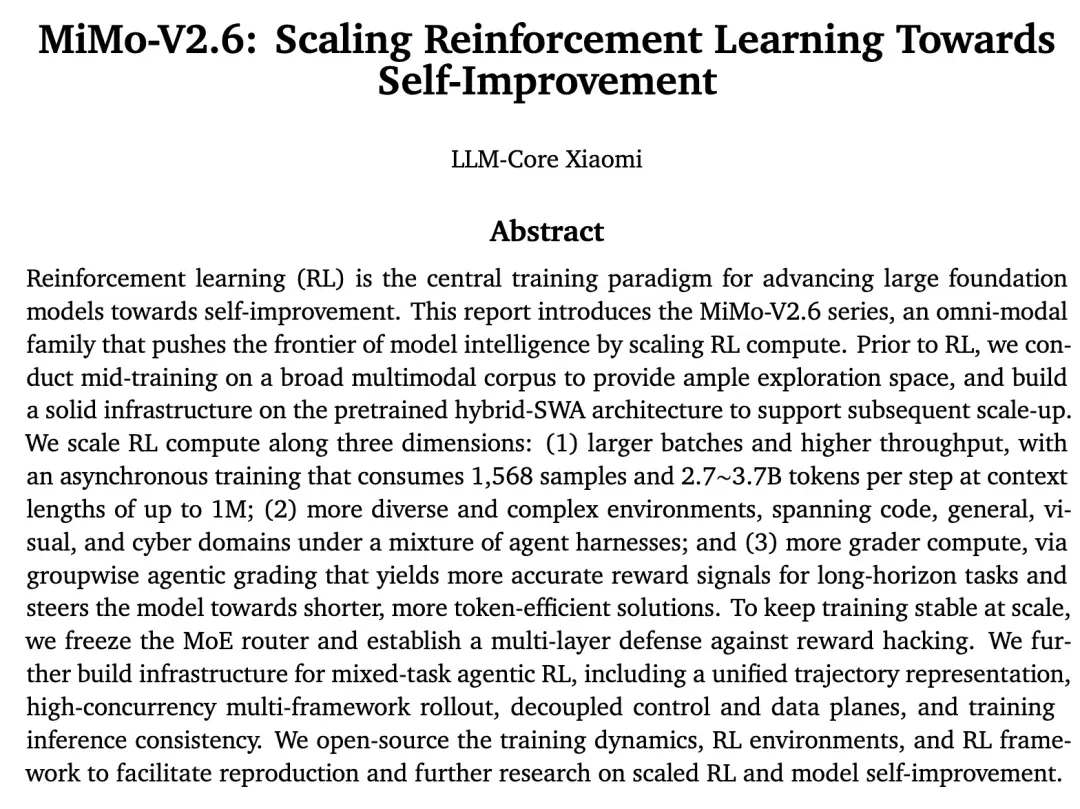
技术报告 🔗
https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL/blob/main/MiMo_V2_6_technical_report.pdf
罗福莉在发布后将 MiMo-V2.6 称为「扩展 RL 的艰难之路」。
她表示,按照算力投入衡量,它很可能是开源模型团队迄今规模最大的单次强化学习训练之一。在算力稀缺的情况下,小米仍让一支数十人的团队长期围绕同一个目标工作,先通过中期训练积累模型潜力,再用大规模 RL 将其释放出来。
在罗福莉看来,MiMo-V2.6 背后的研究创新和工程难度,甚至超过她曾部分参与的 DeepSeek R1。她也解释了 MixRL 与 MOPD 的分工。
代码等难度适中、能够可靠验证的 Agent 任务进入 MixRL,以获得可以跨任务迁移的能力;游戏、3D、超长链路和评价标准偏主观的任务分别训练,再通过 MOPD 合并回主模型,避免拖慢 rollout 或造成数据过期。
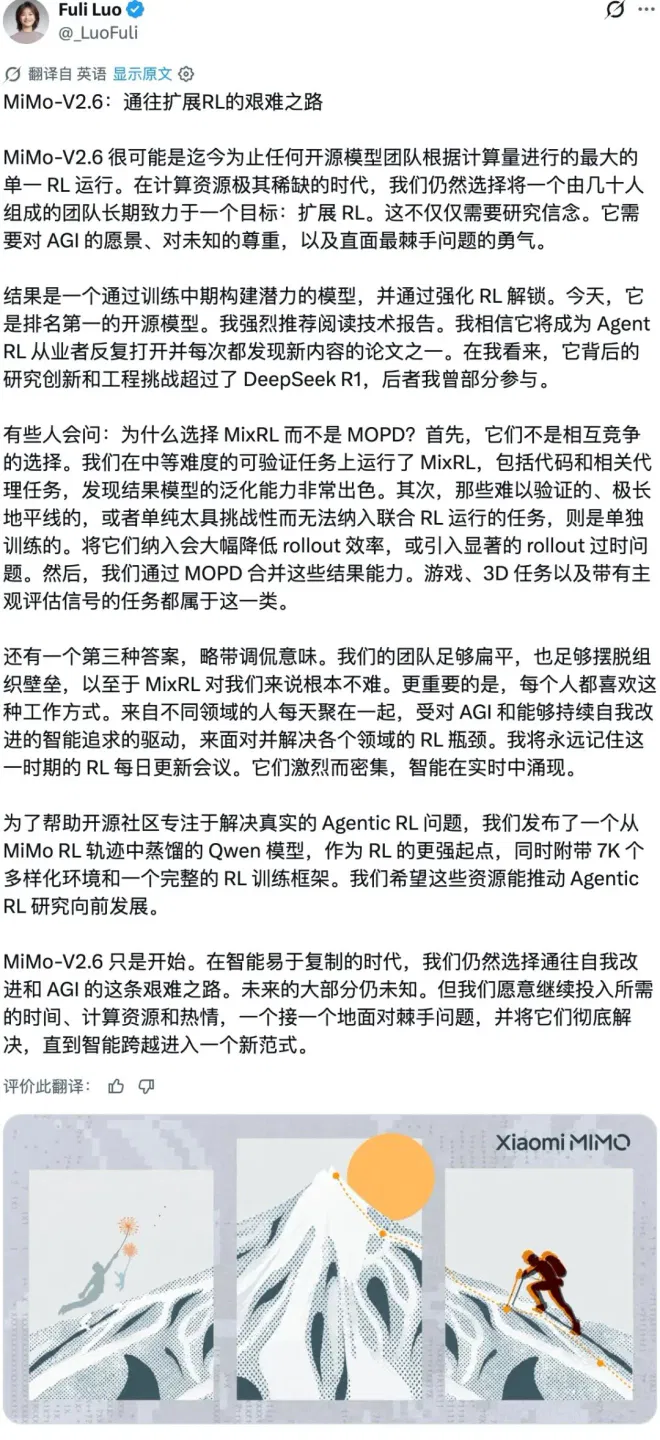
罗福莉认为,扁平的团队结构也降低了 MixRL 的组织成本,不同领域的成员可以围绕同一个模型共同解决 RL 障碍。
小米此次开放的也不只有模型权重。
MiMo-V2.6 的训练曲线、奖励机制、任务配比、关键参数和成本构成均被写进技术报告,外界可以据此观察两个模型在 30 个 RL step 中如何变化,并尝试复现这套大规模 Agentic RL 方法。
为了让算力和预算有限的研究者也能参与,小米还发布了由 Qwen3.5-9B 蒸馏而来的 MiMo-V2.6-Distill-Qwen-9B,以及约 7000 个覆盖代码、网络安全、知识工作和视觉开发的 RL 任务环境。与之配套的验证器、端到端 RL 训练框架和 mini-harness 也一并开放。
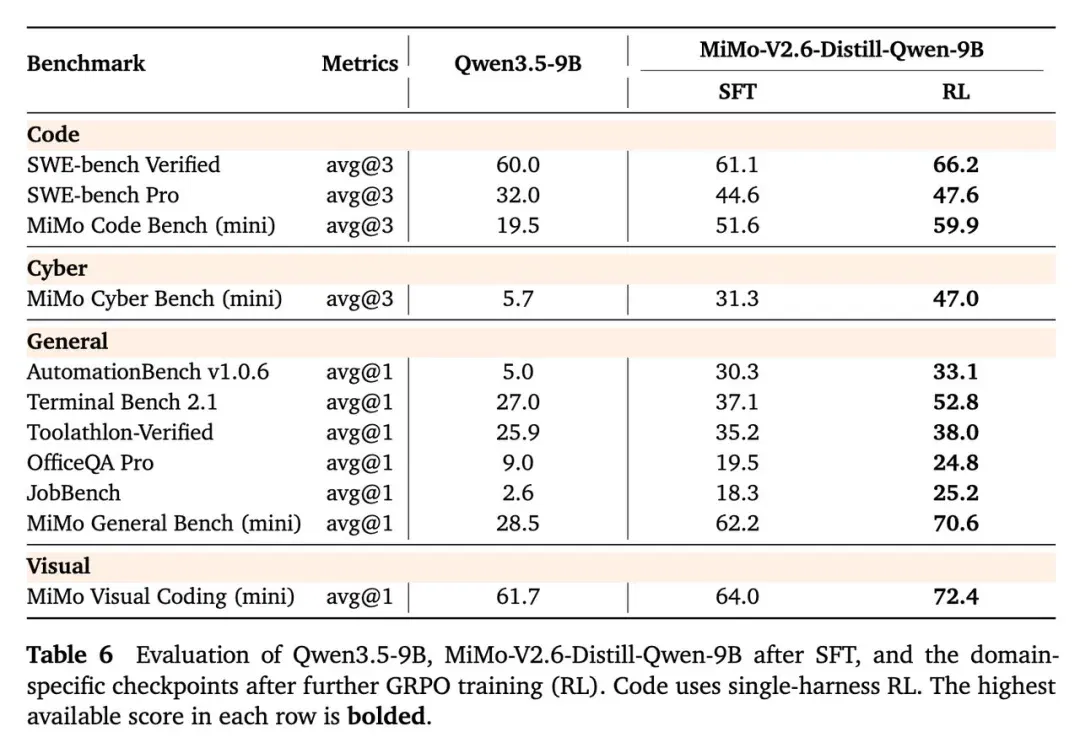
小米贡献给开源社区的,因而不只是一个训练完成的模型,还包括模型如何获得这些能力的过程与工具。如此慷慨,他真的,我哭死。
Vibe Coding 的尽头,是 Vibe World
小米把 MiMo-V2.6 从自然语言编程延伸到可以交互的数字世界,并将其称为 Vibe World。
模型能够依据文字、图片或视频拆分任务,协调多个 Agent 搭建 3D 场景、编写交互逻辑,再通过渲染结果反复修改。
在游戏与 3D 任务中,MiMo-V2.6 可以生成互动场景,并操作 Blender 制作可用于动画、3D 打印和游戏开发的资产;
在具身仿真中,它能够读取多视角画面,控制 Franka Panda 机械臂完成抓取、颜色匹配和精确摆放。
设计与内容生产方面,模型可以从一句需求生成网页或幻灯片,调用 Figma、图片和视频生成工具补充素材,并继续完成镜头组织、动画、配乐和旁白;
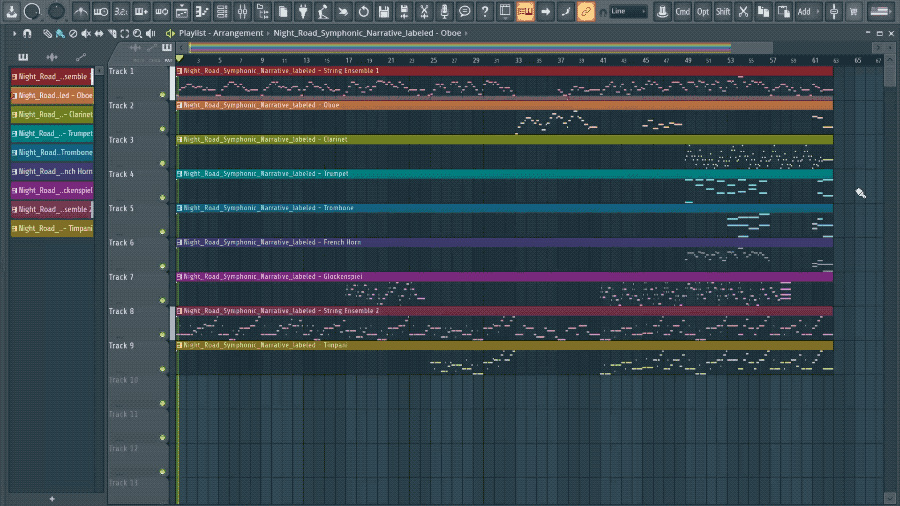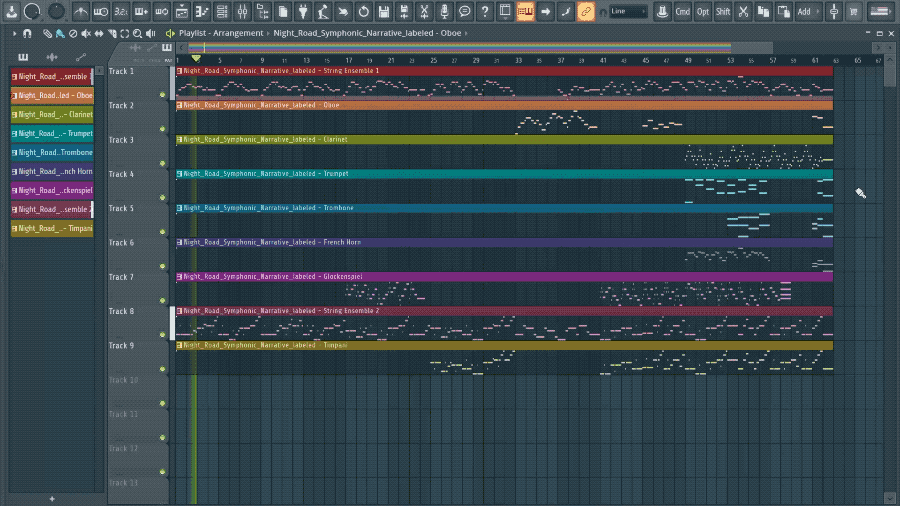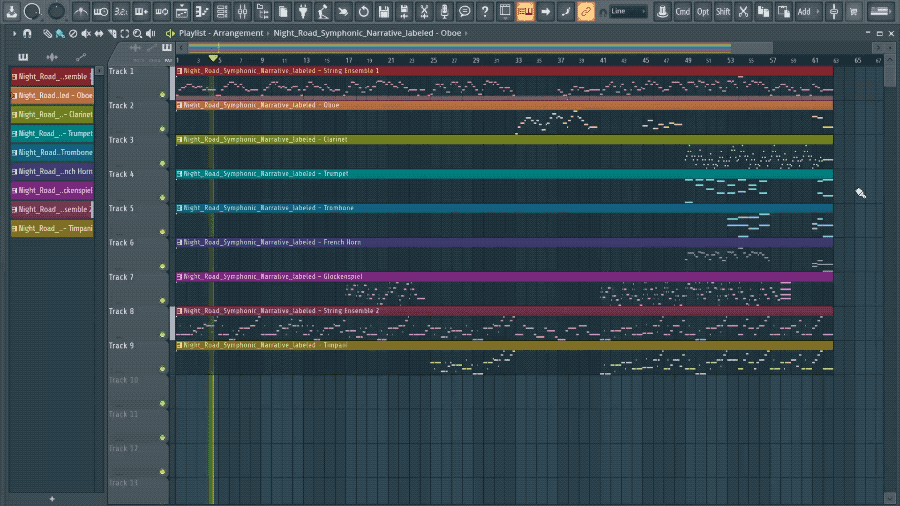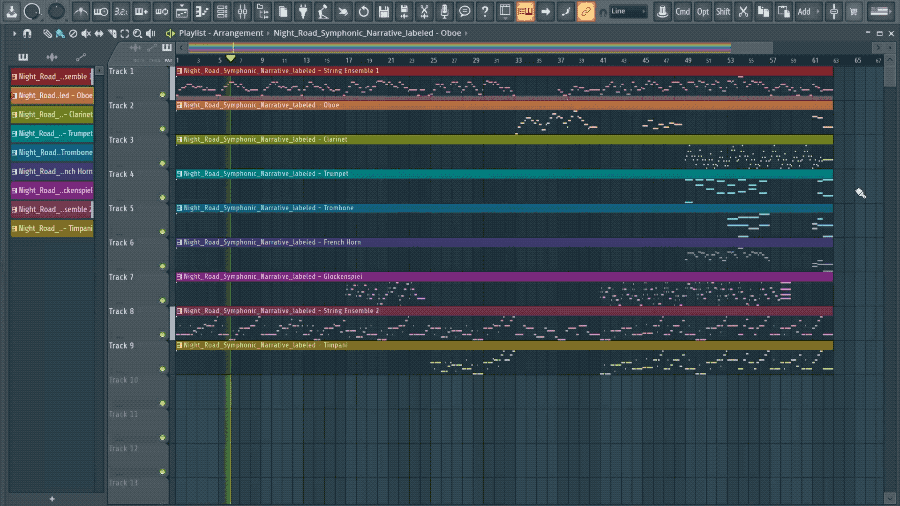
音乐案例中,它为约十种乐器创作管弦乐,生成乐谱并转换成 MIDI。
MiMo-V2.6 还展示了两个科研案例,并强调模型没有接受过专门面向科研任务的强化学习训练。
MiMo-V2.6-Pro 在材料专家指导下完成 PFAS 吸附材料的检索、假设、模拟与候选筛选,还协助研究人员用 Lean 4 完成《周期三蕴含混沌》主要定理的形式化,最终项目超过 6000 行代码并通过内核验证。
从搭建游戏场景到协助科研,MiMo-V2.6 展示了处理复杂任务的潜力。
不过,要让这些能力走出案例演示、进入日常工作,开发者还需要考虑两个现实问题,模型是否方便调用,以及长时间使用的成本能否承受。
MiMo-V2.6-Pro 和 MiMo-V2.6-Flash 目前已经登陆小米 AI Studio、MiMo Code、MiMo Desktop、MiMo API 平台及 OpenRouter,MiMo Desktop 也结束早期测试,迎来首个正式版本。
模型能力之外,小米此次更具进攻性的筹码依然是价格。
Flash 的缓存命中输入、普通输入和输出价格,分别为每百万 token 0.02 元、1 元和 2 元;Pro 则分别为 0.025 元、3 元和 6 元。
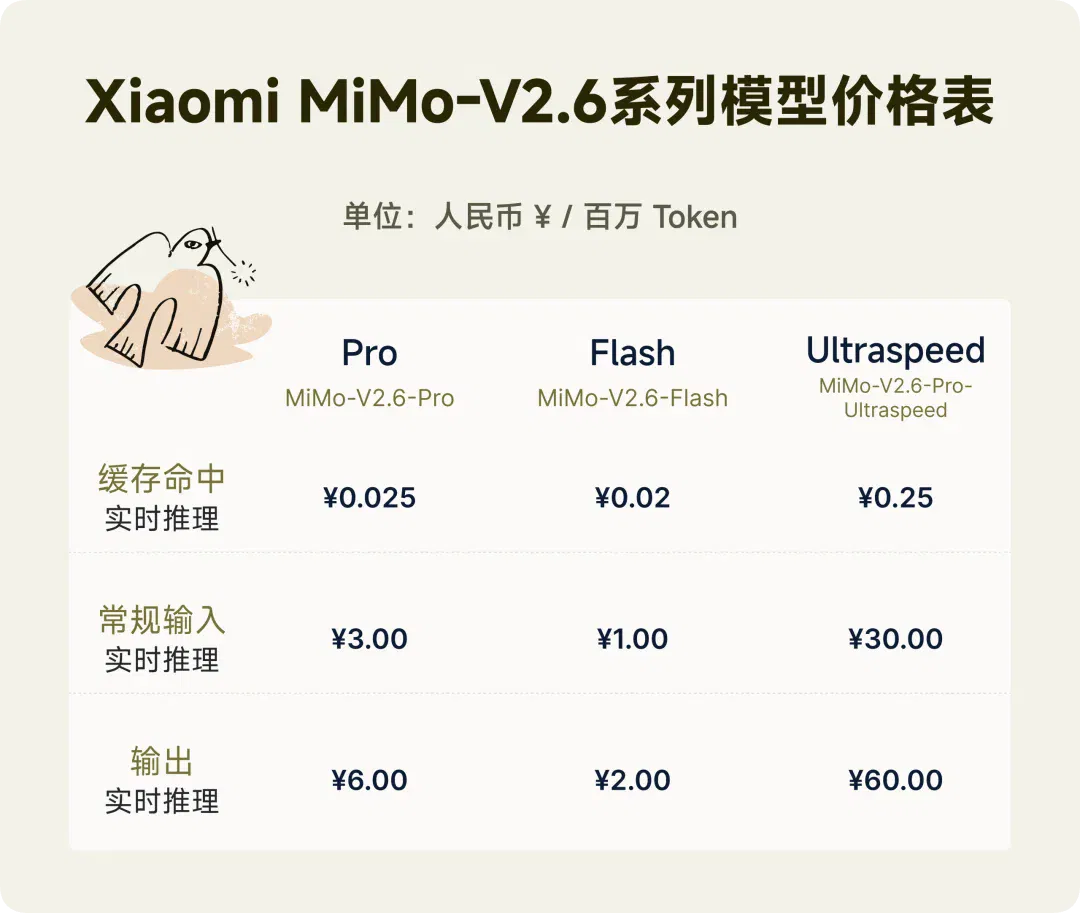
追求响应速度的开发者还可以选择 Pro-UltraSpeed,其三项价格分别为每百万 token 0.25 元、30 元和 60 元,相当于用普通 Pro 十倍的调用成本,换取最高 20 倍的输出速度。
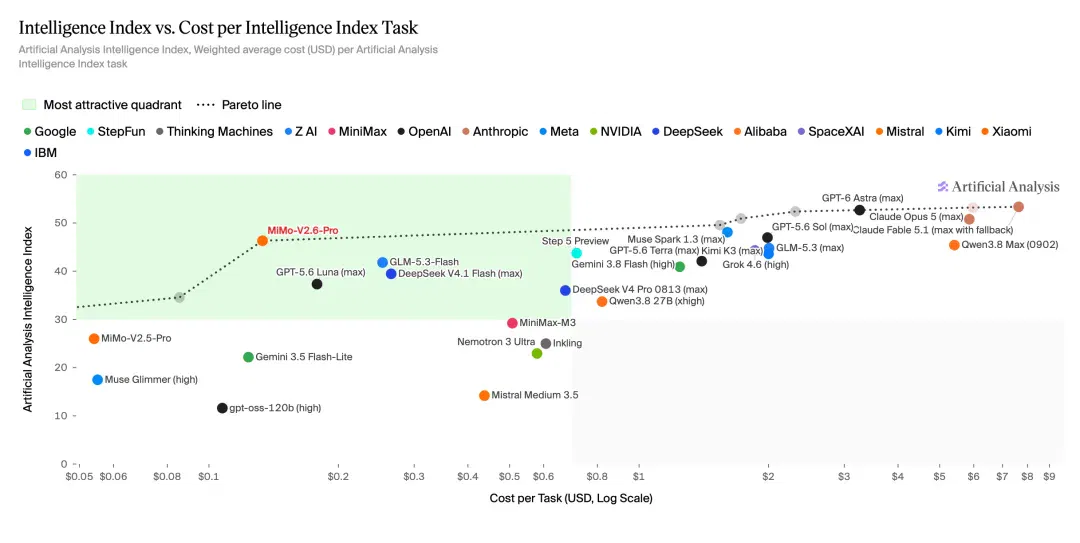
开发者需要处理海量 token、运行长链路 Agent 或大规模部署模型时,调用成本会随着任务规模迅速累积。
在同等智能水平下,MiMo-V2.6 系列的价格仅为海外模型的 1/20 至 1/60。
当国产模型逐渐追上前沿能力,又把价格压到同级海外模型的几十分之一,竞争的压力便转向了价格更高的一方,它们需要证明多出来的溢价究竟能换来什么。
从这个意义上说,
MiMo-V2.6 正在成为 AI 模型市场新的斩杀线,能力低于它的产品越来越难被选择,价格高于它的产品则需要给出更充分的理由。
文章来自于微信公众号 “APPSO”,作者 “APPSO”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
小米展示人形机器人在汽车工厂和公寓的作业测试 (opens in a new tab)
小米公开两组演示:汽车工厂两台机器人参与一个班次的盖板排序,公寓试验则让机器人连续完成多项整理任务。报道介绍了工位调度、异常恢复与真实场景数据回流。
小米开源 Xiaomi-OCR-0,以 0.8B 参数整合文档解析与信息抽取 (opens in a new tab)
小米发布并开源0.8B文档理解模型Xiaomi-OCR-0,融合文档解析、关键信息抽取与视觉问答,在OmniDocBench v1.6获96.83分并位列1B以下第一,相关技术正用于小米手机“超级小爱”的识屏办事场景。
罗福莉带小米登顶全球开源榜首!大规模RL立功,斩杀Grok 4.7 (opens in a new tab)
大模型江湖变天了。 9月21日,小米MiMo团队正式发布并全面开源新一代MiMo V2.6系列,一口气端出三款模型——Pro、Flash、Ultraspeed,直接改写全球开源模型的格局。 MiMo V2.6 Pro在Artificial Analysis智能指数(AA Intelligence Index v4.3)中拿下 46 分,超过Kimi K3和Qwen3.8 Max。 全球开源模型第一、国产模型第一! 拉出AA榜单横着看:Fable 5.1得分53,GPT-6 Astra得分52.8,Opus 5得分50.7。 MiMo V2.6 Pro虽然还没追平这几位「天花板」,但已经稳稳站进
罗福莉剧透小米MiMo v3架构:模型还没影,论文全说了 (opens in a new tab)
MiMo-V2.6刚发布,罗福莉就开始剧透MiMo-V3了。
罗福莉沉寂半年官宣小米强化学习!直播新模型训练过程,一小时烧3万美元 (opens in a new tab)
什么情况?小米新模型的强化学习训练,直接开了现场直播。